HOME/ビジネス/AIソリューション/LoRA(ファインチューニング)
LoRA / SLM FINE-TUNING

LoRA(ファインチューニング)
業務に特化した小型AIを調整し端末まで実装する支援

LoRAは、AIの本体を変えずに小さな追加部品だけを学習して、業務に合わせる調整手法です。当社は、PhiなどのSLMをLoRA/QLoRAで調整し、軽量化して端末へ実装するまでを、評価と運用を含めて支援します。

01/概要

LoRAとは:AIの本体は変えず、小さな追加部品だけを学習して、業務に合わせる調整手法

LoRA(ローラ、Low-Rank Adaptation=低ランク適応)とは、すでに学習済みのAIモデルの本体(重み)を固定したまま、小さな追加部品(アダプタ)だけを学習させて、自社の業務に合わせるファインチューニングの手法です。モデル全体を学び直す場合に比べて、必要なGPU(AIの計算に使う半導体)メモリと学習時間を大きく抑えられます。

QLoRA(キューローラ)はLoRAに量子化を組み合わせた方法です。本体を軽くした状態でアダプタを学習するため、さらに少ないメモリで調整できます。

はじめに、この記事で使う4つの言葉を整理します。

重み

AIが学習で身につけた知識を数値で表したもの。AIの「頭脳」にあたります。

ファインチューニング(追加学習)

できあがったAIに、自社の文書や回答例を追加で学習させ、業務に合わせて調整すること。

アダプタ

LoRAで学習する、小さな追加部品。本体に取り付けて使い、取り外して別のものに差し替えられます。

量子化(軽量化)

AIの数値を粗い桁数で表し、容量とメモリを小さくすること。タブレットなど小さな端末で動かすために使います。

次の図はモデル全体を学び直す方法とLoRAを、「何を学習するか」で比べたものです。LoRAでは、学習するのは小さなアダプタだけです。

調整のしかたを比べる:学習するのはどこか
モデル全体を学び直す(フルファインチューニング)
モデル本体:すべての重みを更新
大きなGPUメモリと時間が必要。調整のたびにモデル全体を保存する
LoRA:小さな追加部品だけを学習
モデル本体:固定(学習しない)アダプタ:ここだけ学習して取り付ける
少ないメモリと時間で調整できる。アダプタだけを保存・差し替えできる

LoRAを使うメリット

少ない設備と時間で調整できる

学習するのは小さなアダプタだけなので、モデル全体を学び直すより、GPUメモリと学習時間を抑えられます。

業務の書き方・言い回しをそろえられる

報告書の書式、社内用語、判定の基準といった「業務のくせ」を、回答例から学習させられます。

本体を残したまま、部品を差し替えられる

元のモデルは変えずに、業務ごと・拠点ごとにアダプタを用意して使い分けられます。

端末で動く小型モデルと相性がよい

SLMにLoRA/QLoRAで調整し、量子化して端末に載せる流れで、データを外に出さない業務AIをつくれます。

当社はこのLoRAを「調整して終わり」にせず、評価・軽量化・端末への実装・運用までつなげて支援します。

02/注目される背景

AIが大きくなるほど、「全体を学び直す」調整が現実的でなくなった

会議室でノートPCを見ながら話し合う社員たち
写真はイメージです

生成AIを業務に使う企業が増えるなか、汎用のAIにそのまま質問するだけでは、自社の書式や専門用語、判断の基準に合った回答が得られない場面が出てきました。そこで、自社のデータでAIを追加学習する要望が高まっています。

一方で、AIモデルが大きくなるほど、全体を学び直すのに必要な計算資源は膨らみます。この課題に対する方法として、2021年にMicrosoftの研究者らがLoRAの論文を発表しました。論文は、学習する数値(パラメータ)の数を大幅に減らしても調整ができるとして、GPT-3 175Bを全体調整する場合と比べ、学習するパラメータを1万分の1、GPUメモリを3分の1に抑えられると述べています。

2023年には、本体の数値を4ビットという粗い桁数に量子化したまま調整するQLoRAが論文で公表され、650億パラメータのモデルを48GBのGPU1枚で調整できるとされました。大きなモデルの調整が、より身近な設備で試せるようになった流れです。

こうした手法は、実際のサービスにも取り入れられています。Microsoftのドキュメントには、Microsoft Foundryのファインチューニングが、LoRAの考え方で学習を軽くする方法を使うと書かれています。また、LoRAの解説では、アダプタを後から取り込んで、回答の生成に使えることも説明されています。

さらに、PhiのようなSLM(小規模言語モデル)が端末で動く時代になり、「小さなモデルを自社の業務向けに調整して、端末に載せる」という使い方が現実的になっています。LoRAはその調整を軽くする手段として注目されています。

出典:Hu et al.「LoRA: Low-Rank Adaptation of Large Language Models」(2021年6月)、Dettmers et al.「QLoRA: Efficient Finetuning of Quantized LLMs」(2023年5月)、Microsoft Learn「Customize a model with fine-tuning」「Concepts - Fine-tuning language models」。数値は各論文の要旨に基づく、著者側の報告です。

03/仕組み

データを整え、アダプタを学習し、軽量化して端末に届ける4つの工程

青い光に照らされた電子基板の拡大
写真はイメージです

LoRAの調整はモデルを用意するだけでは終わりません。業務で使える品質にするには、学習データの整備から、端末での評価までを一続きで設計します。次の図はその流れを4つの工程で示したものです。

LoRAによる業務特化モデルの作り方:データから端末まで
1
学習データを用意する業務の入力と、望ましい回答の組を集めて、学習用の形式(JSONLなど)に整えます。件数よりも、回答の質とばらつきの少なさが効きます。
回答例の整理データの匿名化
2
アダプタを学習する(LoRA/QLoRA)元のモデルは固定し、小さなアダプタだけを学習します。更新する層や学習率を調整し、業務に合う設定を探します。
Phiなどの小型モデルMicrosoft OliveAzure VM
3
本体と結合し、軽量化するアダプタを本体と結合し、量子化で容量を小さくして、端末で動く形式(ONNXなど)に変換します。
量子化ONNX Runtime
4
端末・エッジへ配信し、評価する実際の端末で動かして、回答の質と速度を業務の基準で確かめます。基準に届かなければ、データや設定に戻って回します。
Azure IoT EdgeDirectML/CUDA端末での評価

調整の質を左右する、3つの見どころ

同じLoRAでも、設定の選び方で回答が変わります。当社が検証で扱ってきた、代表的な見どころを挙げます。

どの部分を学習するか

モデルの中で更新する層の選び方によって、回答が変わります。学習率や学習の回数も合わせ、データと業務に応じて探ります。

技術解説:更新対象層の調整

画像と言葉を扱うモデルへの適用

画像と文章を扱うモデルでは、データを学習用の形式に変換し、言葉を扱う部分を対象に学習。できたアダプタを本体と結合して使います。

技術解説:画像と言語のモデル

学習と軽量化を同じ流れで

Microsoft Oliveを使うと、LoRA/QLoRAの学習と量子化を設定ファイルで続けて実行できます。手順を再現しやすく、見直しも簡単です。

技術解説:Oliveによる最適化

04/使いどころ

書式・用語・判断の「業務のくせ」を、通信に頼れない現場で使う

タブレットを見ながら工場の設備を点検する技術者
写真はイメージです

LoRAが力を発揮するのは、答えの書き方や言い回しを業務に合わせたい場面と、データを社外に出せない、または通信が届かない場面です。想定される使いどころを業界ごとに整理しました。

製造

使いどころ
  • 点検記録・保全レポートの下書き
  • 作業手順の問い合わせ
  • 画像を見ての状況説明
ポイント工場の閉域ネットワークや端末で完結させ、現場の言い回しに合わせる

航空・運輸

使いどころ
  • 機内や移動中の引き継ぎレポート
  • 運行記録の整理
ポイント通信が不安定でも使えるよう、端末の中で動かす

車載・モビリティ

使いどころ
  • 走行中の音声操作
  • 車載端末での問い合わせ対応
ポイント端末内で処理し、応答の速さと安全性を両立する

社内の業務全般

使いどころ
  • 社内用語に沿った文書の下書き
  • 定型の報告書づくり
ポイント社外に出せない文書を、自社の環境で扱う

製造業の個別のご相談は、製造業向けAIもあわせてご覧ください。

05/当社の支援内容

適用診断から、学習、端末実装、運用と内製化まで

LoRAは、設定を試すだけなら手軽ですが、業務で使い続けるには、データ・評価・端末・運用の設計が欠かせません。当社は次の5段階で、一貫して伴走します。

支援の進め方:入口から全社展開まで
1
入口:適用診断とデータ整理業務のどこにLoRAが効くかを見極め、学習に使えるデータと、評価の基準を整理します。
業務の選定データ棚卸し評価基準づくり
2
最初の1周:学習と評価小さなデータでアダプタを学習し、業務の基準で比べます。更新する層や学習の設定も、ここで探ります。
LoRA/QLoRAMicrosoft OliveAzure VM
3
端末へ:軽量化と実装量子化で軽くして、オフライン端末やエッジに載せます。アプリへの組み込みと、配信の仕組みも整えます。
量子化Azure IoT Edgeオフライン対応アプリ
4
回し続ける:再学習と運用新しいデータでの再学習、回答の品質の見守り、アダプタの版管理を、独立した支援メニューとして運用します。
再学習の判断品質の監視版管理
5
全社へ広げる学習データの作り方や評価の手順を整理し、社内で回せる形に整えます。全社展開はAI Agent CoEと、現場への伴走はX-Tech FDEとつなげます。
手順書・ガイドライン内製化支援

06/当社の特長

学習して終わりにせず、業務の端末で動く品質まで仕上げる

学習から端末実装までを、一続きで検証

LoRA/QLoRAでの調整、量子化、クラウドでの学習、エッジ端末への配信までを組み合わせ、異なるハードウェアでの動作も確かめています。

文章だけでなく、画像を扱うモデルまで

テキストに加え、画像と言葉を扱うモデル(Phi-3.5-visionなど)のLoRA学習と、アダプタの結合まで技術検証を重ねています。

現場で使うための、オフライン実装の実績

オフラインで動く業務特化型の生成AIアプリを、量子化によるタブレットでの最適化まで含めて開発してきました。

Microsoftの基盤で、設計と運用までつなぐ

Microsoft Foundry、Olive、Azure、IoT Edgeといった基盤を組み合わせ、学習から配信、運用まで同じ環境で設計します。

設定の選び方や手順は、技術記事として公開し、知見を積み重ねています。

07/取り組み事例

調整からエッジ配信までの共同検証と、オフライン端末への実装

LoRA/QLoRAを明示した共同検証と、業務特化モデルを端末で動かす取り組みを紹介します。いずれも、重みが公開された小型モデルを、業務の端末や現場の環境に合わせて仕上げる点が共通しています。

東京エレクトロン デバイス

東京エレクトロン デバイス:調整からエッジ配信までの共同検証

Microsoft Oliveによる量子化とLoRA/QLoRAでの調整、Azure VM上での学習、Azure IoT Edgeによる端末への配信を組み合わせて検証しました。mini・small・medium・visionのPhi系モデルを比べ、文章と画像の両方への適用範囲、EFLOW・DirectML・CUDA・ONNX Runtimeによる異なるハードウェアでの動作も確かめています。保全レポートの作成やオフライン生成AIボットなど、業界特化のエッジAIを今後提供する方針です。

発表を見る →

日本航空

日本航空:機内オフラインで動く引き継ぎレポートづくり

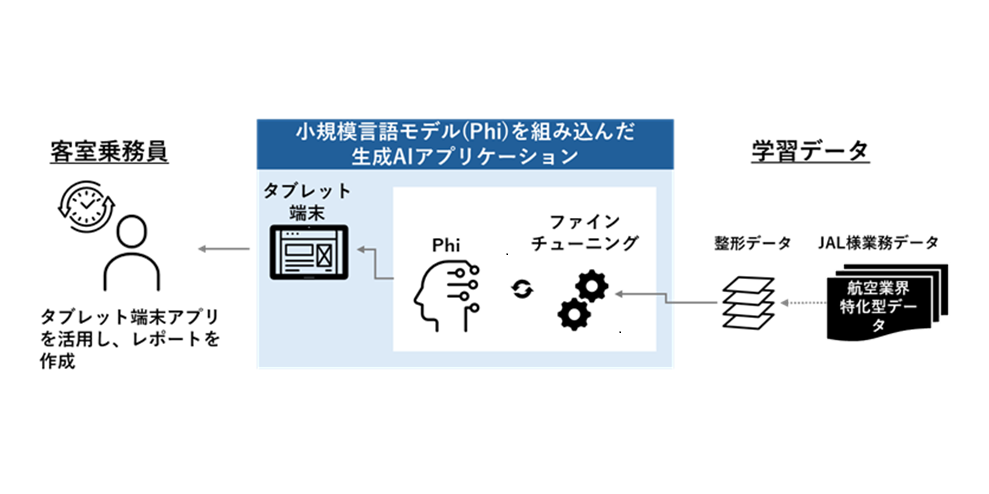
客室乗務員がタブレット上でチャット形式に引き継ぎレポートを作る、オフライン対応のプロトタイプを富士通と共同で開発しました。富士通が過去のレポートでPhiを業務向けに調整し、当社がオフラインで動くアプリの開発、量子化によるタブレットでの動作の最適化、業務の流れの分析から実証・評価まで、およびファインチューニング環境の技術支援を担当しました。富士通の公開事例では、引き継ぎレポートの作成時間が最大3分の1に短縮されたと紹介されています。この成果は調整したモデルに加えて、アプリと運用の設計を合わせた取り組み全体のものです。

発表を見る →

富士通の公開事例はこちらをご覧ください。

08/顧客価値

課題から価値までのつながり

LoRAによる調整が業務の課題をどう価値に変えるかを、課題ごとに整理しました。

回答の書式や言い回しがばらつく

回答例から学習して書式・用語・判断の基準をそろえ、修正の手間を減らします。

機密データを社外に出せない

小型モデルを調整して自社の環境や端末で動かし、データの持ち出しを避けます。

通信が届かない現場で使いたい

量子化して端末に載せ、オフラインでも回答を返せるようにします。

調整のコストと時間を抑えたい

小さなアダプタだけを学習するため、設備と学習時間を抑えて試せます。

拠点や業務ごとに使い分けたい

本体はそのままに、アダプタを差し替えて、業務ごとの仕上がりを分けられます。

社内で調整を回せるようにしたい

学習データの作り方と評価の手順を整え、社内での再学習と運用につなげます。

09/想定ROI

定型報告書の作成時間で見る、削減効果の試算

社内の定型報告書を、LoRAで調整した小型モデルが下書きし、担当者が確認・修正する場合の試算です。

月間の作業時間を比べる:定型報告書300件の場合
1件あたりの作成時間25分 → 10分
月間の作成件数300件
時間単価(人件費換算)4,000円
導入前
125時間
導入後(下書きを担当者が確認・修正)
50時間
削減 75時間
削減できる作業時間(月間)約75時間125時間 → 50時間
人件費に換算した削減額(月間)約30万円50万円 → 20万円
件数・作成時間・時間単価は、いずれも試算のために置いた仮定です。モデルの調整・評価・端末実装の費用は含んでいないため、投資回収の判断には別途、費用の見積もりが必要です。実際の削減幅は、現行の作業時間を測るPoV(効果検証)で確かめます。

10/導入ステップ

適用診断から社内展開までの5つのステップ

導入の5つのステップ
1
STEP 1 適用診断対象の業務と、学習に使えるデータ、データの持ち出し条件を確認します。
2
STEP 2 データ整備と評価基準回答例を整え、「何をもって良い回答とするか」を決めます。
3
STEP 3 試作と評価小さなデータでアダプタを学習し、基準に沿って比べます。
4
STEP 4 軽量化と端末実装量子化し、対象の端末で動かして、速度と品質を確かめます。
5
STEP 5 運用と社内展開再学習の判断、品質の見守り、版管理を決め、社内に広げます。

11/他の手段との違い

変えたい中身で選び分ける:知識の更新はRAG、書き方の調整はLoRA

LoRAは万能ではありません。何を変えたいかによって、向く手段が変わります。次の図は変えたい中身から手段を選ぶ軸を示したものです。

選び分けの軸:変えたいのは「知識」か「書き方」か

最新の社内文書を参照して答えさせたい

文書を検索して答えに使う方法(RAG)が向いています。知識の更新が速い業務に。

書式・言い回し・判断の基準をそろえたい

LoRAが向いています。回答例から「業務のくせ」を学習させます。

基礎的な能力から変えたい

モデル全体の学習や、別のモデルへの切り替えを検討します。設備と費用は大きくなります。

LoRAとRAGは、組み合わせて使うこともできます。たとえば、最新の文書はRAGで参照し、回答の書式と言い回しはLoRAで整えます。重みが公開されたモデル全般の考え方は、オープンウェイトモデル(LLM)活用支援で説明しています。

12/ガバナンス・運用

学習データとモデルの扱いを、運用の決めごとにする

ノートPCを囲んで内容を確認する3人のビジネスパーソン
写真はイメージです

自社のデータでAIを調整するときは、次の決めごとを先に置きます。

学習データの扱い

個人情報や機密情報を学習データに含めるかを決め、匿名化と、保管・削除のルールを定めます。

元のモデルの利用条件

調整に使うモデルのライセンスを確認し、業務での利用や再配布の範囲を整理します。

評価の基準と見直し

良い回答の基準を先に決め、アダプタを更新するたびに同じ基準で評価します。

版管理と差し戻し

アダプタをバージョンごとに管理し、品質が下がったときに前のバージョンへ戻せるようにします。

13/当社について

Microsoftの基盤で、AIの設計から実装までを担う

Microsoft AI Innovation Partner of the Year 2024 受賞Microsoft Japan Partner of the Year 2024のAI Innovationを受賞しました。詳しく見る →
Microsoft Azureの Specialization 認定Microsoft Azureの Specialization 審査に認定されました。詳細は発表をご覧ください。詳しく見る →

現場での実装は、X-Tech FDE(フォワードデプロイドエンジニアリング)で、お客様の業務の現場に入りながら進めます。

14/はじめ方

適用診断と、小さな試作から

はじめは対象の業務を1つに絞り、小さなデータで試作して、効果を測ります。次のような進め方をおすすめします。

1. 適用診断(目安:数日)

LoRAが効く業務かどうか、データと環境の条件を確認します。

2. 小さな試作

少ない回答例でアダプタを学習し、業務の基準で評価します。

3. 効果検証(PoV)

現行の作業時間と比べて、削減幅と費用対効果を確かめます。

15/関連ソリューション

モデル、基盤、現場、運用をつなぐ関連サービス
SLM

SLM(小規模言語モデル)アプリ開発

端末で動く小型モデルを使ったアプリの開発。LoRAで調整するモデルの受け皿になります。

詳しく見る →

Microsoft Foundry

Microsoft Foundry開発

モデルの選定、学習、評価、配信を支えるMicrosoftの基盤。

詳しく見る →

X-Tech FDE

X-Tech FDE

現場に入り込み、業務の流れから設計して実装まで伴走します。

詳しく見る →

AI Agent CoE

AI Agent CoE

調整したモデルを全社で使い続けるための、運用・統制・人材づくり。

詳しく見る →

オープンウェイトモデル

オープンウェイトモデル(LLM)活用支援

重みが公開されたモデルを、自社の環境で管理して使う考え方と進め方。

詳しく見る →

VLM

VLM(視覚言語モデル)

画像と言葉を扱うモデル。画像を使う業務でLoRAと組み合わせます。

詳しく見る →

16/よくあるご質問

LoRAの活用に関する疑問

Q.LoRAとは何ですか。
A.LoRAとは学習済みのAIモデルの本体を固定したまま、小さな追加部品(アダプタ)だけを学習して、自社の業務に合わせるファインチューニングの手法です。モデル全体を学び直すより、少ないGPUメモリと時間で調整できます。
Q.LoRAとQLoRAの違いは何ですか。
A.QLoRAはLoRAに量子化を組み合わせた方法です。本体を軽くした状態でアダプタを学習するため、LoRAよりさらに少ないメモリで調整できます。品質との兼ね合いは業務のデータで比べて決めます。
Q.ファインチューニングとRAGは、どう使い分けますか。
A.最新の社内文書を参照して答えさせたいときはRAG、書式や言い回し、判断の基準をそろえたいときはLoRAが向いています。両方を組み合わせることもできます。
Q.どのくらいのデータが必要ですか。
A.業務と目的によって変わります。件数だけでなく、回答の質とばらつきの少なさが効きます。まず少ないデータで試作し、評価しながら増やす進め方をおすすめします。
Q.どんなモデルに使えますか。
A.Phiなどの小型モデル(SLM)を中心に、画像と言葉を扱うモデルにも使えます。モデルごとに利用条件(ライセンス)が異なるため、選定の段階で確認します。
Q.調整したモデルを、端末やオフラインで動かせますか。
A.量子化で軽くしたうえで、タブレットやエッジ端末に載せられます。通信のない環境で動かした実績があります。端末の性能によって、モデルの大きさや速度は変わるため、事前に確かめます。
Q.精度は業務に足りますか。
A.モデルと業務によって異なります。業務のデータで比較し、決めた基準で評価してから判断します。軽量化で下がる品質や、調整による改善も、この段階で確かめます。
Q.費用はどのくらいかかりますか。
A.学習用の設備、データ整備、評価、端末への実装、運用の費用が必要です。件数や使う端末によって変わるため、前提を伺って試算します。

LoRAによる業務特化AIを、適用診断から相談する

次のようなときは、お気軽にご相談ください。

・⁠業務に合わせたAIの書き方・言い回しの調整を試したい・⁠機密データを外に出さず、自社の環境で生成AIを使いたい・⁠通信のない現場や端末で、AIを動かしたい・⁠LoRAとRAGの使い分けを決めたい・⁠調整したモデルを、社内で再学習・運用できるようにしたい
お問い合わせ