HOME/ビジネス/AIソリューション/エッジAI開発/ONNX
ONNX / エッジAIの実装基盤

ONNX(オニキス)
クラウドのAIをCPU・GPU・NPUのエッジ端末へ展開する設計・構築支援

ONNXは、AIモデルを機器の種類を問わず持ち運べる共通の形式です。
当社は、変換・検証・最適化から、車載・PC・カメラ・ロボット・オフライン環境への展開と運用までを支援します。

01/概要

ONNX(オニキス)とは:AIモデルを、機器の種類を問わず持ち運べる共通の形式

ONNX(Open Neural Network Exchange、読み方は「オニキス」)とは、AIモデルの中身を計算の手順(計算グラフ)として書き出す共通の形式で、PyTorchやTensorFlow、scikit-learnなど別々の道具で作ったAIを、同じ形で受け渡して動かせるようにするものです。ONNXを動かすための推論エンジンが「ONNX Runtime」で、CPU・GPU・NPU(AI専用の演算チップ)といった機器ごとの違いは、「Execution Provider(実行経路)」と呼ばれる部品が吸収します。

ここが肝心です。クラウドで作ったAIを車や工場の端末、AI PC、カメラ、ロボットで動かしたいとき、機器ごとにモデルを作り直していては、手間もお金もかさみます。ONNXを間に挟むと、モデルは一つのまま、動かす機器に合わせて最後の仕上げだけを変えられます。

次の図はAIが作られてから機器で動くまでの流れを、ONNXがどこにあたるかで示したものです。中央の2段がこのページで扱う範囲です。

AIが作られてから、機器で動くまで
① 作る:学習・開発クラウドや開発用のPCで、AIモデルを作ります。
PyTorchTensorFlow・Kerasscikit-learnHugging Face
↓ 変換
② 共通の形式:ONNXどの道具で作ったモデルも、同じ形式に書き出します。
計算グラフopset(対応する命令の版)Netronで中身を確認
↓ 読み込み
③ 動かすエンジン:ONNX RuntimeONNXのモデルを読み込んで、答えを出す(推論する)部分です。
推論エンジンPythonC++C#
↓ 機器に合わせて選ぶ
④ 実行経路:Execution Provider機器ごとの違いを吸収し、その機器の力を引き出す経路です。
CPUNVIDIA CUDA・TensorRTDirectMLIntel OpenVINOQualcomm QNNAMD MIGraphX
↓
⑤ 動かす機器
車載機器AI PC(NPU搭載)カメラロボット工場の端末閉域・オフライン環境
参考:ONNX公式、ONNX Runtime公式(Execution Providers)をもとに作図

ONNXを使うと、次のような課題に効きます。

機器ごとの作り直しを減らすモデルは一つのまま、機器に合わせた仕上げだけを変えます。展開先が増えても、全体をやり直さずに済みます。
ハードウェアの選択を縛らない特定の半導体メーカーに合わせて作り込む前に、複数の機器で速度や省電力を比べて選べます。
機器の力を引き出す機器に合う経路を選び、軽量化(量子化)も組み合わせて、限られた性能の端末でも実用的な速さにします。
変換後も結果が同じか確かめる変換して動いたことで終わりにせず、元のモデルと答えが一致するかを検証して、品質を保ちます。

当社は、クラウドで開発したAIをONNXでポータブルにし、車載・PC・カメラ・ロボット・オフライン環境へ展開するところまでを、設計・構築・検証の面から支援します(エッジAI開発)。

02/注目される背景

AIを動かす場所が増え、機器ごとの違いが課題に

ノートPCや端末の画面を囲んで話し合う社員
写真はイメージです

AIは、クラウドの中だけで動くものではなくなってきました。パソコンの中、工場の端末、車、カメラ、ロボットなど、通信に頼らずその場で答えを出す使い方が広がっています。その分、動かす機器の種類が増え、機器ごとに作り直す手間が、導入を遅らせる原因になっています。

MicrosoftはWindowsで使うAIの仕組み「Windows ML」を、ONNX Runtimeの上に作っています。PyTorch、TensorFlow、scikit-learnなどで作ったモデルをONNXに変換し、CPU・GPU・NPUのうち、そのパソコンに合うものを使って動かす考え方です。公式の説明では、機器ごとの実行経路をWindowsが入れて更新するため、開発側は機器ごとに別の版を作らなくてよいとされています。

ONNX Runtimeの公式文書には、NVIDIAのCUDAとTensorRT、Intel OpenVINO、Qualcomm QNN、AMD MIGraphX、Microsoft DirectMLなど、多くの実行経路が一覧になっています(Execution Providers一覧)。選べる機器の幅が広がった反対側で、「どれを選ぶか」の判断が新しい仕事になっています。

ONNX自体も公式サイトで「別々のAIの道具が、モデルを共有できるようにする取り組み」と説明されています。特定の道具や会社に縛られずにAIを使える共通の形式として、AIを動かす場所を選ぶ時代に改めて注目されています。

こうした流れの中で、「モデルを作る人」と「動かす機器を選ぶ人」を切り離し、機器が決まった段階で最後の仕上げをする進め方が、現実的な選択肢になっています。

03/仕組み

変換・検証・最適化・配備:ONNXをAIの現場で動かす4つの工程

大型モニターに映した構成図を見ながら打ち合わせる技術者
写真はイメージです

ONNXは「変換すれば終わり」ではありません。次の図は作ったAIを機器で使える状態にするまでの工程を、順番に示したものです。

ONNXでAIを機器に展開する工程
1
変換:ONNXに書き出すPyTorchなどのモデルをONNXに変換します。入力の名前・形・数値の型、対応していない命令(演算)の有無を確認します。
入力名・形・型opset未対応の演算
2
検証:元のモデルと答えが一致するか確かめる変換前後で、同じ入力に対して同じ答えが返るかを確かめます。前処理の違いによるずれもここで見つけます。
出力一致の確認前処理の差Netronで構造確認
3
最適化:機器に合わせて軽く速くする機器に合う実行経路を選び、軽量化(量子化)やメモリの使い方を調整します。速度・精度・メモリの釣り合いを、機器ごとに比べます。
実行経路の選定量子化(INT8・INT4)速度・メモリ
4
配備:端末へ届けて使い続ける機器にモデルを届け、動かします。更新、記録、元に戻す手順まで含めて、使い続けられる形にします。
配布・更新監視・記録ロールバック

実行経路は機器の力を引き出す部分です。主なものを、動かす機器との対応で整理します。

実行経路(Execution Provider)と、向いている機器
CPU(標準)どの機器でも動く基本の経路。性能の基準点になります。
NVIDIA CUDA・TensorRTNVIDIAのGPU向け。サーバーやJetsonなどの組み込み機器で、速度を引き出します。
DirectML・Windows MLWindowsのパソコン向け。GPUやNPUを、機器に合わせて使い分けます。
Intel OpenVINOIntel製のCPU・GPU・NPU向け。AI PCや産業用PCで使われます。
Qualcomm QNNSnapdragon搭載機器のNPU向け。Copilot+ PCや車載・モバイルが対象です。
AMD MIGraphXAMD製のGPU向け。AMD搭載の機器で速度を引き出します。
出典:ONNX Runtime公式(Execution Providers)。対応機器は版によって変わるため、導入前に最新の一覧で確認します。

どの経路を選ぶかは機器、モデル、求める速さと省電力で変わります。当社は候補を並べて実際に測り、機器ごとに選び分けます。

04/使いどころ

機器が複数ある業務と、通信に頼れない現場

ONNXが効くのは、「同じAIを、種類の違う機器で動かしたい」場面です。次の5つが代表的な使いどころです。

1車載・モビリティ車載カメラの映像を、車の中で判断し、ドライバーへ伝えます。搭載する半導体が決まる前に開発を進め、決まった段階で仕上げます。
2AI PC・Windowsの業務アプリNPUを積んだパソコンで、文書や画像を扱うAIを端末の中で動かします。機器に合う実行経路をWindowsが選びます。
3カメラ・ロボット・工場の端末現場の映像をその場で判断します。通信の遅れや、映像を外に出せない制約がある場面に向きます。
4オフライン・閉域の環境防衛・医療・工場など、外部につなげない環境で、端末の中だけでAIを動かします。小型の言語モデル(SLM)にも使えます。
5複数の機器へ展開する製品同じAI機能を、複数の機種や世代に載せる製品です。機種が増えても、モデルは一つのまま保てます。
6クラウドと端末をまたぐ運用クラウドで評価・更新し、端末へ配る運用です。クラウドのAI基盤とつなげて、更新を回し続けます。

向かない場面もあります。動かす機器が1種類に決まっていて、その機器専用の仕組みで十分に速いときは、専用の仕組みを直接使う方が簡単です。クラウドのAIサービスで足りる業務も、ONNXの出番はありません。当社は最初の診断でこの見極めから一緒に行います。

05/当社の支援内容

診断と性能比較から、最適化・実装・運用まで

複数のモニターを見ながら検証を進める技術者
写真はイメージです

当社は、モデルを変換して終わりにせず、機器で使える品質に仕上げ、使い続けられる状態にするまでを支援します。次の図は入口から全社展開までの段階です。

ONNX活用の支援メニュー(入口 → 構築 → 運用 → 全社へ)
1
モデル棚卸しと変換の診断(入口)手元のモデルを洗い出し、ONNXに変換できるかを診断します。未対応の演算、入力と出力の取り決め、元のモデルとの答えの一致を確認します。
モデル棚卸し変換可否出力一致
2
複数機器での性能比較(入口)CPU・GPU・NPUと、実行経路の候補を同じ条件で比べます。速さ、処理できる数、メモリ、消費電力を測り、機器選びの材料にします。
TensorRT・OpenVINO・QNNWindows ML速度・電力
3
モデルの最適化(最初の1周)量子化、計算の整理、入力の大きさの設計を行い、精度の下がり方を評価します。機器に載る大きさと速さに、仕上げます。
INT8・INT4RTN・AWQ精度劣化の評価
4
端末への実装(最初の1周)Windows、Linux、Jetson、小型ボード、AI PC、車載機器へ組み込みます。C++・C#・Pythonからの利用や、オフライン環境にも対応します。
組み込みオフライン対応C++・C#・Python
5
運用と継続改善(回し続ける)モデルの版管理、コンテナでの配布、記録・監視、元に戻す手順、継続的な精度評価を整えます。運用は構築とは別の支援メニューとして、独立して承ります。
版管理配布・更新監視・ロールバック

現場に入り込んでの伴走は、X-Tech FDEが担います。複数の部署や拠点へ広げる段階では、AI Agent CoEで、進め方と決まりごとを全社の共通にします。

06/当社の特長

変換して動かすだけでなく、機器で使える品質まで仕上げる

次の4点が当社のONNX支援の特長です。

変換の成功を、完了にしない変換後も、元のモデルと答えが一致するかを確かめます。入力の名前・形・型、前処理の違い、未対応の演算といった、つまずきやすい点まで見ます。
特定のハードウェアに固定しないまず開発しやすい環境でモデルと処理を固め、搭載する半導体が決まった段階で機器に合わせて仕上げます。NVIDIA、Qualcomm、Intel、AMD、Armの混在にも対応します。
クラウドと端末を、つなげて考えるAzureやMicrosoft Foundryでの評価・運用と、端末への配布を、一つの流れとして設計します。
提案から実装まで、一貫して担う構成図、評価表、段階の計画、概算見積を作る提案の段階から、実機での検証、実装までを同じチームで進めます。

07/取り組み事例

ONNXを軸にした当社の取り組みと、端末で動くAIの公開事例

当社の取り組みはお客様の名称を伏せ、業種と内容で示します。実施内容は実装・検証したもの、設計しているものを区別して書いています。

ONNXを軸にした当社の取り組み
1
自動車メーカー向け:車載カメラを使うAIの先行開発車載カメラの映像から、人の動き、車の量、道路の状況などをAIで判断し、ドライバーに必要な情報を伝えるシステムを開発しています(2025年3月〜5月)。開発したモデルをONNXに変換し、搭載する半導体ごとに軽量化して動かす構成を、設計しています。
車載先行開発ONNX Runtime
2
モビリティ関連メーカー向け:視覚による位置推定の技術検討PyTorchのモデルをONNXに変換し、C++のアプリからONNX Runtimeで動かす経路を検討しています。GPUでの実行とTensorRTによる最適化の速度比較も、候補に挙げています。
PyTorch→ONNXC++組み込みTensorRT
3
小型ボードでの推論の検証物体を見つけるモデルをONNXで小型ボード(Raspberry Pi 5)に載せ、実際に動かして測りました。1回の推論は小型ボードで約300〜400ミリ秒、パソコンで約100ミリ秒でした。GPUのない機器での速度の制約を確かめ、機器の選び方に生かしています。
小型ボード速度の実測機器選定

このほかWindowsでのローカルAIについては、ONNX Runtime・Windows ML・小型言語モデルの実装を、当社の技術ブログ(Zenn Publication)で連載しています。

次の3件は端末で動くAIを扱った公開事例です。実施内容は各発表の範囲で書いています。

日本航空

日本航空:機内オフラインで動く報告書づくり

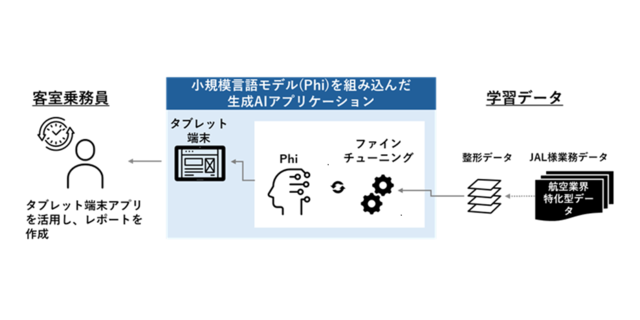
機内のオフライン環境を想定し、客室乗務員がタブレット上で引き継ぎレポートを作るプロトタイプを、富士通と共同で開発しました。当社はオフライン対応アプリの開発と、量子化による端末での動作の最適化などを担当しました。

発表を見る →

東京エレクトロン デバイス

東京エレクトロン デバイス:調整からエッジ配信までの共同検証

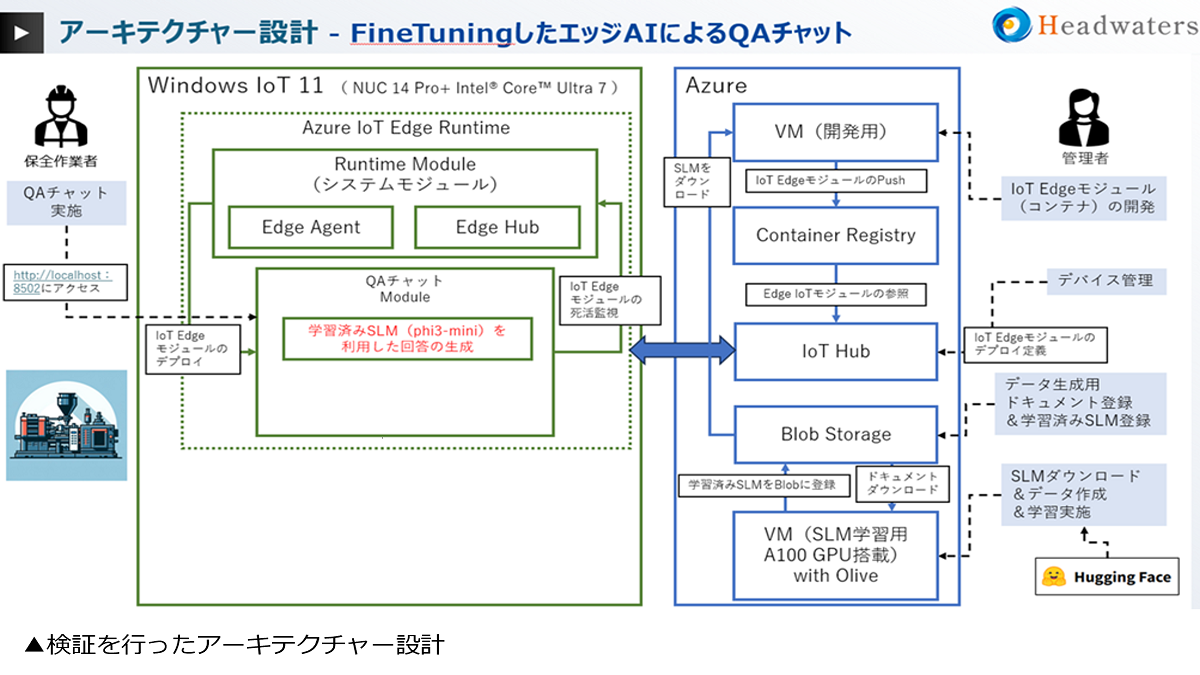
量子化と追加学習、Azureでの学習、端末への配信を組み合わせ、テキストと画像を扱うPhi系モデルで検証しました。異なるハードウェアでの動作も確かめています。

発表を見る →

パイオニア

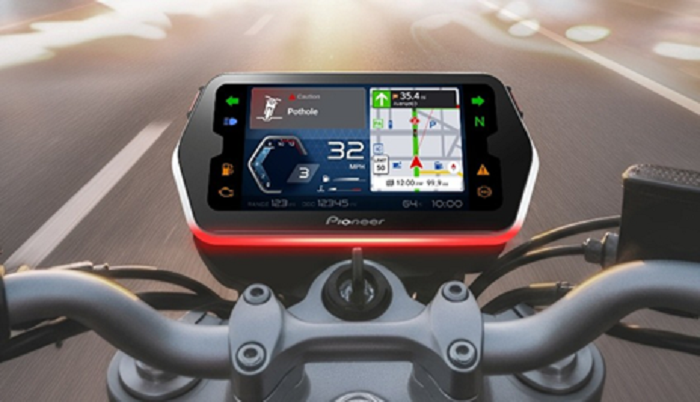
パイオニア:車載端末で動くSLMエージェント

小型言語モデルを使ったAIエージェントを開発し、端末の中で処理して、走行中も音声で操作できる仕組みを検証しました。通信が不安定な移動中でも応答できることをねらっています。

SLMのページを見る →

08/顧客価値

課題から価値までのつながり

ONNXの活用がどの課題にどう効くかを、立場別に整理します。

製品・開発の責任者:機器が増えるたびに作り直している機器ごとの移植をやめ、モデルを一つに保ちます。展開先が増えても、追加の作業を機器に合わせた仕上げに限れます。
IT・情報システム:AI PCやオフライン端末へ配りたい機器に合う実行経路の取得・更新を、Windows MLなどに任せ、配布と更新の手間を減らします。
調達・企画:どの半導体を選ぶか決めきれない複数の機器で同じ条件の測定を行い、速度・電力・費用を比べてから選べます。選択を、先送りにも固定にもしません。
品質・安全の責任者:変換後に精度が落ちないか不安元のモデルとの答えの一致、量子化による精度の下がり方を、決めた基準で確認します。
現場の担当者:通信がなくても使いたい端末の中だけで動かせるため、通信の遅れや切れの影響を受けにくく、映像やデータを外に出さずに済みます。
経営層:PoCで終わらず、使い続けたい変換・検証・最適化・配備・運用までを段階で計画し、PoCから本番までの道筋を見える形にします。

09/想定ROI

1つのAIを3種類の機器へ展開する場合の試算

同じAIモデルを、パソコン、車載ボード、カメラの3種類の機器へ展開する場合を想定します。機器ごとに個別に移植する進め方と、ONNXで共通化してから機器ごとに仕上げる進め方を比べます。

次の表は、工数の前提を置いて計算した結果です。

項目
現在(機器ごとに個別移植)
ONNX共通化後
共通部分の作業(変換・出力一致の検証)
なし(機器ごとに実施)
15人日
機器ごとの作業
30人日 × 3機器 = 90人日
10人日(実行経路の選定・最適化・検証) × 3機器 = 30人日
合計工数
90人日
45人日
削減できる工数
―
45人日(約半分)
費用の目安(1人日 = 8万円と仮定)
720万円
360万円(約360万円の削減)
前提:1人日=8万円、モデル1件、展開先3機器。展開先が増えるほど、共通部分の割合が下がり、差が広がります。実際の工数は、現行の作業をPoVで測って確定します。

変換と検証にかかる最初の費用を、展開先の数で割り引いて考えられるのが、ONNX共通化の考え方です。展開先が1種類だけの場合は、この差は出ません。

10/導入ステップ

モデル棚卸しから運用までの5つのステップ

次の図はONNX活用を進める標準の流れです。最初の2つは短い期間で実施でき、機器や進め方を決める材料になります。

導入の流れ(STEP 1〜5)
1
STEP 1 モデル棚卸しと変換の診断対象モデルと展開先の機器を洗い出し、変換できるかを診断します。
モデル棚卸し変換可否
2
STEP 2 複数機器での性能比較候補の機器・実行経路で、速度・メモリ・消費電力を測ります。
速度・電力の測定機器の候補絞り込み
3
STEP 3 最適化と精度の評価量子化などで軽くし、精度の下がり方を基準で確認します。
量子化精度評価
4
STEP 4 端末への実装と実機検証対象の機器へ組み込み、実機で動かして確かめます。
組み込み実機検証
5
STEP 5 配布・運用の仕組みづくり版管理、配布、記録・監視、元に戻す手順を整えます。
版管理監視ロールバック

11/他の手段との違い

動かす機器の種類と、変わる頻度で選び分ける

AIを機器で動かす方法は、ONNXだけではありません。次の図は問いに順に答えると、選ぶ方法が決まる流れです。

機器でAIを動かす方法の選び方
問い1:AIをクラウドに送って、答えを受け取る方式で足りますか。足りる → クラウドのAIサービス(API)。通信できない現場、映像やデータを外に出せない業務、通信の遅れが困る場面のときは、問い2へ。
↓ 端末で動かす必要がある
問い2:動かす機器は、1種類に決まっていますか。決まっている → その機器専用の仕組み(半導体メーカーの専用の道具)を直接使うと、最も引き出せます。複数ある、または未定 → 問い3へ。
↓ 機器が複数、または未定
問い3:主な機器は、Windowsのパソコンですか。パソコン中心 → Windows MLを軸に、ONNXで動かします。車載・組み込み・カメラ・ロボットなど混在 → ONNX Runtimeで共通化し、機器ごとに実行経路を選びます。

複数の機器を相手にするときは、ONNXで共通化する価値が大きくなります。一方、機器が固定なら専用の仕組みが簡単です。当社は、診断の段階で、どの方法が合うかを一緒に決めます。

12/ガバナンス・運用

端末に配ったAIを、安全に使い続けるための決めごと

暗い部屋で複数の監視画面を確認する担当者
写真はイメージです

端末にAIを配ると、更新や記録の管理が、クラウドとは別の仕事になります。次の5点を、最初に決めておきます。

モデルと実行経路の版管理どのモデルを、どの版の実行経路で、どの機器に配ったかを記録します。版の互換性が合わず「読めないモデル」になることを防ぎます。
結果の一致と精度の確認更新のたびに、元のモデルとの答えの一致と、決めた精度の基準を確認します。
配布・更新・元に戻す手順コンテナや更新の仕組みで配り、問題が出たら前の版へ戻せるようにします。
記録と監視動いた速さ、失敗、精度の変化を記録し、端末ごとの状態を把握します。
利用条件(ライセンス)の確認使うモデルや部品の利用条件を確認し、配布先の範囲と合っているかを確かめます。

13/当社について

Microsoft AI Innovation Partner of the Year 2024 受賞
Microsoft AI Innovation Partner of the Year 2024 受賞

Microsoft AI Innovation Partner of the Year 2024 受賞

Microsoftのパートナーとして、Azureを中心にAIの設計・実装・運用を支援しています。

お知らせを見る →

AzureのSpecialization認定

AzureのAI PlatformなどのSpecialization認定

AI基盤の構築と開発の生産性向上の分野で、Microsoftの専門性認定を取得しています。

お知らせを見る →

X-Tech FDEによる、現場起点のAI実装

X-Tech FDEによる、現場起点のAI実装

現場に入り込むエンジニアが、課題の発見から実装・定着までを伴走します。

X-Tech FDEを見る →

14/はじめ方

モデルの棚卸しと、小さな比較検証から

まずは、手元のモデルを1つ選び、変換の診断と、2〜3種類の機器での速度の比較から始めるのが現実的です。結果をもとに、機器の選び方と、PoCの進め方を決めます。

15/関連ソリューション

モデル、機器、現場、組織をつなぐ関連サービス

ONNXの活用は、変換だけでは完結しません。小さなモデルの活用、端末側の開発、動かす基盤、現場への入り込み、組織への定着を、関連するサービスと組み合わせて進めます。

SLMアプリ開発

SLM(小規模言語モデル)アプリ開発

端末の中で動く、軽くて扱いやすい言語モデルを使ったアプリを開発します。

SLMアプリ開発を見る →

エッジAI開発

エッジAI開発

現場の機器の中で、AIを動かす開発を支援します。

エッジAI開発を見る →

フィジカルAI

フィジカルAI

ロボットや装置など、現実の世界で動くAIを支援します。

フィジカルAIを見る →

Microsoft Foundry

Microsoft Foundry開発

モデルの評価・運用・配布の基盤を、Microsoft Foundryで整えます。

Microsoft Foundry開発を見る →

X-Tech FDE

X-Tech FDE

現場に入り込んで、課題の発見から定着までを伴走します。

X-Tech FDEを見る →

AI Agent CoE

AI Agent CoE

複数の部署へ広げるときの進め方と決まりごとを、全社の共通にします。

AI Agent CoEを見る →

16/よくあるご質問

Q.ONNXとは何ですか。読み方も教えてください。
A.ONNX(読み方は「オニキス」)とは、AIモデルを計算の手順(計算グラフ)として書き出す共通の形式です。PyTorch、TensorFlow、scikit-learnなど別々の道具で作ったモデルを、同じ形で受け渡して動かせます。動かすための推論エンジンが「ONNX Runtime」です。
Q.ONNXとONNX Runtimeは、どう違いますか。
A.ONNXは、モデルを書き出す「形式」です。ONNX Runtimeは、その形式のモデルを読み込んで動かす「推論エンジン」です。機器ごとの違いは、ONNX Runtimeの中のExecution Provider(実行経路)が吸収します。
Q.ONNXに変換すると、精度は変わりませんか。
A.変換だけで精度が大きく変わることは少ないものの、前処理の違いや未対応の演算で、答えがずれることがあります。当社は、変換後に元のモデルと答えが一致するかを確かめ、量子化を使う場合は、精度の下がり方も基準で評価します。
Q.PyTorchのモデルは、そのままONNXにできますか。
A.多くのモデルは変換できますが、対応していない演算(operator)や、入力の大きさが変わる設計では、調整が要ります。最初の診断で、変換できるか、どこに手を入れるかを確認します。
Q.Windows MLとONNX Runtimeは、どう使い分けますか。
A.Windows MLは、ONNX Runtimeを土台にした、Windows向けのAI実行の仕組みです。パソコン中心なら、Windows MLで実行経路の取得・更新を任せられます。車載・組み込み・カメラ・ロボットなど混在する場合は、ONNX Runtimeで共通化し、機器ごとに実行経路を選びます。
Q.TensorRT、OpenVINO、QNNは、どう選びますか。
A.動かす半導体で決まります。NVIDIAのGPUならTensorRT、Intelの機器ならOpenVINO、Snapdragonを積んだ機器ならQNNが候補です。当社は、候補を同じ条件で測り、速さ・電力・費用で選びます。
Q.ONNXは、小型の言語モデル(SLM)にも使えますか。
A.使えます。ONNX Runtime GenAIなどを使い、Phiなどの小型モデルを、CPU・GPU・NPUで端末の中だけで動かせます。軽量化(INT4量子化)や、文脈の長さとメモリの関係も、事前に確かめます。
Q.機器が1種類だけでも、ONNXを使う意味はありますか。
A.機器が1種類に決まっていて、その専用の仕組みで十分に速いなら、専用の仕組みを直接使う方が簡単なことがあります。将来、機器が変わる、増える見込みがあるなら、ONNXで共通化しておく価値があります。

ONNXの活用を、モデルの棚卸しから相談する

次のようなときは、お気軽にご相談ください。

・⁠クラウドで作ったAIを、車載・PC・カメラ・ロボットなど複数の機器で動かしたい・⁠手元のPyTorchモデルが、ONNXに変換できるかを診断したい・⁠CPU・GPU・NPUや、TensorRT・OpenVINO・QNNの候補を、実測で比べたい・⁠量子化で軽くしたいが、精度の下がり方が心配・⁠端末に配ったモデルの更新・記録・元に戻す手順を整えたい
お問い合わせ