01/Copilot Fusionとは
GitHub Copilot Fusionとは:AIモデルの使い分けを自動化する機能
GitHub Copilot Fusion(コパイロット フュージョン)は、GitHub Copilotの中で、作業ごとに「どのAIに任せるか」「1つのAIで済ませるか、別のAIにも確認させるか」を自動で決める機能です。新しいAIではなく、既存のAIへの仕事の割り振り役です(技術的にはルーター、オーケストレーターと呼ばれます)。利用者は、AIの名前を選ぶ代わりに「Copilot Fusion」を選び、どこまで手間をかけるか(努力レベル)を指定するだけです。作業の途中でAIを切り替えたり、どの作業にどのAIが向くかを考えたりする必要がなくなります。
前提となる言葉を整理します。AIモデルとは、文章やプログラムを作り出すAIの頭脳にあたる部分で、Anthropic社の「Claude」、OpenAI社の「GPT」など、複数の会社が提供しています。モデルごとに得意な作業と料金が違い、高性能なモデルほど1回あたりの費用が高くなります。GitHub Copilotは、プログラムの作成・修正・確認をAIが手伝うサービスで、これらのモデルを選んで使えます。これまでは、開発者が作業ごとにモデルを手で選ぶか、1つのモデルを自動で選ぶ機能(Auto)を使っていました。Copilot Fusionは、この自動選択に「下書きと確認を複数のAIで分担する」仕組みを加えたものです。
モデル選択の変化
これまで:人がAIを選ぶ
開発者が作業ごとにAIを指定します。高性能なAIを選んだまま戻し忘れると、簡単な作業にも高い費用がかかります。逆に、安価なAIのまま難しい修正に入ると、やり直しが増えます。
個人の判断に依存コストのばらつき
→
Copilot Fusion:手間のかけ方だけ選ぶ
開発者は「標準(Standard)・高(High)・最大(Max)」の努力レベルだけを選びます。どのAIを、どの順番で、何回使うかはCopilot Fusionが作業ごとに判断し、1つの回答として返します。
機能が判断会社が許可したAIの範囲内
GitHub Docs「About GitHub Copilot Fusion」の記載をもとに作図
Copilot Fusionを使うメリット(業務の言葉で)
切り替え忘れがなくなる
高性能なモデルを選んだまま日常作業を続け、費用がかさむ状況を防ぎます。
難しい作業でも品質を確保
下書きの判定や別のAIによる見直しが入り、1回の依頼で合格に近づけます。
必要なときだけ費用をかける
別のAIを追加で使うのは、結果が良くなる見込みがある場合に限られます。
新しいAIへの乗り換えが不要
候補のAIはGitHubが評価して入れ替えるため、新しいAIが出るたびの検討が不要です。
会社の方針の範囲で動く
管理者が許可したAIの中でしか選ばれず、全員の初期設定も配れます。
使ったAIを後から確認できる
回答ごとに、実際に使われたAIの一覧を見られます。
用語整理
自動モデル選択(Auto)
1つの依頼に対して、最も合う1つのAIを自動で選ぶ機能です。2026年前半に提供されました。
Project HydraFusion
複数のAIを組み合わせて1つの作業を仕上げる仕組みの試験公開(研究プレビュー)です。2026年9月4日に始まりました。
GitHub Copilot Fusion
上の2つをまとめた正式な機能です。2026年10月28日に一般提供(GA)となり、GitHub Copilotのすべての契約プランで使えます。
02/注目される背景
マルチモデル化とAIクレジット課金:モデル選択が経営の論点になった理由
AI開発支援ツールで使えるモデルは、数か月ごとに増え、入れ替わります。考える力、プログラムを書く力、不具合を見つける力など、得意分野もモデルごとに異なり、1つのモデルがすべてに最適とは限りません。一方で、GitHub Copilotの料金は、使ったモデルの単価に応じて利用枠(AIクレジット)を消費する従量制へ移っています。高性能なモデルをすべての作業に使えば費用が膨らみ、安価なモデルだけでは難しい修正でやり直しが増えます。「どのモデルを、どの作業に使うか」が、開発者個人の好みではなく、品質とコストの運用方針として扱うべき論点になりました。
GitHubは、開発者が手作業で行っていた「あるAIで下書きし、別のAIに見直させ、難しければ高性能なAIに任せ直す」という進め方を、製品の中に組み込みました。試験公開(Project HydraFusion)を経て、2026年10月28日のGitHubの年次イベント「GitHub Universe」で正式な機能となりました。
経緯(2026年)
2026年9月4日
Project HydraFusionを研究プレビューとして公開
開発者向けのコマンド操作ツールで試験的に提供。3つの進め方(単独・段階的な引き上げ・相互チェック)と、評価結果を公表。
2026年9月30日
VS CodeとGitHub Copilotアプリへ拡大
広く使われている開発ツールでも試せるようになり、作業の途中経過も表示されるように。
2026年10月14日
使うAIの入れ替えと、最上位の「Max」を追加
下書きは標準の力で、見直しはより深く考えさせるなど、工程ごとにAIの使い方を変える方式へ。見直しは複数のAIが同時に行う形に。
2026年10月28日
GitHub Copilot Fusionとして一般提供(GA)
自動モデル選択と統合し、3段階の努力レベル、管理者による利用AIの制限、すべての契約プランへの対応で提供開始。以前の設定は自動で引き継がれた。
03/仕組み
AIの3つの進め方:単独・段階的な引き上げ・相互チェック
Copilot Fusionは、依頼ごとに作業の難しさを見積もり、選んだ努力レベルの品質を満たす、最も手間の少ない進め方を選びます。別のAIを追加で使うのは、結果が良くなる見込みがあるときだけです。簡単な作業で不要な見直しを待ったり、費用がかかったりすることはありません。同じ会話の中でも、依頼ごとに別の進め方が選ばれます。社内の仕事にたとえると、次の3つです。
3つの進め方(実行パターン)
担当者が1人で仕上げるSingle(単独)
AI 1つ→完成
1つのAIがそのまま仕上げます。いつもの使い方と同じ速さと費用です。簡単な作業はこの進め方になります。
若手が下書きし、必要ならベテランへCascade(段階的な引き上げ)
安価で速いAIが下書き→合格か判定→不合格なら高性能なAIがやり直す
まず安価なAIが取り組み、確認役が出来を判定します。基準に届かなければ、高性能なAIが最初からやり直します。費用の高いAIは必要なときだけ使われます。
複数のレビュアーが読み、本人が直すCritique(相互チェック)
AIが下書き→別のAIが同時にチェック→指摘を反映して修正
下書きを、別の会社のAIを含む確認役が読み、指摘をまとめて元のAIが直します。確認役は読むだけで、プログラムは書き換えません。
GitHub Docsの説明をもとに作図。確認の工程が入る2つの進め方は、単独より時間がかかります
途中の下書きは、修正されたり捨てられたりするため利用者には表示されず、最終的な1つの回答だけが返ります。回答の下に表示される努力レベル名にマウスを合わせると、実際にどのAIが使われたかを確認できます。
費用を抑えるための設計
同じ会話はできるだけ同じAIで続け、前回までに読み込んだ内容を再利用して費用を抑えます。確認役のAIには、必要な情報だけを渡します。AIの切り替えは、話題や難しさが大きく変わる場面に限られます。
安全に適用するための設計
GitHubは、5つの原則を公表しています。すべての工程の費用を記録する、工程ごとに時間の上限を設ける、確認役のAIはプログラムを書き換えられない場所で動かす、失敗や中断のときは変更を反映しない、使うAIが利用できるかを事前に確かめる、の5つです。
04/努力レベル
努力レベルの選び方:標準・高・最大と、利用できる契約プラン
利用者が選ぶのは「努力レベル」です。品質・費用・速さのどれを優先するかを伝える設定で、Copilot Fusionはその範囲で進め方とAIを決めます。高(High)と最大(Max)は1つの作業に複数のAIを使うことがあるため、標準(Standard)より費用がかかる場合があります。
努力レベル考え方向いている作業
標準(Standard)
費用・品質・速さのバランスを取る。基本は1つのAIで処理。
日々の開発作業全般。すべての契約プランで利用可。
高(High)
複数のAIで確認し合う。費用と時間は増えるが、やり直しを減らす。
原因の分かりにくい不具合の修正、複数のファイルにまたがる変更など、範囲がはっきりした難しめの作業。
最大(Max)
最も高性能なAIを優先。費用の無駄も抑える。
最も深く考え、徹底的に分析する必要がある作業。
高速(Fast)
速さを優先。利用者は選べない。
入力中にその場で答える場面など、すぐに応答が必要なときに自動で使われる。
標準はすべての契約プランで使えます。高と最大は、法人向けのBusiness・Enterpriseなど、対応する契約プランに限られます。使える開発ツールは、Visual Studio Code、GitHub Copilotアプリ、コマンド操作用のCopilot CLI、JetBrains社の開発ツールで、他のツールも順次対応する予定です。
開発者のPCの中で動くAI(ローカルモデル)にも割り振れる機能が、試験提供中(パブリックプレビュー)です。ただし割り振りの判断はインターネット上で行うため、オフラインでは使えません。
05/公表された評価
GitHubが公表した品質とコストの比較結果
GitHubは正式提供の発表で、AIの性能を比べる第三者機関Artificial Analysisの評価(AIによるプログラム開発の指標)で、Copilot Fusionの最大レベルが60点となり、Anthropic社の開発ツールClaude Code(最上位の設定)との差が2点以内だったと説明しています。そのときの1作業あたりの平均費用は約半分、AIが処理した文字量(トークン)も約半分、かかった時間は約40%短かったとしています。
評価に使った作業(試験公開の時点)費用(高性能なAI単独との比較)正しく完了した割合(同)
コマンド操作で複数の手順を進める作業(TerminalBench 2.1)
67%低い
+4.9ポイント
大規模なプログラムの修正作業(DeepSWE)
36%低い
−1.5ポイント
実際の利用記録をもとにしたGitHub社内の評価(CheckpointBench)
65%低い
−0.1ポイント
出典:The GitHub Blog(2026年9月4日)。比較の相手はAnthropic社のClaude Opus 5です。試験公開の時点で、GitHubが条件を揃えて行った評価で、使った問題・設定・AIの組み合わせ・価格の前提に固有の結果です。正式提供版の構成とは異なります。
利用企業の声として、GitHubは米国の通信会社AT&Tの例を紹介しています。開発者が難しい作業のために高性能なAIを選び、日常の作業に戻っても切り替え忘れることが多かったところ、標準レベルが作業に合うAIを自動で選ぶことで、無駄な支出が減り、重要な作業に利用枠を残せたと説明されています。これらの数値はGitHubとその顧客が公表したもので、貴社の開発でどうなるかは、同じ作業での比較検証で確かめます(10. 検証の進め方)。
06/統制と料金
管理者ができること、課金の仕組み、知っておくべき制約
Copilot Fusionは、会社として利用を認めたAI(モデルポリシー)の範囲でしか動きません。データの保存場所や公的なセキュリティ基準に合うAIだけに限る設定も、そのまま効きます。認めたAIが1つもなければ、Copilot Fusionは選択肢に表示されません。つまり、AIの割り振りは製品が行いますが、「どのAIを使ってよいか」を決めるのは会社です。
許可モデルの管理
管理者は、Copilot Fusionが選ぶ候補のAIを一覧で確認し、1つずつ許可・禁止を設定できます。通常の利用では許可したまま、Copilot Fusionの候補からだけ外すこともできます。
全社の標準として配る
管理者の一括設定で、Copilot Fusion(努力レベルも指定)を全員の初期設定にできます。AIの使い分けを個人任せにしない運用ができます。
料金
Copilot Fusion自体の追加料金はなく、実際に使われた各AIの通常の単価で課金されます。2026年11月30日まで、有料プランの利用者はCopilot Fusion利用時のモデル費用が30%割引されます。
注意点内容と業務での対応(2026年11月5日時点)
作業の分担はしない
大きな作業を小分けにして別のAIへ任せる機能(サブエージェント)とは別の仕組みで、それを呼び出すことはありません。作業の分担方法は別途設計します。
捨てた下書きの変更が残る
下書きが採用されなくても、その下書きがファイルに加えた変更は自動では元に戻りません。正式に反映する前に、変更箇所を人が確認する運用が必要です。
使われるAIは入れ替わる
候補のAIと進め方は、GitHubの評価と提供状況に応じて変わります。特定のAIを前提にした手順書は作れないため、結果の確認方法で品質を担保します。
一度に扱える量の上限
一度に読み込める情報量(コンテキストウィンドウ)は、候補のAIのうち最も小さいものに合わせて表示されます。大量の資料を一度に渡す使い方には向きません。
Copilot全体の利用ルール(操作の記録、AIに読ませないファイルの指定、外部ツールとの接続の許可、AIに任せる権限の範囲)は、GitHub Advanced SecurityやAgentic Securityと合わせて設計します。
07/使いどころ
開発工程別の使いどころ:効果が出やすい作業と、決めておくこと
GitHubは、試験公開の時点で「範囲がはっきりしていて、1回の依頼で任せられる、まとまった作業」から試すよう案内していました。正式版でも、高レベルの典型例は「原因の分かりにくい不具合の修正」や「複数のファイルにまたがる変更」です。逆に、何を作るか自体があいまいな依頼は、どの進め方でも結果が安定しません。効果は、作るものと合格の基準がどれだけ明確かで決まります。
工程期待できること運用で決めること
要件・設計の整理
仕様書や作業指示の下書きで、別のAIによる見直しが抜け漏れの指摘に役立ちます。
何を合格とするか(受け入れ条件)を先に文書にする。あいまいな依頼は、進め方に関係なく結果が安定しない。
実装(新規・機能追加)
難しめの実装は高レベル、簡単な変更は標準レベルと分けることで、費用を作業に見合った形にできます。
工程ごとの初期の努力レベル。複数のファイルにまたがる変更は、変更してよい範囲のルールとセットにする。
不具合の修正
安価なAIの解決策が通らなければ高性能なAIに引き継がれるため、難しさを事前に見極める必要がありません。
捨てた下書きの変更が残る可能性に備え、反映前の変更箇所の確認とテストを必須にする。
レビュー・テスト
別の会社のAIを含む確認役が、書き換えずに読むだけで指摘します。人のレビューを置き換えるものではありません。
AIの見直しと人のレビューの分担。設計書や顧客向けの成果物は人のレビューを前提にする。
古いシステムの移行
読み解き・書き換え・テスト作成で難しさが大きく異なり、AIの自動の割り振りが効きやすい領域です。
AIを固定した場合との比較検証に向く。移行のルールと、書き換え結果の確かめ方を先に決める。
工程ごとの整理は当社の見解です。古いシステムの移行では、既存プログラムの読み解き、新しい言語への書き換え、動作確認のテスト作成で難しさが大きく異なるため、AIを固定した場合とCopilot Fusionを比べる検証に向く領域と考えています(SyncLect Agentic Migration Harness)。
08/当社の支援内容
自動振り分けの前後を設計する:仕様・方針・計測・定着の4領域
モデルの振り分けはCopilot Fusionが担います。成果を分けるのは、その前後です。何を作るかと合否基準を明確にする仕様、どのモデルを許すかの方針、品質とコストを揃えて測る計測、使い分けを個人任せにしない定着です。当社は、GitHub認定パートナーとして、Copilot Fusionを「AI駆動開発の品質・コスト・ガバナンスの最適化」の一要素として組み込みます。
支援の流れ
支援 1仕様駆動の開発標準要件・設計→Issue分解→実装→レビュー観点
→
支援 2モデル方針と統制許可モデル・既定の努力レベル・監査
→
支援 3利用状況と費用の計測品質・手戻り・所要時間・AIクレジット
→
支援 4教育と組織への定着ハンズオン・標準ルール・他部門展開
伴走体制:X-Tech FDE(現場への常駐型の
実装支援)で、貴社のチームが自ら標準と計測を更新できる状態へ移します。
支援 1
「何を作り、何をもって合格か」を明確にする開発標準
要件・設計の成果物からGitHub Issueへ分解し、Copilotによる実装、レビューとテストの観点整理までを体系化した当社の開発標準SAIDDarを適用します。Copilot FusionのCascadeやCritiqueが判定・批評する際の基準を、仕様と受け入れ条件として先に用意します。
支援 2
許可モデル・既定レベル・監査を含むモデル方針
Claude、OpenAIなど複数モデルの使い分けと、高性能モデルと軽量モデルによるコスト効率化を、アクセス管理・変更管理・監査証跡を備えた統制環境で運用してきた知見をもとに、Copilot Fusionの許可モデル、適用する工程、既定の努力レベルを決めます。単一モデルの障害や仕様変更時に開発を止めない冗長性も、方針に含めます。
支援 3
Copilot Metrics APIとFabricによる利用状況・費用の可視化
Copilotの利用状況データ(Copilot Metrics API)をMicrosoft Fabricへ取り込み、モデル別の消費量と請求額、料金改定の影響を月次で見られる形にします。Copilot Fusionと固定モデルを、品質・手戻り・所要時間・AIクレジットの同じ指標で比べられる土台になります。
支援 4
ハンズオンから他部門展開までの定着支援
コード補完、Chat、MCP、Coding Agent、モデル選択を扱う顧客向けハンズオンに、Copilot Fusionの努力レベルの使い分けを加えます。導入・オンボーディング、定着支援、効果測定、CCoE(クラウド推進組織)の育成、他部門への展開までをメニュー化しています。
09/取り組み事例
GitHub Copilotを用いた商用開発と、マルチモデル運用の実績
Copilot Fusionを導入したあとの評価対象となる、実際の開発プロセスと統制の蓄積です。いずれもCopilot Fusionの効果を示す数値ではなく、GitHub Copilotとマルチモデル活用を前提とした開発体制の実績です。
AI駆動開発の顧客適用
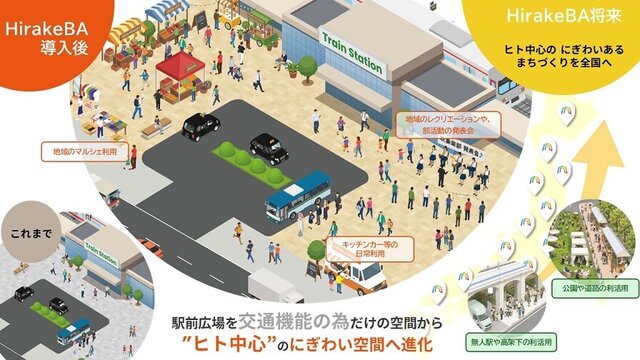
JR東日本「HirakeBA」をAI駆動開発で支援
設計・実装・レビューの全工程にAI駆動開発を適用し、仕様駆動と変更範囲の管理で品質を担保。同一スコープ・同等品質を前提とした当社試算で、開発工数約92%削減、開発期間約47%短縮。
GitHub認定パートナー
Agentic DevOpsソリューションの提供
GitHubチャネルパートナーとして、GitHub Copilot Coding Agentを用いたAI駆動開発、マイグレーションAIエージェント、Agent Opsの伴走支援をエンタープライズ企業へ提供しています。
10/検証の進め方
固定モデルとCopilot Fusionの比較検証:同じタスクで品質・手戻り・時間・クレジットを揃える
GitHubが公表する数値は、GitHubのベンチマークと顧客の環境での結果です。貴社で意思決定に使う根拠は、貴社の実際のタスクで取ります。同じ仕様のタスクを、固定モデルとCopilot Fusion(努力レベル別)で実行し、4つの指標を同じ条件で記録します。
検証のSTEP
1
対象タスクと受け入れ条件を決める
不具合修正、機能追加、移行の変換など、範囲が明確なタスクを工程ごとに数件ずつ選び、合格条件を文書化します。
2
許可モデルと比較条件を固定する
企業のモデルポリシーに沿って候補モデルを設定し、固定モデル、Fusion Standard、Fusion Highの各条件で同じ依頼文を使います。
3
4つの指標を同じ形式で記録する
品質、手戻り、完了時間、AIクレジット消費を、Copilot Metrics APIの利用データと合わせてFabric上に集約します。
4
工程別の運用ルールに落とす
結果から、工程別の既定の努力レベル、Copilot Fusionを使わない工程、差分確認の手順を決め、チームの標準として配ります。
記録する4つの指標
品質(受け入れ条件の合格率)
手戻り(レビュー指摘・再依頼回数)
完了時間
AIクレジット消費
検証で出る成果物
工程別の推奨努力レベル、許可モデルの方針案、月次の計測ダッシュボード、チーム向けの使い分けガイドです。検証の結果は、そのまま本番の運用ルールになります。
短期間で最初の検証を始めたい場合は、HWS Agent Camp(約2週間の事前準備と2日間の集中開発)の枠組みで、対象タスクの選定から比較の記録までを行います。
11/関連ソリューション

GitHubを、
開発の中心に。
GitHubソリューション. GitHub認定パートナーとして、Agentic DevOpsを含むGitHub活用の設計・導入・定着を支援します。

AI駆動開発を、
組織標準にする。
AI駆動開発(SAIDDar). 要件・設計からIssue分解、実装、レビュー・テスト観点までを、人のレビューを前提に組織標準へ体系化します。

Copilotの利用状況を、
Fabricで見える化。
Microsoft Fabric. Copilot Metrics APIの利用データを取り込み、モデル別の消費と費用を月次で把握できる基盤を構築します。

最初の検証を、
2日間で形にする。
HWS Agent Camp. 専門エンジニアが伴走する2日間の集中開発。約2週間の事前準備のうえで、対象タスクの選定から比較の記録までを行います。
12/よくあるご質問
Q. GitHub Copilot Fusion(コパイロット フュージョン)とは何ですか。
A. AIがプログラム開発を手伝うサービス「GitHub Copilot」の機能で、作業ごとにどのAIを使い、1つで済ませるか複数で確認し合うかを自動で決めます。利用者はAIの名前ではなく、努力レベル(標準・高・最大)を選びます。2026年10月28日に正式に提供が始まりました。
Q. 新しいAIモデルですか。
A. いいえ。既存のモデル(Anthropic、OpenAIなど)を選んで組み合わせる仕組みです。Copilot Fusion自体がモデルとして回答を生成することはありません。
Q. Auto(自動モデル選択)やHydraFusionとは何が違いますか。
A. Autoは1つの依頼に1つのモデルを選ぶ機能、HydraFusionは複数モデルを組み合わせる研究プレビューでした。Copilot Fusionはこの2つを統合した正式機能で、以前にAutoやHydraFusionを選んでいた利用者は、対応する努力レベルへ自動で移行しています。
Q. 費用は上がりますか。
A. Copilot Fusion自体の追加料金はなく、実際に使われた各AIの通常の単価で課金されます。HighとMaxは1つのタスクに複数のモデルを使うことがあるため、Standardより多くのAIクレジットを消費する場合があります。2026年11月30日まで、有料プランでは利用時のモデル費用が30%割引されます。
Q. 会社が許可していないモデルが使われることはありますか。
A. ありません。企業・組織のモデルポリシーで有効なモデルの範囲でしか選ばれず、管理者はCopilot Fusionの候補からだけ特定のモデルを外すこともできます。許可モデルがなければ、Copilot Fusionはモデル一覧に表示されません。
Q. どのツールで使えますか。
A. Visual Studio Code、GitHub Copilotアプリ、GitHub Copilot CLI、JetBrains IDEで、すべてのCopilotプランで利用できます。HighとMaxは対応プラン(Pro+、Max、Business、Enterpriseなど)に限られます。
Q. どの作業から試すべきですか。
A. 範囲が明確で、合否を判断できるまとまったコーディング作業(複雑な不具合の修正、複数ファイルにまたがる変更)が向いています。何を作るか自体が曖昧な依頼は、どのパターンでも結果が安定しません。
Q. GitHubが公表する「約半分の費用」は、自社でも再現できますか。
A. 公表値はGitHubのベンチマークと顧客環境での結果で、タスクの性質やモデルポリシーで変わります。当社は、同じ仕様のタスクを固定モデルとCopilot Fusionで実行し、品質・手戻り・完了時間・AIクレジットを同じ条件で記録する比較検証をおすすめしています。
Q. 貴社はCopilot Fusionの導入を支援できますか。
A. はい。GitHub認定パートナーとして、仕様駆動の開発標準(SAIDDar)、許可モデルと既定レベルの方針、Copilot Metrics APIとFabricによる計測、ハンズオンからの定着までを支援します。自動振り分けは製品が担い、当社はその前後の設計と運用を担います。
Q. 人によるレビューは不要になりますか。
A. なりません。Critiqueの批評役はAIによる確認で、人のレビューを置き換えるものではありません。GitHub自身も、コミット前に変更を確認するよう案内しています。当社の開発標準でも、上流文書と顧客向け成果物は人のレビューを前提にします。
GitHub Copilot Fusionの活用についてのご相談
対象工程の選定、許可モデルと努力レベルの方針、固定モデルとの比較検証、計測ダッシュボード、チームへの定着まで、貴社の状況に合わせてご提案します。
お問い合わせ