VLA(Vision-Language-Action)
ロボットの把持・作業をAIで教える実装支援
VLA(視覚・言語・
当社は人の
01/概要
映像と言葉の指示からロボットの動作を直接出すAIモデル
VLA(Vision-Language-Action、
近い技術との
- 動かし方を
1つずつプログラムせず、 人の実演から 教えられる (模倣学習) - 置き方や見た
目が多少違っても、 学んだ動きを 応用しやすい (汎化性能) - 品種や作業を
増やすときに、 実演データの 追加で対応しやすい - 言葉で作業を
指示でき、 現場の人にも 扱いを説明しやすい
画像解析AI・VLM・VLAの違い
画像解析AI+プログラム
VLM(視覚言語モデル)
VLA(視覚・言語・行動モデル)
02/注目される背景
人手不足・少量多品種化と現場データ活用を掲げる国の方針
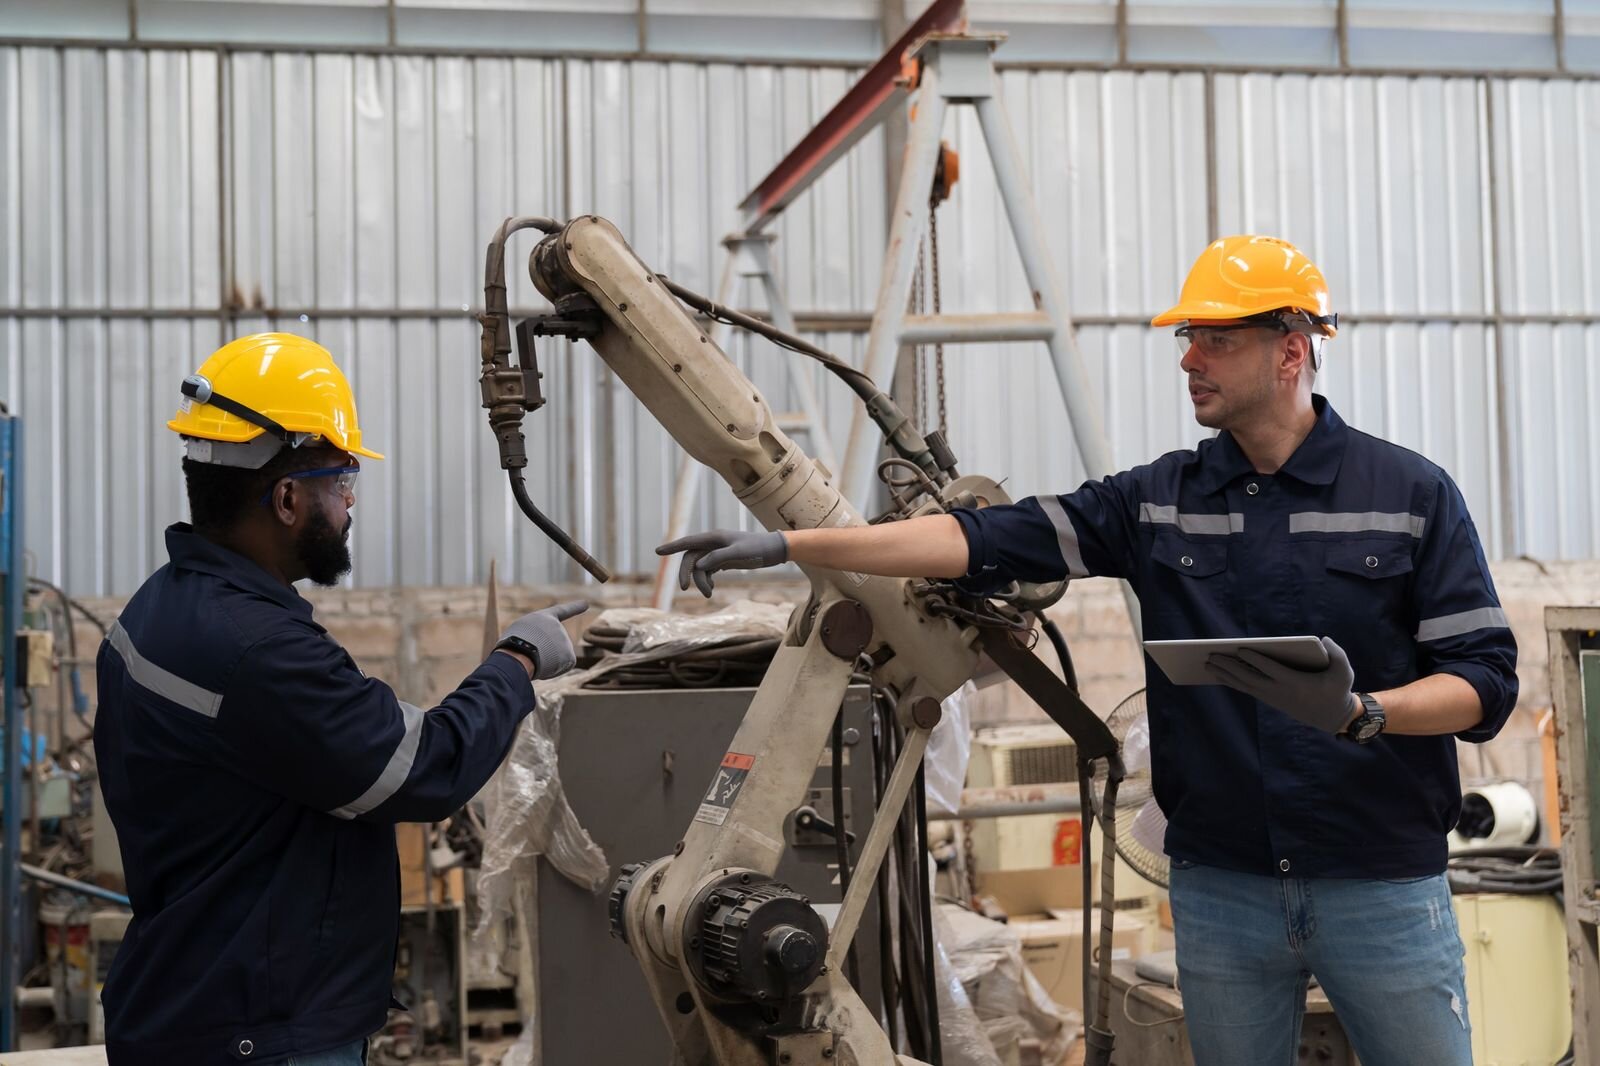
製造・物流などの
VLAという言葉が広まった経緯
VLAは言葉と
こうした基盤モデルは
03/仕組み
実演データの収集から実機の動作までの6つの工程
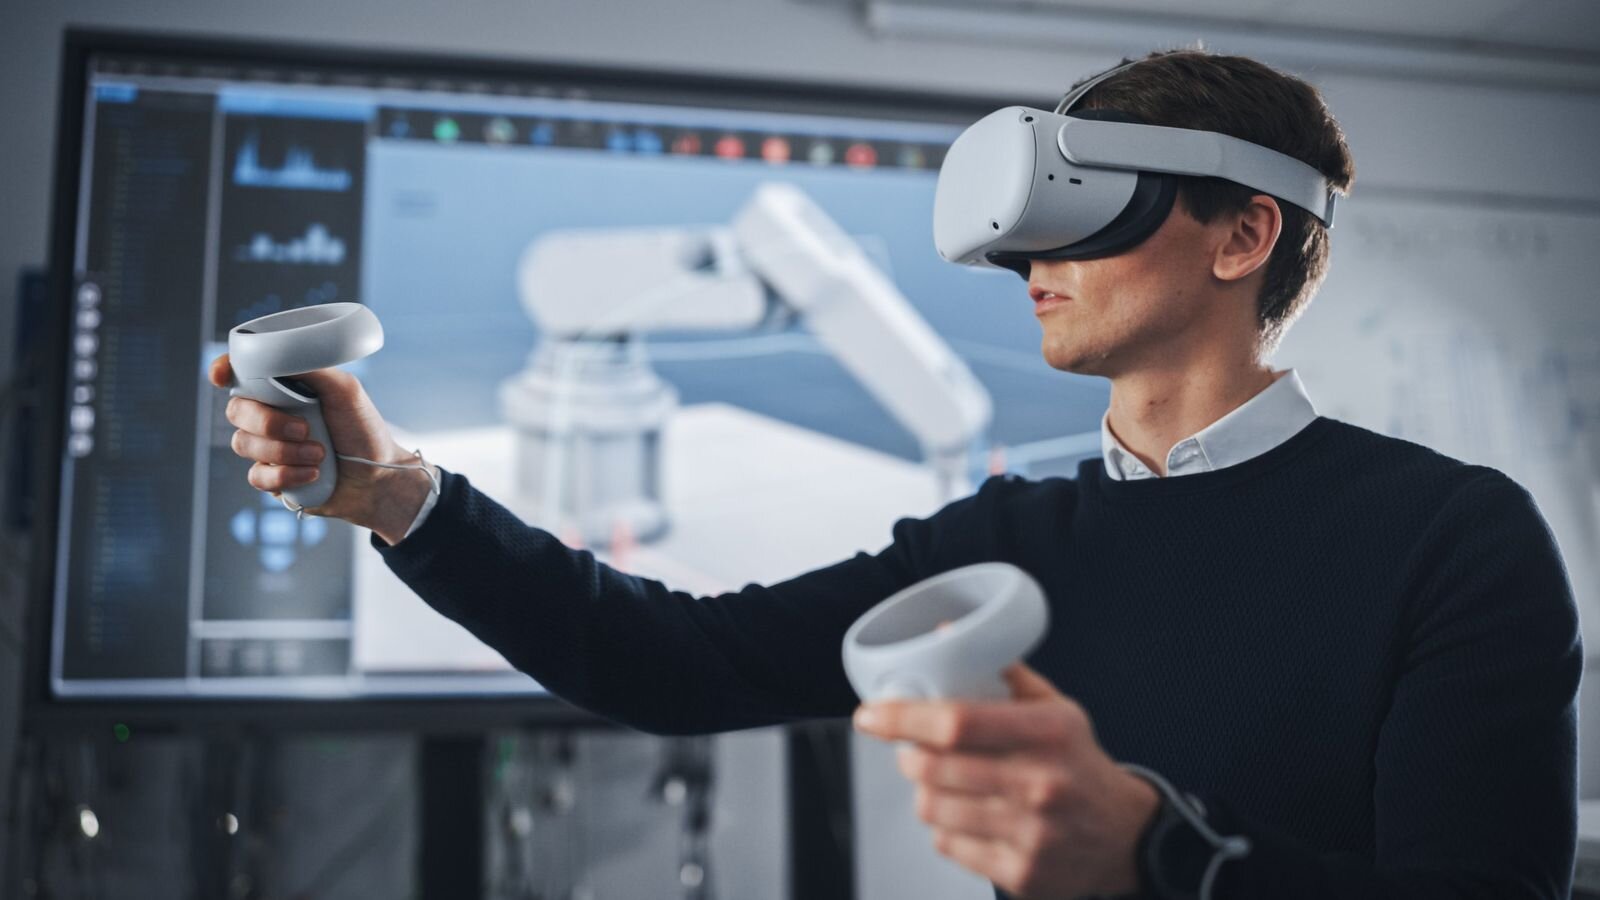
VLAを現場で
AIに任せる部分と従来の制御で守る部分
すべての動作を
アームの移動:従来の制御
目的の位置まで
ハンドの把持:VLA
対象物に触れて、
安全の見張り:ルール
速度の上限、
04/当社の支援内容
適用業務の設計からデータ収集・追加学習・実機適合まで
当社は独自の
支援メニュー
VLAの実装を支える基盤の構成
05/当社の特長
既存のVLAをお客様の機体・作業・データに合わせる実装力
ここではVLAと
人の動作をデータにし、実機の動きまでつなぐ
遠隔操作に
AIと従来の制御を組み合わせる設計
アームの移動は
評価と安全の知見を、提案判断に変える
VLAの比較・評価の
技術解説:VLAの安全は
06/取り組み事例
精密部品メーカーの多指ロボットハンド開発: VLAによる実機把持
精密部品メーカーの
07/顧客価値
品種追加の手間・熟練者の動き・検証の安全性への効果
立場ごとの価値
経営・事業責任者
人手不足の
生産技術
動作のプログラムに
AI・DX推進
実演データと
安全担当
AIに任せる
IT・OT担当
クラウドでの
現場の作業者
熟練者のやり方が、
08/ユースケース・適性
多品種の把持・持ち直し・取り回しが要る作業
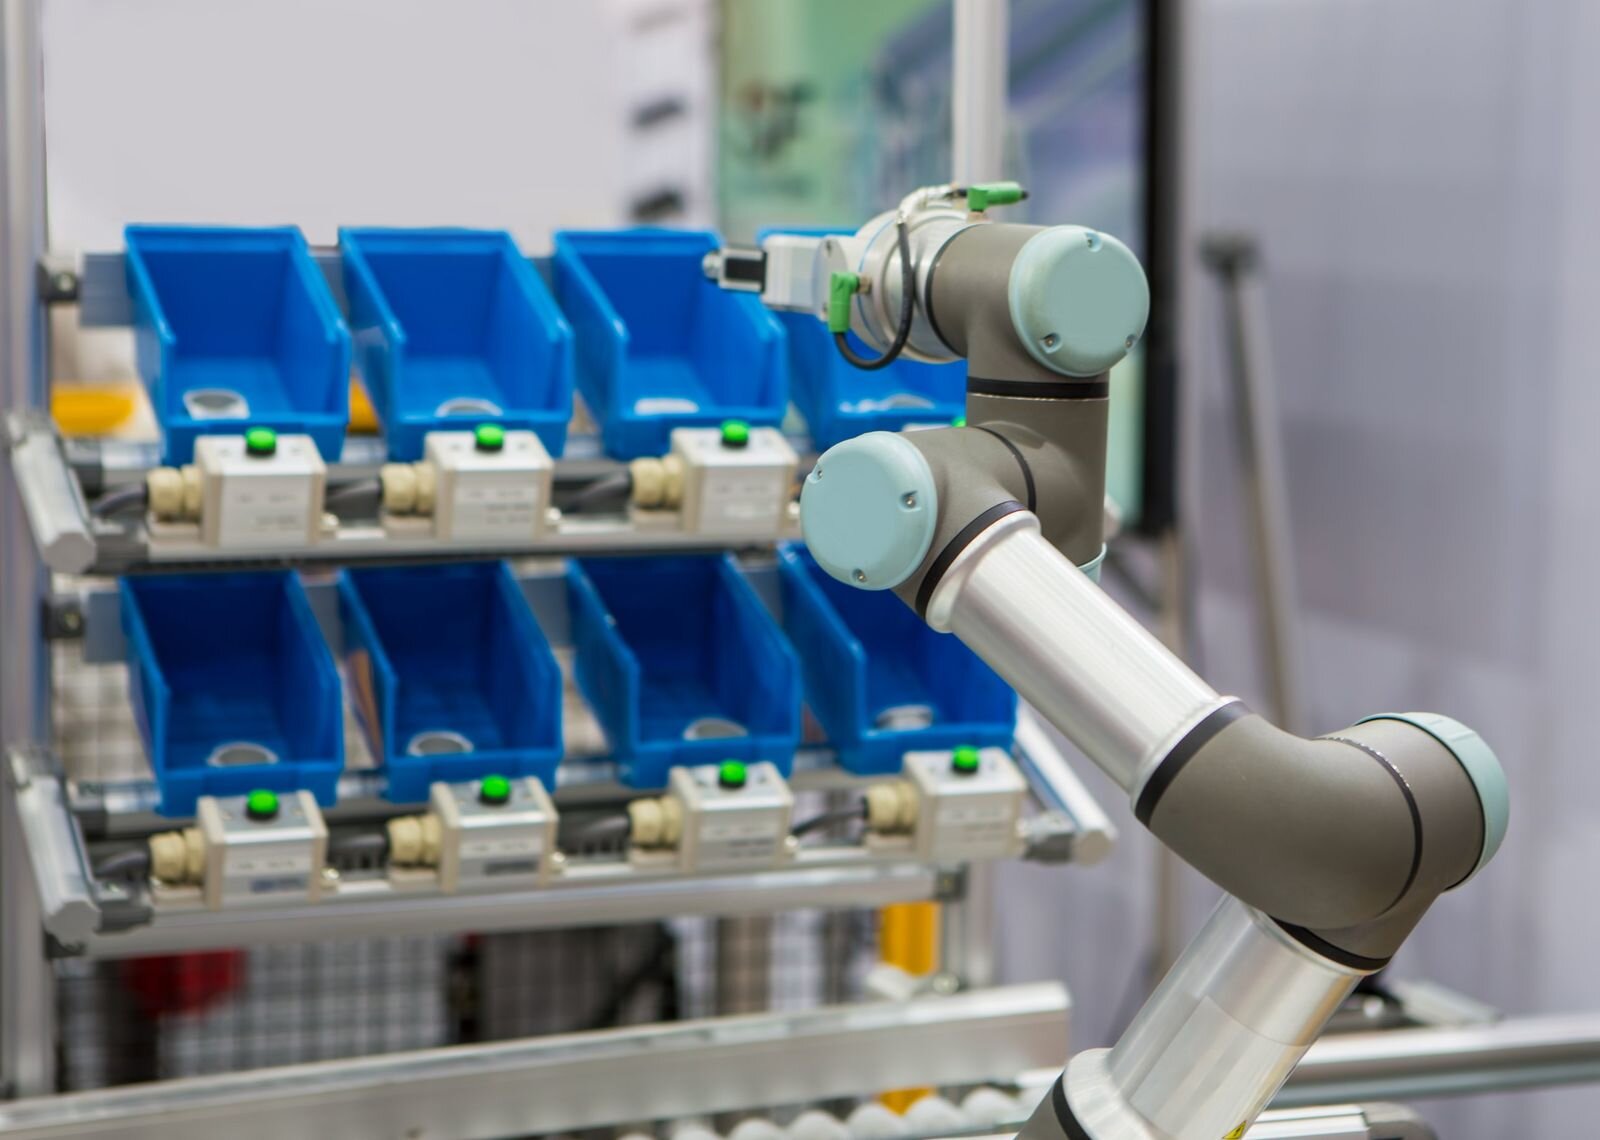
多品種のピッキング
形や大きさが
持ち直し・向きの調整
つかんだ物の
組立・検査の前段の取り回し
組立や検査の
物流倉庫の仕分け
置き方がばらつく
研究開発・試作
新しいロボットハンドの
熟練作業の記録
人の手つきを
VLA導入の適性チェック
適合するお客様
扱う品種が
適合しにくいお客様
品種が少なく、
09/想定ROI
品種追加のたびにかかる立ち上げ費用の比較
従来の画像解析AIと
10/導入ステップ
適用業務の診断から運用と展開までの5ステップ
11/他の手段との違い
ティーチング・画像解析AI・VLAの選び方
VLAはどの
12/ガバナンス・安全
AIに任せる範囲と人とルールで守る範囲を分ける設計
動作の安全性
速度の上限、
責任分担と記録
生産技術・安全担当・AI
データの扱い
実演の映像には、
全社のAI活用との整合
フィジカルAIも
13/当社について
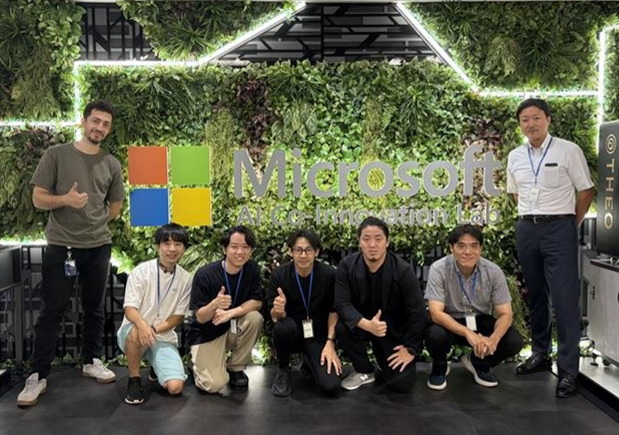
Microsoft AI Innovation Partner of the Year 2024 受賞
Microsoftの


SyncLect Data Intelligence
作業標準や
14/はじめ方
1つの作業を対象にした適用業務の診断
最初はロボット化したい
製造業の現場課題全体から
15/関連ソリューション
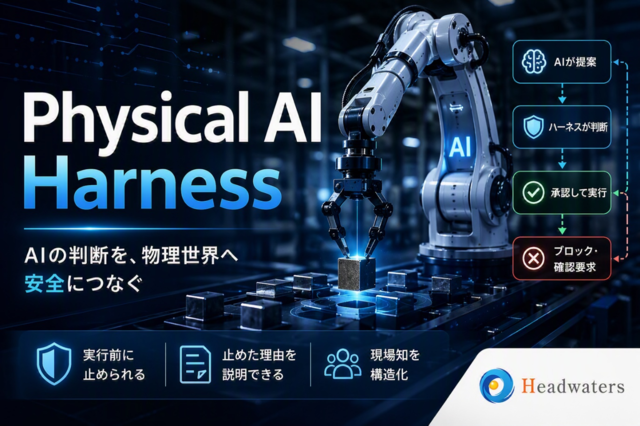
Physical AI Harness
AIの判断を
AIが出した

SyncLect Data Intelligence
現場の暗黙知を

Microsoft Foundry
AIモデルの