HOME/ビジネス/AIソリューション/生成AI/ローカルLLM
LOCAL LLM / SLM / EDGE AI

ローカルLLM
端末・社内サーバーで動かす業務特化AIの設計・実装支援

ローカルLLMは生成AIを社外のクラウドに送らず、端末や自社のサーバー(オンプレミス・エッジ)の中で動かす使い方です。
当社はSLMの量子化・ファインチューニングから、オフライン業務アプリや製品への組み込み、クラウドとの使い分けまでを設計・実装します。

01/概要

ローカルLLMとは:データを社外に出さず、端末や社内サーバーの中で動かす生成AI

ローカルLLM(ローカル・エルエルエム)とは、文章を理解して作る生成AI(大規模言語モデル)や、それを小さくしたSLM(小規模言語モデル)を、社外のクラウドに送らず、利用者の端末や自社のサーバーの中で動かす使い方です。自社で管理する環境で動かすため、オンプレミス型・エッジ型のAIとも呼ばれ、プライベートAIの一つの形です。

入力した文章や音声が社外に出ないため、個人情報や機密情報を含む業務にも使いやすくなります。通信がつながらない場所でも動き、使った量に応じた課金(トークン課金)もありません。一方で、大きなモデルが必要な高度な作業にはクラウドの生成AIが向くため、業務ごとに使い分けるのが現実的です。

AIを動かす場所の3つの選択肢
クラウドで動かす
社員のPC・アプリ↓ インターネット経由クラウドのAI
大きなモデルを多人数で使う。Microsoft Foundry、Microsoft 365 Copilotなど
社内サーバーで動かす
複数のPC・アプリ↓ 社内ネットワーク自社管理のAIサーバー
オンプレミスや閉域の環境。多人数の同時利用や、社内データとの連携に向く
端末の中で動かす
社員のPC・タブレット・車載機器↓ 端末の中で完結端末内のSLM
エッジ型。データを外に出さず、オフラインでも動く。1人1台や製品への組み込みに向く
濃い水色の2つがローカルLLMです。当社が整理した区分です

ローカルLLMを使うメリット

機密データを手元に置いたまま使える契約書、査定の資料、個人情報を含む記録など、社外に出しにくい情報を扱う業務でも、AIの利用を検討できます。
通信がない場所でも使える機内、工場の現場、移動中の車両やバイクなど、通信が不安定な場所でも、その場で答えや下書きを得られます。
小さく軽いモデルで、費用と待ち時間を抑えるモデルを小さくして端末に収めるため、使った量に応じた費用が増えにくく、通信待ちもありません。
自社の業務に合わせて調整できる報告書の書き方や社内用語を追加で学習させ、特定の業務に強いモデルにできます。

02/注目される背景

機密情報をどこでAIに扱わせるか。判断を求められる場面が増えている
暗いサーバールームでノートPCを操作する技術者
写真はイメージです

生成AIの業務利用が広がるにつれ、「どのデータをAIに入れてよいか」「AIをどこで動かすか」を、企業自身が決める場面が増えています。国の文書もAIに個人情報や機密情報を入力する際の注意を、AIを使う側の責任として示しています。

次の3つは、AIに入れるデータの扱いについて、各発行主体が示している内容です。

個人情報保護委員会|2023年6月生成AIサービスの利用に関する注意喚起等個人情報を含む指示文を生成AIサービスに入力するときは、利用目的の範囲内かを確認すること、入力した情報が応答以外の目的(機械学習など)に使われないかを事前に確認することを求めています。
総務省・経済産業省|2025年3月AI事業者ガイドライン(第1.1版)AIを使う事業者に対し、個人情報や機密情報をAIのシステム・サービスへ不適切に入力しないよう注意を払うことを求めています。
Microsoft|2026年8月更新Foundry Localとは(Microsoft Learn)端末の中で完全に動くローカルAIの仕組みとして、オフラインで動くこと、データが端末から離れないこと、使った量に応じた費用がかからないことを説明しています。
出典は各リンク先の公式文書です。内容は記載の時点のもので、最新の内容は各ページでご確認ください。

データを社外に出さずにAIを使う方法として、端末や社内サーバーの中でモデルを動かすローカルLLMが選択肢に入ってきました。モデルの小型化と、PCやスマートフォンに載るAI処理用の部品(NPU・GPU)の普及により、端末の中で動かすAIは実験段階から、業務アプリに組み込める段階に移っています。

03/仕組み

ローカルLLMを業務で動かすための4つの工夫

電子基板に載った半導体チップの拡大写真
写真はイメージです

次の図は大きなAIモデルを端末や社内サーバーで業務に使える状態にするまでの流れを示したものです。ローカルLLMは動かすだけでなく、小さくする、業務に合わせる、端末に合わせる、データやシステムにつなぐ、の4つを組み合わせて成り立ちます。

1
モデルを小さくする大きなAIモデルを、精度をできるだけ保ったまま小さく軽くします。端末のメモリや処理能力に収めるための工夫で、量子化と呼ばれます。
量子化Microsoft Olive
2
業務に合わせて覚えさせる自社の報告書や用語を追加で学習させ、特定の業務に強いモデルにします。モデル全体ではなく一部だけを調整するLoRA・QLoRAという方法で、学習の負担を抑えます。
ファインチューニングLoRAQLoRA
3
端末に合わせて動かすPC、タブレット、車載機器などの部品(CPU・GPU・NPU)に合わせて動かし方を調整し、アプリに組み込みます。
ONNX RuntimeDirectMLCUDAFoundry Local
4
データやシステムとつなぐ社内データの検索(RAG)や、業務システムの操作(MCP)とつなぎ、答えるだけでなく、レポートの作成まで進められるようにします。
RAGMCP

端末のAI処理の基盤はMicrosoftのFoundry Localのように製品として提供されるものも増えています。どの基盤を使うかは機器、利用人数、既存のMicrosoft環境に合わせて選びます。

04/使いどころ

ローカルLLMが向く4つの業務場面

機内でタブレットを見ながら業務を確認する客室乗務員
写真はイメージです

次の4つの場面はクラウドのAIでは難しく、ローカルLLMが力を発揮しやすい場面です。当社が実際に取り組んだ内容も、この4つのどれかに入ります。

例:機内の引き継ぎレポート、二輪車の音声操作通信が不安定・つながらない現場機内、工場、移動中の車両やバイクなど。通信を前提にしないため、その場で下書きや応答を得られます。
例:保険の引受査定、契約文書の確認社外に出しにくい文書を扱う業務契約、査定、個人情報を含む記録の要約や下書き。データを端末や社内に残したまま使えます。
例:車載・二輪車、PC内のAIチャット製品やアプリへの組み込み機器やアプリの機能として、AIを標準で載せる場面。通信費用や応答の遅れに左右されない体験を作れます。
例:現場の日報、設備保全の報告書毎日大量に繰り返す定型の処理要約、分類、定型のレポート作成など。使った量に応じて費用が増える料金体系から、端末側に移す検討ができます。

高度な判断や分析、最新の情報を踏まえた回答にはクラウドの生成AIが向きます。ローカルLLMとクラウドの使い分けは、他の手段との違いで整理しています。AI利用料の管理についてはAI FinOpsもご覧ください。

05/当社の支援内容

診断から運用・展開まで、4つの支援

当社はどこでAIを動かすかの診断から、モデルの調整、アプリへの組み込み、運用までを、段階に分けて支援します。

支援1 / 入口用途の診断と、動かす場所の選定データの機密度、通信環境、利用人数をもとに、端末・社内サーバー・クラウドのどれで動かすかを比較し、構成案にまとめます。完全ローカル、閉域クラウド、組み合わせの比較資料づくりも支援しています。
支援2 / 最初の1周モデルの選定と、業務への調整SLMの選定、量子化による軽量化、LoRA・QLoRAなどの追加学習、精度の評価までを進めます。
支援3 / 最初の1周アプリ・製品への組み込みオフラインで動く業務アプリや、音声操作などの製品の機能に組み込みます。RAGやMCPで、データや業務システムともつなぎます。
支援4 / 回し続ける運用・研修・更新への追随製品やモデルの更新に合わせた手順書・解説資料・ハンズオンの整備と、精度評価の継続を支援しています。
現場に入る伴走課題の発見から実装・定着まで、現場に入るエンジニアが伴走します。X-Tech FDE
全社に広げる複数の部署・用途に広げる際の方針づくりと、AI活用の定着を支援します。AI Agent CoE

06/当社の特長

当社の特長:端末・製品に組み込んだ経験と、クラウドとの使い分けの設計

端末・製品に組み込んだ実装の経験オフラインのタブレットで動く業務アプリ、二輪車のスマートフォンアプリでの音声操作、PC内で動く生成AIチャットなど、利用者の手元で動くAIを開発・検証してきました。
学習・軽量化・配布までの検証モデルを動かすだけでなく、量子化、追加学習、複数の機器での動作、エッジへの配布方法までを、パートナーと共同で検証しています。
ローカルありきにしない設計ローカルが向く業務と、クラウドが向く業務を分けて提案します。完全ローカル、閉域クラウド、組み合わせの比較も行っています。

いずれも下の取り組み事例で、共同実証・先行開発・検証として取り組んだ内容を紹介しています。

07/取り組み事例

取り組み事例:オフライン業務アプリから、製品・PCへの組み込みまで
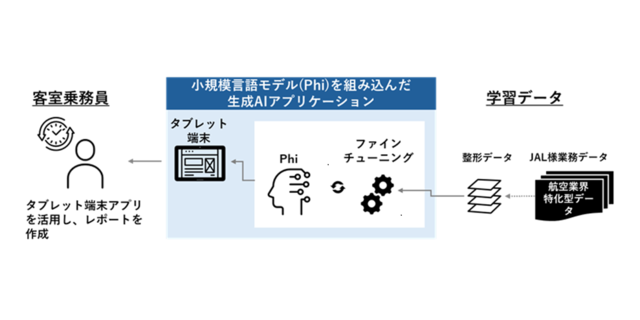
JAL:機内のオフライン環境で、引き継ぎレポートを作成

JAL:機内のオフライン環境で、引き継ぎレポートを作成

2025年3月に発表した、富士通との共同実証です。客室乗務員がタブレットにチャット形式で入力すると、引き継ぎレポートが作られます。当社はオフラインで動くアプリの開発、量子化によるタブレット上での最適化、ワークフロー分析からPoC・評価までの伴走、ファインチューニング環境の構築を担当しました。業務向けの追加学習は富士通が実施しています。既存のアプリと比べて、作業時間と修正の発生率が下がることを確認しています。

発表を見る →

東京エレクトロン デバイス:学習・軽量化・配布までの共同検証

東京エレクトロン デバイス:学習・軽量化・配布までの共同検証

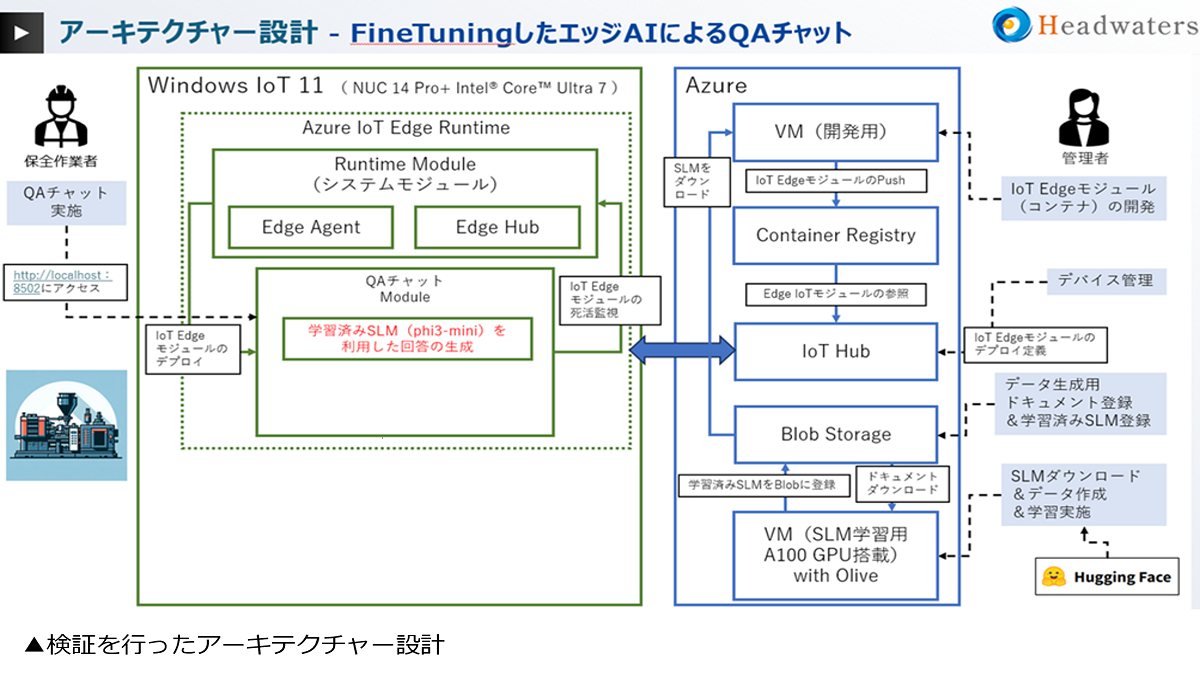
2025年2月に発表した共同検証です。Phiモデルを中心に、Microsoft Oliveによる量子化とLoRA・QLoRAでの追加学習、Azure IoT Edgeでの配布、DirectML・CUDA・ONNX Runtimeによる複数の機器での動作を検証し、「エッジAIとしてのSLM展開」の検証ガイドラインにまとめました。

発表を見る →

パイオニア:二輪車の音声操作に、端末の中で動くSLMを実装検証

パイオニア:二輪車の音声操作に、端末の中で動くSLMを実装検証

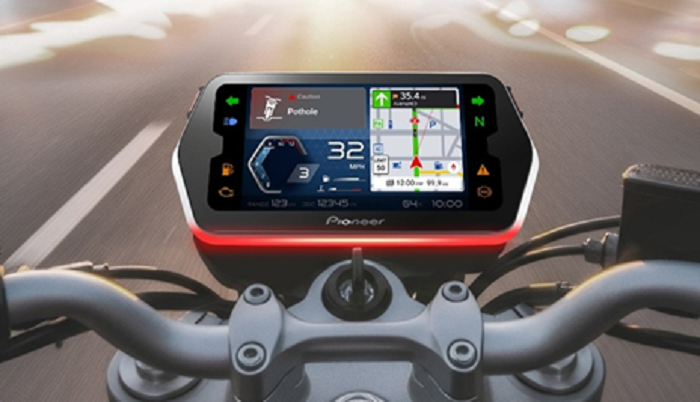
2026年3月に発表した、二輪車向けUXソリューション「Pioneer Ride Connect」の先行開発の支援です。スマートフォンアプリ上で動くSLMのAIエージェントについて、技術設計と実装を担当しました。短い発話や会話の流れにも対応し、大規模なクラウドや安定した通信環境に頼らない構成です。CES 2026で展示されました。

発表を見る →

AI PC・Windows:PCの中で動くローカルAIの展示と登壇

AI PC・Windows:PCの中で動くローカルAIの展示と登壇

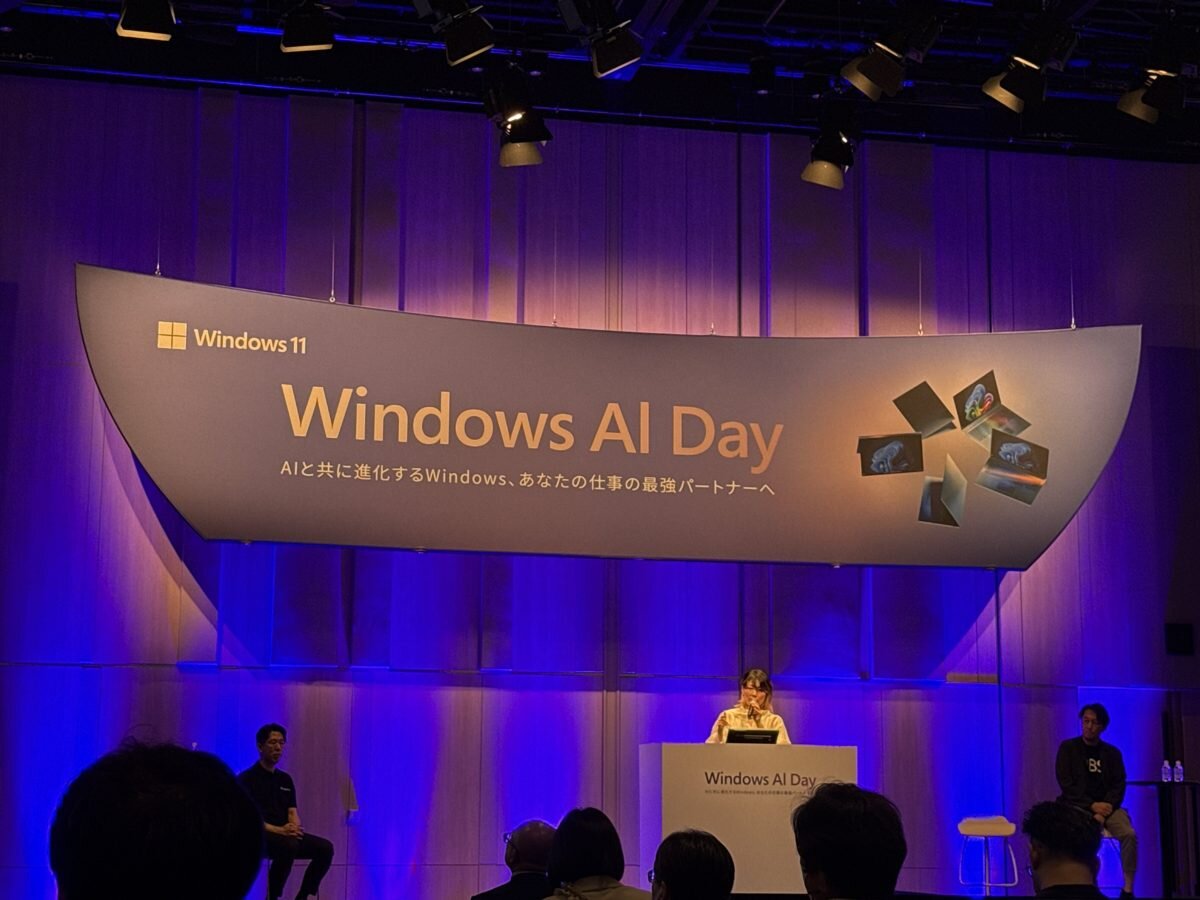
2026年4月のNECパーソナルコンピュータ主催「AI×PC DAY 2026」で、ローカルSLMで動くPC内の生成AIチャット基盤を展示し、通信が不安定な現場向けの保険の引受査定AIエージェントを紹介しました。6月のWindows AI Day Osakaでは、NPUを活用したローカルAIの可能性を紹介しています。

AI×PC DAY 2026 → Windows AI Day Osaka →

検討・設計を進めている取り組み

開発事例製造業の設備保全:オフラインのレポート作成アプリ設備の稼働データと保全の履歴をもとに、自然な文章の指示から保全レポートを作るアプリを開発しました。通信がなくても動き、テンプレートの呼び出しやコメントの追記もできます。PCのCPU・GPU・NPUに対応しています。
技術支援機械メーカー:現場のAIの学習・評価を技術支援工場の監視、組立、会話AIの品質向上を対象に、学習環境、エッジへの組み込み、データの選び方、精度の評価、運用試験の進め方を整理し、技術支援として提案しています。
構成の比較提案製造業の現場日報:音声入力の構成比較閉域網のクラウド、完全ローカル、音声認識だけ手元で処理する組み合わせの3案を、応答性、拠点展開、追加学習、運用保守、オフライン対応で比較し、方針を提案しています。

08/顧客価値

顧客価値:立場ごとの課題と、ローカルLLMで変わること

経営・事業の責任者AIを使いたいが、機密データは社外に出せない。→ 出せないデータを使う業務でも、AI活用の検討を進められる
情報システム・セキュリティの担当入力したデータがどこで処理されるのか分からない。→ データの置き場所と利用範囲を、自社で決められる
現場の担当者機内や工場では通信が不安定で、AIが使えない。→ 通信がなくても、その場で下書きや応答を得られる
製品・サービスの企画担当AIを製品に載せたいが、通信の費用と遅れが心配。→ クラウドの通信に左右されない体験を、製品に組み込める

09/想定ROI

想定ROI:削減できる時間の試算

次の図は、業務ごとに、1か月あたりの削減時間を比べたものです。棒が長いほど、削減できる時間が大きい業務です。

現場の報告書作成(オフライン端末)
月に約333時間
時間単価4,000円で約133万円。前提:100人が1日1件作成。1件あたり10分短縮。月20日稼働
社内ナレッジの検索と一次回答
月に約600時間
時間単価4,000円で約240万円。前提:200人が1日3回利用。1回あたり3分短縮。月20日稼働
機密文書の要約(契約・査定)
月に約250時間
時間単価4,000円で約100万円。前提:30人が1日5件処理。1件あたり5分短縮。月20日稼働
合計 月に約1,180時間時間単価4,000円で、月に約470万円相当
上記は前提を置いた試算で、実績値ではありません。機器の費用、開発・運用の費用は含みません。

削減率や回収期間は、業務や環境によって変わるため、一律にはお約束しません。まず現行の作業時間を測る小さな検証から始め、数字で判断できる状態にします。

10/導入ステップ

導入ステップ:用途の整理から、運用・展開まで

STEP 1用途と条件の整理ローカルで動かしたい業務を選び、データの機密度、通信環境、利用人数、使う機器を整理します。
STEP 2動かす場所の選定端末、社内サーバー、クラウドを比較し、組み合わせを含む構成案を決めます。
STEP 3モデルの選定と小さな検証モデルを選び、量子化と追加学習を試して、精度と速度を確かめます(PoC)。
STEP 4アプリへの実装業務アプリや製品に組み込み、データやシステムとつなぎます。
STEP 5運用・更新・展開更新への追随、精度の評価、手順書・研修の整備を行い、対象を広げます。

11/他の手段との違い

他の手段との違い:データの置き場所・通信環境・利用人数で選び分ける

次の4つの問いに順に答えると、向く手段が決まります。ローカルLLMが常に最適とは限らないため、クラウドの生成AIとの組み合わせも含めて整理します。

問い1 入力するデータを、社外のクラウドに出してよいですか。
出してよいクラウドのAIが使えます。Microsoft CopilotやCopilot Studio、Microsoft Foundryなど。問い2へ
出せない・出したくないローカルLLM(端末または社内サーバー)が候補です。問い3へ
問い2 業務の場所で、通信は安定してつながりますか。
つながる手軽さと精度の面で、クラウドのAIが向きます。
途切れる・つながらない端末の中で動くローカルLLMが向きます。問い3へ
問い3 同時に使う人数は多いですか。
多い(部署・拠点単位)社内サーバーで動かす構成が向きます。
1人1台・製品への組み込み端末の中で動かす構成が向きます。
問い4 高度な判断や分析など、大きなモデルが必要な作業はありますか。
ある難しい作業はクラウド、現場の判断や機密データはローカル、という組み合わせにします。
ない(定型・要約・分類が中心)ローカルLLMだけで完結できる可能性があります。
完全ローカル、閉域クラウド、組み合わせの比較は、応答性、拠点展開、追加学習、運用保守、オフライン対応で行います。

12/ガバナンス・運用

ガバナンス・運用:端末に置くAIを、安全に使い続ける

オフィスで書類を見ながら確認作業をするチーム
写真はイメージです

データを手元に置けても、管理の仕組みが要らなくなるわけではありません。端末に配るモデルとアプリを、AIガバナンスの一部として管理します。

モデルの利用条件の確認公開されているモデルは、商用利用の可否や再配布の条件がモデルごとに異なります。採用前に確認し、選定の記録を残します。
端末へ配るモデル・アプリの更新管理モデルやアプリを更新したときに、どの端末が最新かを把握し、古いバージョンを使い続けないようにします。
精度の評価と見直し追加学習の前後や、モデルの入れ替え時に、業務の例題で精度を評価します。結果を記録し、見直しの基準にします。
端末に残るデータの扱い入力や出力が端末に残る場合の保存期間、持ち出し、廃棄のルールを決め、利用者に周知します。

13/当社について

当社について:Microsoftのパートナーとして、AIの設計・実装・運用を支援
Microsoft AI Innovation Partner of the Year 2024 受賞Microsoft AI Innovation Partner of the Year 2024 受賞Microsoftのパートナーとして、Azureを中心にAIの設計・実装・運用を支援しています。お知らせを見る →
AzureのAI PlatformなどのSpecialization認定AzureのAI PlatformなどのSpecialization認定AI基盤の構築と開発の生産性向上の分野で、Microsoftの専門性認定を取得しています。お知らせを見る →
X-Tech FDEによる、現場起点のAI実装X-Tech FDEによる、現場起点のAI実装現場に入り込むエンジニアが、課題の発見から実装・定着までを伴走します。X-Tech FDEを見る →

14/はじめ方

はじめ方:用途の棚卸しと、小さな試作から

まずは、ローカルで動かしたい業務を1〜2つ選び、データの機密度、通信環境、使う人数を整理します。そのうえで、クラウドとの使い分けを含む構成案と、小さな試作(PoC)の進め方を決めます。

入口 1用途の棚卸しローカルで動かしたい業務の候補を出し、データの機密度、通信環境、利用人数で優先順位をつけます。
入口 2動かす場所の比較端末、社内サーバー、クラウドの組み合わせを比べ、応答性や拠点展開、運用の負担まで含めた構成案を作ります。
入口 3小さな試作(PoC)業務の例題を使い、モデルの精度と速度を確かめます。結果をもとに、本格的に進めるかを判断します。

オフラインの現場、製品への組み込み、PC内のAIなど、取り組み事例に近いご相談から、状況に合わせて進め方をご提案します。

15/関連ソリューション

関連ソリューション

Foundry LocalFoundry Local端末の中で動くローカルAIのアプリ実装を支援します。詳しく見る →
SLM(小規模言語モデル)アプリ開発SLM(小規模言語モデル)アプリ開発軽量なモデルを業務に合わせて調整し、アプリに組み込みます。詳しく見る →
自動車・モビリティ向けAI自動車・モビリティ向けAI車載エッジAIやSDV開発、フィジカルAIの実装を支援します。詳しく見る →
フィジカルAIフィジカルAIロボットや機器など、現実の世界で動くAIの実装を支援します。詳しく見る →
X-Tech FDEX-Tech FDE現場に入るエンジニアが、課題の発見から定着まで伴走します。詳しく見る →
AI Agent CoEAI Agent CoEAI活用を全社に広げるための、方針づくりと定着を支援します。詳しく見る →

16/よくあるご質問

Q.ローカルLLMとは何ですか。
A.ローカルLLMとは、生成AI(大規模言語モデル)や、それを小さくしたSLMを、社外のクラウドに送らず、端末や自社のサーバーの中で動かす使い方です。入力したデータが社外に出ず、オフラインでも動きます。
Q.クラウドの生成AIとの違いは何ですか。
A.クラウドのAIは大きなモデルを多人数で使えますが、データを社外に送る必要があり、通信が前提です。ローカルLLMはデータを手元に置け、通信がなくても動きますが、モデルが小さい分、得意な作業が限られます。両方を組み合わせる構成も多くあります。
Q.小さなモデルで、業務に使える精度が出ますか。
A.どんな質問にも答える汎用の用途では、クラウドの大きなモデルが優れます。報告書の作成や要約など、業務を絞れば、追加学習(ファインチューニング)や社内データの検索(RAG)を組み合わせて精度を高められます。精度は業務の例題で評価して判断します。
Q.どんな機器で動かせますか。
A.PC、タブレット、スマートフォン、車載機器、社内のサーバーなどです。機器のCPU・GPU・NPUに合わせて動かし方を調整します。機器ごとの速度の差は、検証で確かめてから機器を選びます。
Q.費用はどのくらいかかりますか。
A.クラウドの生成AIのような、使った量に応じた課金は基本的にありません。一方で、機器、モデルの調整、アプリの開発、運用の費用は別にかかります。用途と台数をうかがったうえで、試算をご提案します。
Q.オンプレミス型とエッジ型の違いは何ですか。
A.オンプレミス型は自社のサーバーでAIを動かし、複数の利用者で共有する形です。エッジ型は利用者の端末や機器の中でAIを動かす形です。どちらも、データを社外に出さないローカルLLMの一種です。
Q.日本語の業務に使えますか。
A.モデルごとに、対応する言語と日本語での精度が異なります。日本語の業務の例題で評価して、モデルを選びます。
Q.どのような実績がありますか。
A.オフラインのタブレットで動く業務アプリの共同実証、二輪車の音声操作の先行開発、複数の機器での共同検証、PC内のローカルAIの展示などを公開しています。詳しくは取り組み事例をご覧ください。
Q.まず何から始めればよいですか。
A.ローカルで動かしたい業務を1〜2つ選び、データの機密度、通信環境、使う人数を整理するところからです。ご相談いただければ、小さな検証の進め方を一緒に決めます。
次のようなご相談をお待ちしています
  • 社外に出せないデータを使う業務で、AIの活用を進めたい
  • 機内・工場・移動中など、通信がない場所でAIを使いたい
  • AIを製品やアプリに組み込みたい
  • ローカルとクラウドのどちらで動かすかを決めたい
  • 量子化や追加学習を試して、精度と速度を確かめたい
お問い合わせ