01/メダリオンとは
メダリオンアーキテクチャとは:データを3段階で整えるレイクハウスの設計手法
メダリオンアーキテクチャ(Medallion Architecture)は、業務システムやファイルから集めたデータを、ブロンズ(Bronze)・シルバー(Silver)・ゴールド(Gold)の3つの層に分けて、段階的に品質を高めていく設計手法です。メダルの色になぞらえ、Bronzeは届いたままの元データ、Silverは誤りや重複を直して全社で使える形に整えたデータ、Goldは売上分析や需要予測など業務の目的ごとにまとめたデータを置きます。データが層を進むたびに、確認と加工が1回ずつ入るため、マルチホップ(多段階)アーキテクチャとも呼ばれます。
前提となる言葉を整理します。データレイクは、形式を問わずデータを大量にためておく保管場所、データウェアハウスは、集計・分析しやすい形に整えたデータの保管場所です。両者の長所を1つにまとめた基盤をレイクハウスと呼び、メダリオンアーキテクチャはその中でデータを整理する標準的な方法として、Microsoft FabricとDatabricksの公式ドキュメントで推奨されています。
データの流れ
元のデータ基幹システム、EC、センサー、業務文書
→
Bronzeそのまま保管する届いた形のまま残し、やり直しや監査の原本にする
→
Silver全社で使える形に整える誤り・重複・表記ゆれを直し、システムをまたいで統合する
→
Gold業務ごとにまとめる売上・在庫・品質など、目的別の集計と指標を用意する
→
使う場面経営ダッシュボード、分析、AIエージェント
Microsoft Learn・Databricks公式ドキュメントの記載をもとに作図
メダリオンアーキテクチャを使うメリット
部門で数字が揃う
指標の計算をGoldで一度だけ定義するため、どのレポートでも同じ数字になります。
元データを失わない
Bronzeに届いたままのデータを残すため、加工の誤りに気づいたときも、原本からやり直せます。
新しい用途にすぐ使える
全社共通のSilverがあれば、新しい分析やAI活用のたびに元データから加工し直す必要がありません。
不具合の原因を追える
層ごとに処理が分かれているため、どこで数字がずれたかを特定しやすくなります。
壊れにくいデータ
処理が途中で失敗しても、データが中途半端な状態で残らない仕組み(ACID)の上で動きます。
権限を層ごとに分けられる
原本は担当者のみ、Goldは業務部門へ、と利用者と公開範囲を層単位で管理できます。
02/注目される背景
データの用途の広がり:BIとAIで同じデータを使い回す必要性
これまでの分析基盤は、決まったレポートを作るために、元データから直接集計する作り方が中心でした。この方法では、部門や用途が増えるたびに同じ加工を一から作り直すことになり、「同じ売上なのに部門によって数字が違う」「元データの仕様が変わると、どのレポートが壊れるか分からない」といった問題が起きやすくなります。データの用途が、経営ダッシュボードから需要予測などの機械学習、さらに社内データを参照して業務を進めるAIエージェントへ広がり、1つのデータを複数の用途で使い回す前提の設計が求められるようになりました。
データ基盤の主要な製品も、この考え方を標準として採り入れています。Microsoftは、Microsoft Fabricでのレイクハウス実装の推奨構成としてメダリオンアーキテクチャを示し、層をまたぐデータの品質ルールの設定や、層ごとのデータの流れ(系譜)の表示を製品の機能として提供しています。Databricksも、企業のデータを1つの信頼できる情報源にまとめるための推奨手法と位置づけ、各層の役割と利用者を公式ドキュメントで定めています。
Microsoft Learn
Microsoft Fabricでの位置づけ
Bronzeは届いたとおりに保存して変更しない、Silverは誤りを直し形式を揃え重複を除く、Goldはレポートやダッシュボード向けに整理する、と各層の役割を示しています。元のデータを信頼できる原本として残し、確認と変換を経て分析用のデータを用意する考え方です。
Databricks Documentation
Databricksでの位置づけ
推奨される手法であり必須ではない、と明記したうえで、Goldは業務の領域ごとに作り、人事・財務・ITなど複数のGoldを持つ企業もあると説明しています。データを取り込む頻度で費用と鮮度のバランスを取ることも、設計の論点として挙げています。
03/3層の役割
ブロンズ・シルバー・ゴールドの違い:各層で行う処理と使う人
3つの層は、置くデータの品質と、使う人が異なります。現場の担当者や経営層が日常的に見るのはGoldで、Bronzeは主にデータを整える担当者が扱います。どの層にどの処理を置くかを決めておくことで、不具合の原因を探しやすく、修正の影響範囲も絞れます。
層行うこと主に使う人業務での例(小売の場合)
Bronze元データ層
システムやファイルから届いたデータを、形式を変えずに追記して保存します。誤りの修正はしません。取得元やファイル名などの記録は付けます。
データを整える担当者、監査・コンプライアンス担当
POSの売上明細、ECの注文データ、在庫システムの出力ファイルを、日付ごとにそのまま保存
Silver整備済みデータ層
誤りや欠けたデータの処理、重複の削除、表記や型の統一、システムをまたぐデータの結合を行います。明細の細かさは保ったままにします。
データを整える担当者、データ分析者、機械学習の担当者
店舗とECの顧客を同じ顧客IDにまとめ、商品コードを統一した「全チャネルの売上明細」
Gold業務活用層
業務の目的に合わせて集計し、指標を定義します。よく見る数字はあらかじめ計算しておき、表示を速くします。
業務部門、経営層、BI担当、AIエージェント
週次の店舗別売上、商品カテゴリ別の粗利、需要予測の入力データ
Goldでは、売上などの数値(ファクト)と、商品・店舗・日付などの切り口(ディメンション)を分けて持つスタースキーマという形にまとめ、Power BIなどの分析ツールから使う指標の定義(セマンティックモデル)を用意するのが一般的です。指標の計算式をGoldで一度だけ定義しておけば、どのレポートも同じ数字になります。
04/設計の進め方
メダリオン設計の5つの工程:使い道の定義から運用ルールまで
3つの保存場所を用意するだけでは、メダリオンアーキテクチャの効果は出ません。成否を分けるのはSilverの作り方です。Silverを特定のレポートに合わせて作り込むと、新しい用途が出るたびに作り直しになります。Silverは複数の用途で共通に使える形に整え、業務ごとの意味付けや集計はGoldで行う、という役割の分け方を最初に決めます。
設計の流れ
1
使い道とGoldの決定
どの業務の、どの判断に使うデータかを先に決めます。経営指標、現場の分析、AIエージェントの参照先など、Goldの使い手と必要な指標を洗い出します。
用途一覧・指標定義
2
元データの取り込み(Bronze)
基幹システム、EC、センサー、ファイルなどの取得元と、取り込む頻度を決めます。頻度は、データの鮮度と費用のバランスで選びます。
取り込み設計・処理の自動実行
3
共通データモデルの設計(Silver)
顧客・商品・取引など、全社で共通に使うデータの形を決め、表記の統一、重複の削除、システム間の対応表(マッピング)を整えます。
データモデル定義書・マッピング仕様書
4
業務向けモデルとテスト(Gold)
集計と指標を作り、既存レポートの数値と突き合わせて正しさを確かめます。正常なケース、異常なケース、やり直し時の動作もテストします。
スタースキーマ・セマンティックモデル・テスト結果
5
運用ルールとリリース
開発・テスト・本番の環境を分け、変更の反映手順、失敗時の再実行、データ品質の測り方、利用者ごとの権限を決めます。
運用ルール・リリース手順
05/当社の支援内容
メダリオン設計・構築からBI・AI活用、ガバナンスまでのデータエンジニアリング支援
当社は、メダリオンアーキテクチャを軸に、構造化データと業務文書(非構造データ)の整備から、BI・AIエージェントでの活用、全社で使い続けるための運用設計までを支援します。既存の分析基盤との整合を確かめながら移行し、作ったデータを業務で使える状態につなげることを重視しています。
支援の流れ
支援 1全体設計・基盤選定層の役割分担、基盤の比較・検証
→
支援 2・33層の構築と業務文書の整備Silverの共通データモデル、テスト、非構造Silver化
→
支援 4BI・AIでの活用セマンティックモデル、AIエージェントへの供給
→
支援 5・6運用・ガバナンスと内製化運用ルール、リリース手順、ハンズオン
伴走体制:X-Tech FDE(現場に入り込む
実装支援)で、貴社のチームがデータモデルと運用ルールを自ら更新できる状態へ移します。
支援 1
全体設計と基盤の選定
Bronze・Silver・Goldの役割分担、データの領域分け、AI活用との連携を含む全体構成を設計します。基盤が決まっていない場合は、複数の基盤を同じ評価項目で比べ、検証環境で確かめてから選びます。
支援 2
Silverの共通データモデル設計と3層の構築
新旧システムのデータをSilverで統合し、データモデル定義書、マッピング仕様書、処理の実行順序まで整えます。正常系・異常系・やり直しのテストを行い、Goldは既存の分析基盤の数値と照合してから切り替えます。
支援 3
業務文書の非構造Silver化
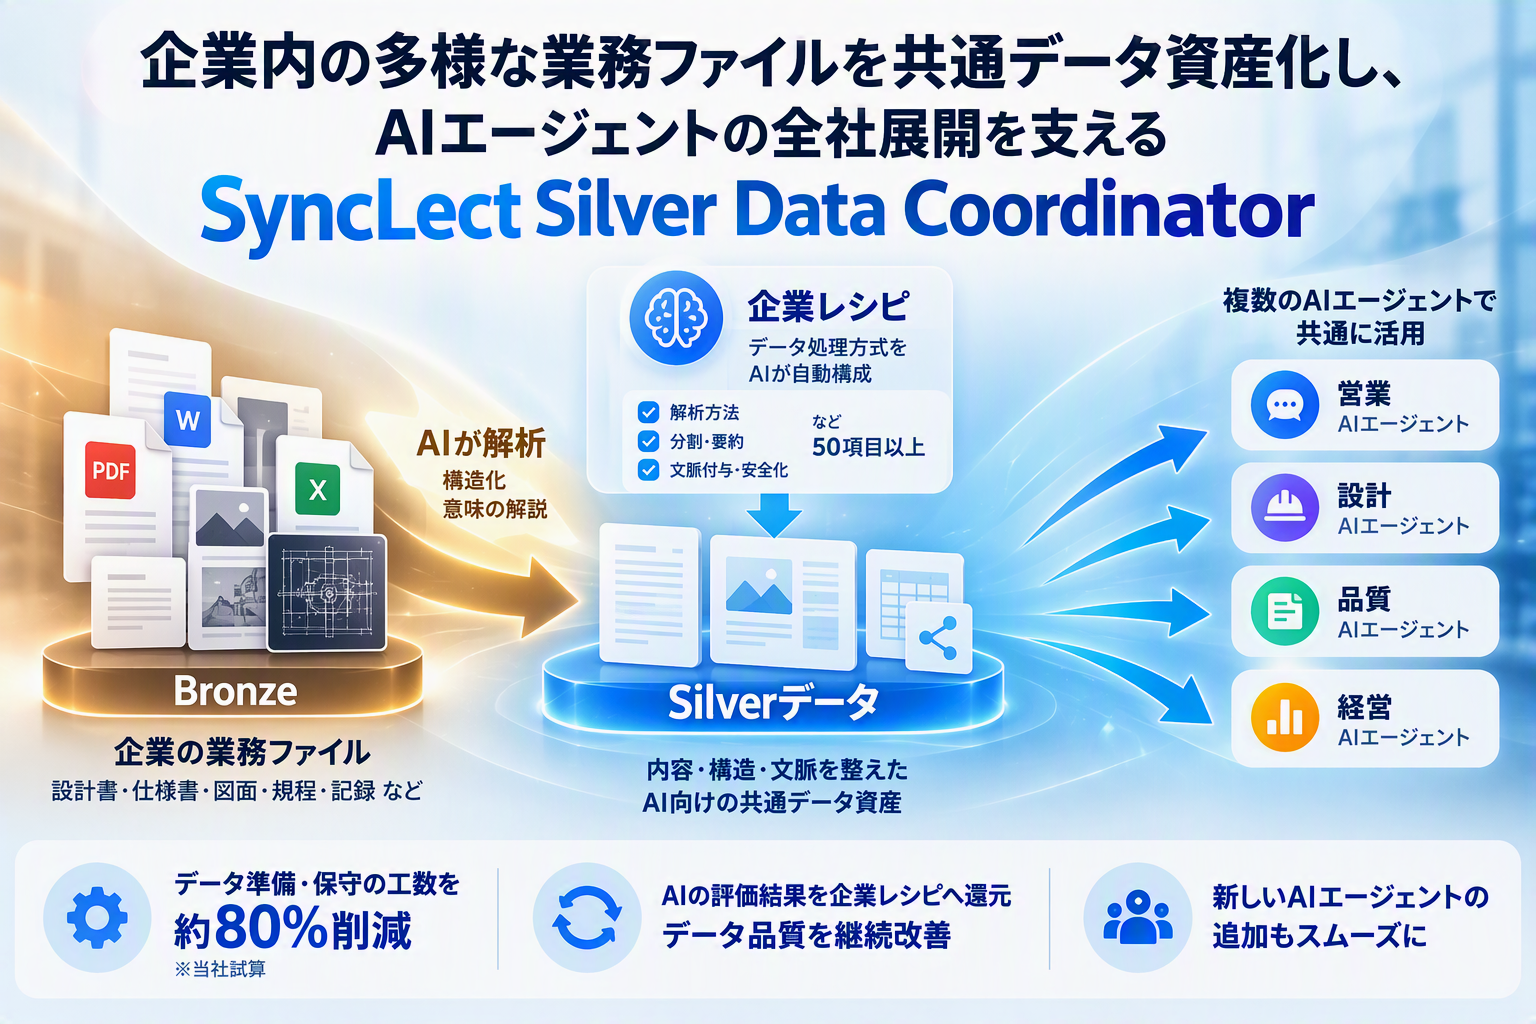
仕様書・設計書・図面・規程などを、AIが読みやすい形に再構成し、文脈・出所・権限・処理履歴を付けて継続的に供給します。変換の手順は「企業レシピ」として再利用できます。
支援 4
BIとAIエージェントでの活用
GoldからPower BIのセマンティックモデルを作り、既存レポートの接続先を切り替えます。AIエージェントには、SilverやGoldのデータと、業務知識として整理した判断基準を参照させます。
支援 5
データガバナンスと運用設計
データの利用条件、作成から廃棄までの管理、メタデータ、監査、申請・承認、例外と変更の管理を方針にまとめます。管理者・利用者別の運用ルールとデータ品質の測り方も成果物にします。
支援 6
リリース手順の整備と内製化
GitHubと連携した変更管理、開発から本番への反映手順、やり直し時の対策を整えます。データの取り込みからセマンティックモデルまでを扱うハンズオンで、貴社のチームが自ら拡張できるようにします。
06/特長
構造化データと業務文書の共通資産化:Silverを中心にBIとAIへつなぐ構成
一般的なメダリオンアーキテクチャは、表形式の構造化データを対象にします。当社は、仕様書・設計書・規程などの業務文書も、出所・権限・処理履歴を付けた「非構造Silverデータ」として同じ考え方で整え、BIとAIエージェントの両方へ供給します。利用先ごとに原本から加工し直さず、共通のデータ資産を作るという点で、2つの取り組みは同じ方針でつながります。
構成イメージ
Bronze原本の保管
構造化データ基幹システム、EC、センサーのデータを取り込み、そのまま保存
業務文書(非構造データ)仕様書・設計書・図面・規程・議事録などのファイルをそのまま保存
基盤はMicrosoft Fabric・Databricksなど、顧客環境に合わせて構成
特長 1/3
Silverの設計から業務への接続まで
共通データモデルの設計、テスト、既存BIとの数値照合、リリース手順までを一続きで支援します。3層を作るだけで終わらせず、業務で使われる状態まで進めます。
07/取り組み事例
Microsoft Fabric・Databricksでのメダリオン構築の取り組み
業種・基盤の異なる案件で、メダリオンアーキテクチャの設計、構築、基盤の選定、運用ルールの策定に取り組んできました。お客様名は伏せ、業種と取り組み内容で紹介します。
業種・基盤取り組み内容
製造・販売業(ECデータ基盤)Microsoft Fabric
新旧のECデータをSilverで統合。Data Vault 2.0に準拠した設計で、データモデル定義書・マッピング仕様書・処理の実行順序を整備し、正常系・異常系・やり直しの単体テストを実施しました。Goldでは既存の分析基盤の数値と照合し、Power BIのセマンティックモデル(Direct Lake方式)を構築して既存レポートの接続先を切り替えています。GitHub連携と、開発から本番への反映手順も整えました。
同上(データガバナンス)Microsoft Fabric
データの利用条件、作成・保管・更新・廃棄、メタデータ管理、監査、申請・承認、例外と変更の管理を方針に整理。管理者・利用者別の運用ルール、データ品質の測り方、共有セマンティックモデルの使い方を成果物としてまとめました。
製造業(自動車関連)Databricks
設備の異常検知モデルの開発支援で、お客様のDatabricks環境にメダリオンアーキテクチャを構築し、データの前処理と環境構築、モデルの移行を行いました。
素材・化学業Microsoft Fabric
主にBronze・Silverの開発を担当し、要件定義、データ連携の処理、ETL/ELT(データの抽出・変換・格納)、スキーマの検討、テスト・改修、品質監視の検討を行いました。
大手通信事業者(基盤更改)AWS・Snowflake・Databricks
メダリオンアーキテクチャを前提に3つの基盤を約50項目で比較し、検証環境を構築して評価しました。お客様はこの結果をもとにDatabricksを採用しています。
AIアシスタント基盤Databricks
マニュアルのPDFをAIが検索しやすい単位に分け、元ファイルとの対応表、RAG用のナレッジ、システム参照用のテーブルを3層で管理する基盤を構築しました。
公開している関連の取り組み
Databricksとの協業
「Data & Agent Lab」を設立
Databricks Agent BricksとSyncLect Data Intelligenceを組み合わせ、企業データと現場知見の整備から、業務特化型AIエージェントの設計・評価・改善・運用までを支援する取り組みです(2026年9月10日発表)。
Azure × Databricks
Databricksソリューション
DatabricksのSIコンサルティングパートナーとして、Azure Databricksを使ったデータ基盤とAI活用の構築・導入を支援しています。
08/顧客価値
数字の不一致・作り直し・AI用データ準備の解消と、役割別の効果
よくある課題メダリオンでの対応得られる価値
部門ごとに同じ指標の数字が違う
指標の計算式をGoldで一度だけ定義し、全レポートで共有する
会議で数字の確認に時間を使わず、判断に集中できる
新しい分析のたびに元データから作り直す
全社共通のSilverを用意し、用途ごとの加工はGoldに分ける
新しい用途の準備期間が短くなる
元データの仕様変更で、どのレポートが壊れるか分からない
層ごとに処理を分け、データの流れ(系譜)を追えるようにする
影響範囲がすぐ分かり、修正が早くなる
AIに読ませる業務文書が整っていない
文書も非構造Silverデータとして、出所・権限付きで整える
AIエージェントの回答の根拠を示せる
誰がどのデータを使えるかが曖昧
層と領域ごとに所有者と公開範囲を決め、運用ルールにする
安心して業務部門にデータを開放できる
経営層
部門をまたいで同じ定義の数字で議論でき、AI活用の土台への投資判断がしやすくなります。
業務部門・DX企画
必要なデータをGoldから自分で取り出せ、IT部門への依頼を待つ時間が減ります。
情報システム部門
加工処理が層ごとに整理され、変更時の影響調査と保守の負担が軽くなります。
データ・AI担当
整ったSilverから機械学習やAIエージェントのデータをすぐ用意できます。
09/業界ユースケース
製造・小売・通信・金融での活用例と、向いている企業
業界整えるデータ業務での使い道
製造
設備のセンサーデータ、点検記録、故障履歴、作業マニュアル
異常検知、設備保全の判断支援。過去の類似事象と対応手順をAIエージェントが提示
小売・EC
店舗とECの売上・顧客・在庫データ、新旧システムのデータ
全チャネルの売上分析、需要予測、Microsoft Fabric上での既存レポートの移行
通信・インフラ
大量の利用ログ、設備データ、契約データ
データ基盤の更改、基盤の比較・選定、分析とAIの共通基盤化
金融・保険
取引・契約データ、問い合わせ履歴、規程・マニュアル
顧客対応の判断支援、規程に沿った回答の根拠提示、監査に耐える記録
全業種(業務ナレッジ)
受領資料、議事録、提案書
議事録を元データ、決定事項・用語の整理をSilver、AI用ナレッジや引き継ぎ資料をGoldとして管理(当社内でも実践)
向いている企業
・複数の部門やシステムで、同じ指標の数字が合わない・Microsoft FabricやDatabricksを導入済み、または検討中・BIに加えて、AIエージェントでも社内データを使いたい・既存の分析基盤(Synapse等)からの移行を控えている
別の方法が合う場合
・データの種類と量が少なく、1つの表計算や単一のBIで足りている・データの使い道がまだ決まっておらず、まず業務課題の整理が必要(この場合は業務整理から支援します)・リアルタイムの制御そのものが目的で、蓄積・分析を伴わない
最初の打ち合わせで伺うこと
Q. 最も数字が合わない、または集計に時間がかかっているレポートは何ですかQ. データの取得元(システム・ファイル)はいくつありますかQ. Microsoft Fabric、Databricksなどの基盤は決まっていますかQ. BIのほかに、AIエージェントで使いたいデータはありますかQ. データの所有者と公開範囲は、誰が決めていますかQ. 移行を控えている既存の分析基盤はありますか
10/想定ROI
データ加工の重複と作り直しの削減試算
5部門がそれぞれ月次の集計・加工を行い、年に数件、新しい分析やAI活用のデータ準備が発生する企業を想定した試算です。共通のSilverとGoldを用意することで、部門ごとの重複作業と、用途が増えるたびの作り直しを減らします。
作業現状(前提)導入後削減
部門ごとの月次の集計・加工
5部門 × 月20時間 = 年1,200時間
共通のGoldを参照し、年480時間
▲60%
数字のずれの原因調査
月15時間 = 年180時間
層ごとに原因を追い、年60時間
▲67%
新しい分析・AI活用のデータ準備
1件80時間 × 年6件 = 年480時間
Silverを再利用し、1件30時間で年180時間
▲63%
元データの仕様変更への対応
1回40時間 × 年4回 = 年160時間
影響範囲を特定し、1回15時間で年60時間
▲63%
合計で年間約1,500時間(現状の約6割)の削減を見込む試算です。実際の効果は、最初の診断で現行の工数を測って算出します。
11/他の手段との違い
部門別データマート・従来型DWH・データレイクとの比較
方法特徴起きやすいこと
部門ごとのExcel・データマート
各部門が必要なデータを個別に集めて加工する。始めやすい
同じ指標の数字が部門で食い違う。担当者が替わると加工手順が分からなくなる
従来型のデータウェアハウス
決まった集計に向けて、元データを直接変換して格納する
新しい用途のたびに変換処理を作り直す。文書などの非構造データを扱いにくい
データレイクに貯めるだけ
あらゆる形式のデータを安く大量に保管できる
品質と意味が揃わず、使える人が限られる。どれが正しいデータか分からなくなる
メダリオンアーキテクチャ
原本を残しつつ、共通化(Silver)と業務別の整理(Gold)を段階的に行う
Silverの設計と運用ルールが要。最初の設計に専門知識が必要
メダリオンアーキテクチャは、Data Vault 2.0などのデータモデルの手法と対立するものではありません。当社では、システムをまたぐ統合が多い場合に、Silverの設計にData Vault 2.0の考え方を取り入れています。
12/ガバナンス
データガバナンスと運用設計:権限・品質・変更管理のルール
全社で使うデータ基盤は、作った後の運用で価値が決まります。誰がどのデータを使えるか、品質をどう測るか、変更をどう反映するかを、構築と並行して決めます。
データ品質の測定
欠け・重複・ずれの基準を決め、層を移るときに確認します。測り方と報告の仕方も運用ルールに含めます。
環境の分離と変更管理
開発・テスト・本番の環境を分け、GitHubを使って変更の履歴と反映手順を管理します。
申請・承認と例外
データの利用申請、承認の流れ、例外的な利用の扱いを定め、監査に必要な記録を残します。
AI利用時の統制
AIエージェントが参照してよいデータと権限を決め、AIガバナンスの方針と合わせて運用します。
13/当社について
Databricks・Microsoftの認定パートナーとしてのデータ&AI支援
Databricks SIコンサルティングパートナー
Databricksの構築、導入支援、サポートを提供しています。2025年に「Databricks GenAI LAB」、2026年9月に「Data & Agent Lab」を設立し、データ基盤とAIエージェントの実装をつなぐ協業を進めています。
技術知見の公開
Microsoft FabricやDatabricksでのメダリオンアーキテクチャの実装手順を、当社の技術ブログで公開しています。
14/はじめ方
現状診断から横展開までの5ステップのスタートプラン
全社のデータを一度に移すのではなく、効果の見えやすい1つの業務領域で3層を作り、運用ルールと合わせて型にしてから広げます。
1
STEP 1 現状診断
データの取得元、既存レポート、集計にかかっている工数、数字が合わない箇所を棚卸しします。ROI試算の前提となる現行工数もここで測ります。
2
STEP 2 対象領域とGoldの定義
効果の見えやすい1つの業務領域を選び、Goldで提供する指標と使い手を決めます。基盤が未定の場合は比較・選定もここで行います。
3
STEP 3 1領域で3層を構築
Bronze・Silver・Goldを構築し、既存レポートと数値を照合してから切り替えます。業務文書を扱う場合は非構造Silver化も並行します。
4
STEP 4 運用ルールの整備
権限、品質の測り方、変更の反映手順、申請・承認の流れを決め、貴社のチームで回せるようにします。
5
STEP 5 他領域・AI活用への展開
共通のSilverを再利用して他の領域へ広げ、AIエージェントでの活用に進みます。X-Tech FDEで現場に入り込んで伴走します。
整えたデータをAIエージェントで使う検証を短期間で行いたい場合は、HWS Agent Camp(約2週間の事前準備と2日間の集中開発)で、SilverやGoldのデータを参照するエージェントを試作できます。
15/関連ソリューション

Fabricで、
データとAIを一つに。
Microsoft Fabric. OneLakeを中心に、データの取り込みからPower BIまでを統合したデータ基盤の構築を支援します。
Databricksで、
AI-Platformを築く。
Databricksソリューション. SIコンサルティングパートナーとして、Databricksを活用したデータ&AI基盤の構築と導入を伴走します。

AIに渡す情報を、
設計する。
コンテキストエンジニアリング. AIエージェントが参照する業務コンテキストを、データ・文書・ルールから設計します。

整えたデータで、
2日間で試作する。
HWS Agent Camp. 専門エンジニアが伴走する2日間の集中開発で、SilverやGoldを参照するAIエージェントを試作します。
16/よくあるご質問
Q. メダリオンアーキテクチャ(Medallion Architecture)とは何ですか。
A. データをブロンズ(Bronze:元データ)・シルバー(Silver:整備済み)・ゴールド(Gold:業務活用)の3層で段階的に整える、レイクハウスの設計手法です。Microsoft FabricとDatabricksの公式ドキュメントで推奨されています。マルチホップアーキテクチャとも呼ばれます。
Q. BronzeとSilverとGoldの違いは何ですか。
A. Bronzeは届いたままの原本、Silverは誤り・重複・表記ゆれを直してシステムをまたいで統合した共通データ、Goldは業務の目的ごとに集計し指標を定義したデータです。業務部門や経営層が日常的に使うのはGoldです。
Q. 3層すべてを必ず作る必要がありますか。
A. Databricksは推奨であり必須ではないとしています。用途によっては層を増やしたり、Goldを業務領域ごとに複数持ったりします。当社は、用途と運用体制に合わせて層の数と役割を設計します。
Q. Microsoft FabricとDatabricksのどちらで構築すべきですか。
A. 既存のMicrosoft 365・Power BIの活用度、データ量、機械学習の比重、他のクラウドとの関係で判断します。当社はどちらでも構築しており、決まっていない場合は同じ評価項目で比べ、検証環境で確かめてから選びます。
Q. 既存のデータウェアハウスやSynapseから移行できますか。
A. はい。既存の分析基盤とGoldの数値を照合し、差分を確かめてから既存レポートの接続先を切り替える進め方で移行を支援しています。
Q. AIエージェントの活用とどう関係しますか。
A. AIエージェントが正しく業務を進めるには、参照するデータの品質と権限が整っている必要があります。SilverやGoldは、AIエージェントが参照する信頼できるデータになります。判断基準などの業務知識はSyncLect Data Intelligenceで整理します。
Q. Data Vaultとはどう違いますか。
A. メダリオンアーキテクチャはデータを品質の段階で分ける考え方で、Data Vault 2.0はシステムをまたぐデータを履歴付きで統合するモデルの手法です。両立でき、当社ではSilverの設計にData Vault 2.0の考え方を取り入れた実績があります。
Q. どのくらいの期間で始められますか。
A. 現状診断から1つの業務領域での3層構築・運用ルール整備までを、最初の単位として進めます。期間はデータの取得元の数と移行の有無で変わるため、診断の段階でお見積りします。
メダリオンアーキテクチャによるデータ基盤のご相談
現状のデータと用途の棚卸し、基盤の選定、Silverの設計、BI・AIでの活用、運用ルールまで、貴社の状況に合わせてご提案します。
お問い合わせ