01/サービス概要
業務ファイルの非構造Silverデータ化と企業レシピ自動生成
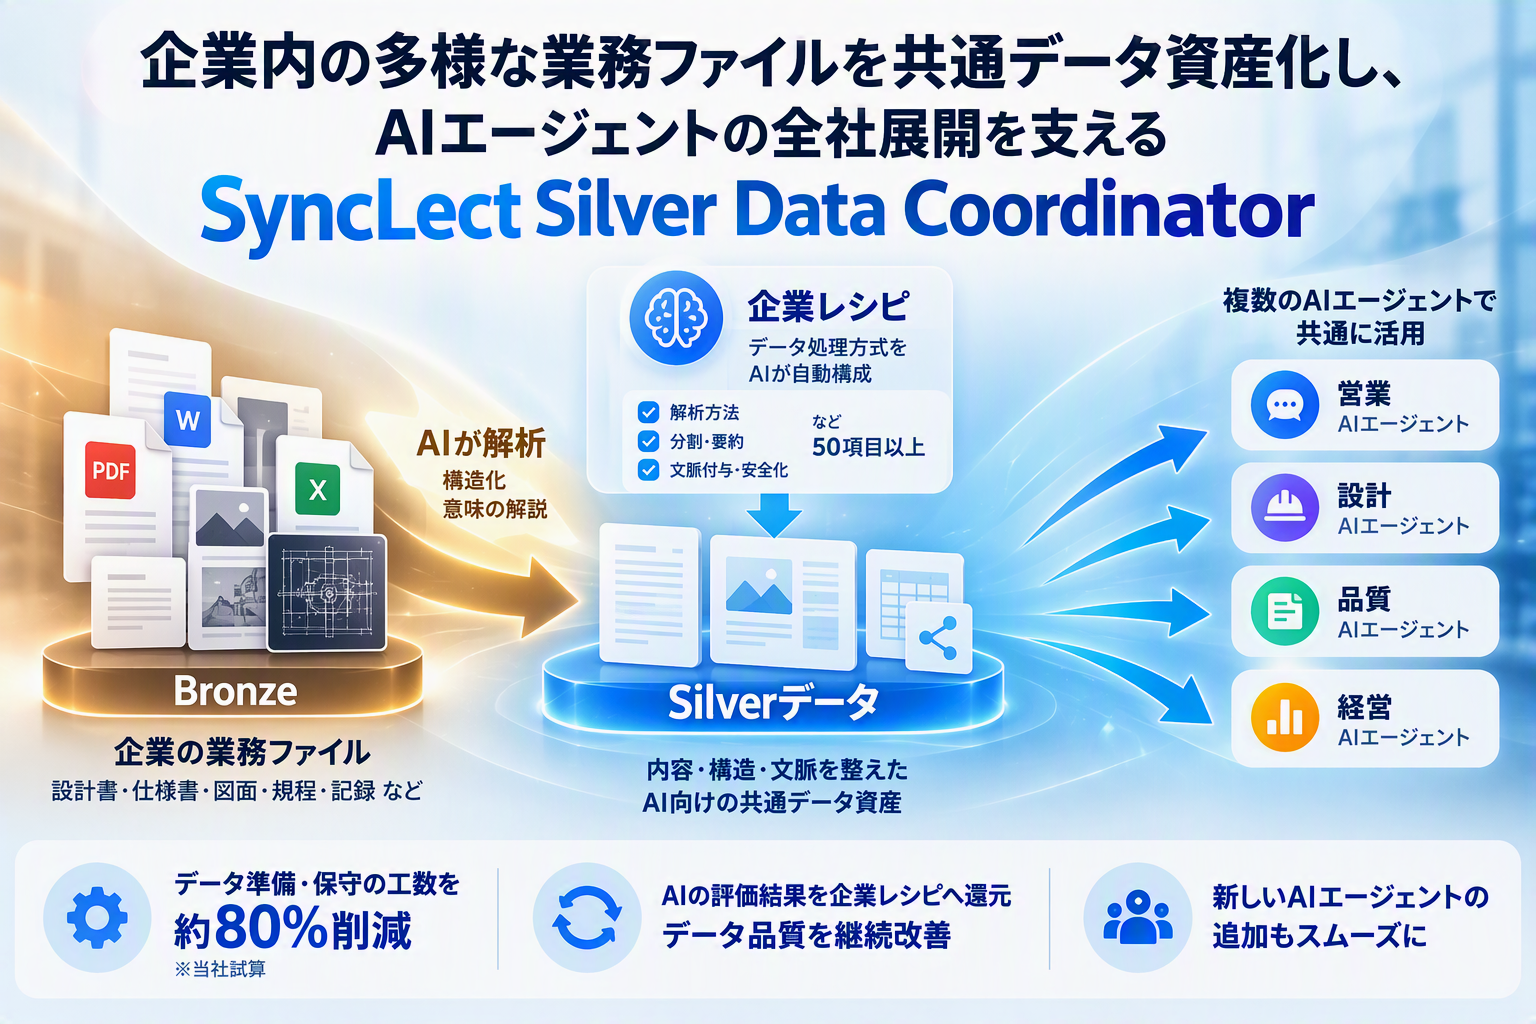
多様な業務ファイルを共通データ資産にして、AIエージェントの全社展開を支える。 SyncLect Silver Data Coordinatorとは、製品仕様書、設計書、図面、法令・規制文書、融資・審査資料、運行・保安文書、設備・点検記録など、人間が利用することを前提に作成された業務ファイルを、AIが解釈しやすいMarkdown等へ再構成するデータ基盤です。出所、権限、処理履歴を付与し、複数のAIエージェントやナレッジベースで再利用できるSilverデータとして継続的に供給します。解析方式、出力形式、分割方法、コンテキスト(文脈)付与、安全化、登録方法といったデータ処理方式は、AIが「企業レシピ」として自動構成します。
プレスリリース原文を見る →
背景
AIエージェント全社展開で顕在化する業務ファイルのデータ準備ボトルネック
AIエージェントを増やすほど、データ準備の人月も増えていく。 企業のAI活用は、個別のチャットボットや検索システムから、業務・部門・役割ごとに複数のAIエージェントを展開する段階へ移っています。それぞれのAIエージェントが必要な企業データへ継続的にアクセスできる状態が必要になります。一方、人間向けに作成された業務ファイルは、文字だけでなく、表、図、レイアウト、注記、単位、前後関係を通じて情報を記録しています。単に文字を抽出して登録するだけでは足りず、内容や形式に応じた解析、構造・コンテキストの再構成、分割、安全化、出所・権限の保持が必要です。これらをAIエージェントや案件ごとに個別設計すると、展開規模に比例してデータエンジニアリング工数と保守対象が増加します。
顧客の検討テーマも、個別RAGから、Microsoft FabricやDatabricksなどを活用した全社AI・エージェント基盤へ移っています。構造化データの統合が進む一方、製品仕様書、設計書、図面、CAD、規程といった定性・非構造データの準備は、未充足の工程として残っています。SyncLect Silver Data Coordinatorは、この工程を担います。
Silverデータとは
メダリオンアーキテクチャでは、生データをBronze、検証・標準化したデータをSilver、用途別に加工したデータをGoldと呼びます。これを企業ファイルへ適用し、原本をBronze、AIが利用できる形に再構成して文脈・出所・権限・処理履歴を付与した状態を「非構造Silverデータ」と定義します。
企業レシピとは
Silverデータへ変換するための、解析、出力、分割、コンテキスト付与、安全化、登録方法などを保存した処理設計です。Silverデータの「作り方」を残し、同種ファイルや次の利用先へ再利用します。
AI-Readyとは
AIが内容を解釈でき、出所と権限を追跡でき、複数のAIエージェントが共通に利用できる状態です。特定のナレッジベースやAIエージェントに閉じず、再利用できることを重視します。
02/なぜ今
データ準備人月を線形に増やさない、AIエージェント展開の前提条件
モデルの性能より先に、入力データの準備がボトルネックになる。 AIエージェントとファイルの数が増えるほど、解析方式の設計、分割、コンテキスト付与、安全化、登録、評価を個別に繰り返す負荷が増えます。一度作ったSilverデータと企業レシピを共通資産として再利用する設計に早く切り替えるほど、展開が進んだ時点での差が大きくなります。
人手のデータエンジニアリング
- ファイル種別・案件ごとに解析方式や分割方法を設計
- AIエージェントの追加ごとに同じファイルを加工し直す
- 展開規模に比例して工数と保守対象が増える
Silver Data Coordinator
- AIが企業レシピを自動構成し、人は確認・調整から始める
- 共通のSilverデータを複数のAIエージェントが再利用
- 同種ファイルへ企業レシピを適用して継続供給
→
今後12〜18カ月で、何種類・何件の業務ファイルを、何体のAIエージェントに使わせる計画ですか。
→
解析方式、分割、コンテキスト付与、登録の設計は、誰がファイル種別ごとに行っていますか。
→
AIエージェントを追加するたびに、同じファイルを加工し直していませんか。
→
新規・更新されたファイルは、どのくらいの遅れでAIエージェントに反映されていますか。
→
Agent数が10倍になった場合、データ準備のどこが最初のボトルネックになりますか。
03/仕組み
ファイル取得からナレッジベース登録・評価までの8工程
取得から評価までを、一連の処理として実行する。 SharePoint、OneDrive、Google Drive、Blob、S3、IMAP、手元ファイルなどから業務ファイルを取得し、解析、Markdown等への再構成、コンテキスト・ガバナンス情報の付与、ナレッジベースへの登録までを実行します。登録後の回答評価の結果は、次回の企業レシピ生成や見直しの参考情報になります。
1
接続・取得
SharePoint、OneDrive、Google Drive、Blob、S3、IMAP、手元ファイルから取得
2
形式判定
拡張子に応じてOffice、OCR、CAD、メール、メディア等の処理へ振り分け
3
抽出
ロジック抽出、OCR、ハイブリッドを企業レシピで選択して実行
4
意味表現化
Markdown、JSONL、Mermaid、チャート構造化、画像キャプションへ再構成
5
コンテキスト化
文書要約、タグ、チャンク単位のコンテキスト付与で、全体と断片の関係を補う
6
安全化
個人情報マスキング、サニタイズ、プロンプトインジェクション対策
7
分割・登録
チャンク、メタデータ、Embeddingを生成し、AI Search等のナレッジベースへ同期
8
評価・改善
回答評価と原因分析を、次回の企業レシピ生成時の参考情報として蓄積
Bronze・Silver・ナレッジベースの役割分担
RAGは利用先の一つであり、製品カテゴリではない。 Silverデータはナレッジベースそのものではなく、その原料にあたります。
区分
定義
代表要素
Bronze
人間向けに作成・蓄積された原本の業務ファイル
Office、PDF、CAD、メール、画像、動画、音声
非構造Silver
内容・構造・コンテキストをAI向けに再構成し、出所・権限・処理履歴を保持した再利用可能な中間資産
Markdown、JSONL、チャンク、要約、タグ、ベクトル、メタデータ
ナレッジベース
Silverデータを検索・取得・回答へ利用する実装先
Azure AI Search、Dify Knowledge、AWS Bedrock Knowledge Bases等
意味統合・業務知識化
Silverを概念・関係・ルールへ統合する後段
SyncLect Data Intelligence、SyncLect Agent Garden等
対応する業務ファイル形式
Office
doc/docx、xls/xlsx、ppt/pptx
構造解析と固有情報の保持
文書・Web
PDF、CSV、HTML
統一Markdown等へ変換
画像
PNG、JPEG、GIF、WebP、BMP、TIFF
OCR、画像キャプション
CAD
DXF、OBJ
2D図面・3Dモデル向けの専用処理
メール
EML、MSG、IMAP
件名、差出人、添付情報を保持
動画・音声
主要な動画・音声形式
Azure AI Video Indexer等と連携
04/特長
特長 1/3
新規・更新ファイルの継続供給と共通Silverデータ再利用
増え続ける業務ファイルを、複数のAIエージェントへ継続供給する。 新規作成・更新される業務ファイルに企業レシピを適用してSilverデータへ変換し、複数のナレッジベースやAIエージェントへ継続的に供給します。AIエージェントの追加ごとに同じ業務ファイルを加工し直すのではなく、共通Silverデータを再利用します。
特長 2/3
Silverデータ・企業レシピ・評価情報のナレッジデータフライホイール
Silverデータと、その作り方を、共通資産として蓄積する。 生成したSilverデータと企業レシピに加え、AIエージェントが必要な情報を取得できたか、元の内容に沿って回答できたかの評価情報を蓄積します。評価結果は次回の企業レシピ生成や処理方式の見直しに利用されます。この継続運用で蓄積した資産を次のファイル、部門、AIエージェントへ再利用し、継続供給の負荷を下げる資産循環を、当社は「ナレッジデータフライホイール」と位置づけています。
特長 3/3
50項目以上の設定を含む企業レシピのAI自動生成
ファイルごとのデータ処理方式を、AIが自動構成する。 AIがサンプルファイルの内容や形式を分析し、解析方式、出力形式、分割方法、コンテキスト付与、安全化、登録方法など、50項目以上の設定を含む企業レシピを生成します。既存の企業レシピをAIが採点し、改善理由を返す機能もあります。生成した企業レシピは必要に応じて人が調整したうえで実行し、同種ファイルへ再利用します。
Silverデータの品質を支える3つのインテリジェンス層
Content Intelligence
文字、図表、画像、CAD等をAIが扱える表現へ再構成
AIが利用できる情報範囲を広げる。
Context Intelligence
文書全体と断片の関係を補い、断片化によるコンテキスト欠落を抑える
検索された断片の意味を理解しやすくする。
Governance Metadata
出所、処理履歴、所有者、組織、アクセス範囲を保持
本番利用に必要な追跡・権限・監査を成立させる。
05/顧客価値
データ準備の人月依存を下げるAIエージェント展開基盤
AIエージェントが増えても、データ準備の人月を線形に増やさない。 業務ファイルのSilverデータ化と企業レシピの再利用により、AIエージェント追加時の重複準備を減らします。ファイルの更新にも既存の企業レシピを適用して追随でき、AIエージェントの継続利用を支えます。初期導入はFDE型で伴走し、継続運用は顧客の業務・DX担当者へ移管する進め方を想定します。専門エンジニアは、ゼロからの設計ではなく確認・調整から始められます。
変える対象
従来
導入後に起きる価値
共通資産化
AIエージェント、案件、部門ごとに同じファイルを加工
Silverデータと企業レシピを複数用途へ再利用し、Agent追加時の重複準備を削減
継続供給
新規・更新ファイルのたびに処理方法を個別設計
既存の企業レシピを適用して継続処理し、企業情報の変化へ追随
AI自動構成
専門エンジニアが多数の設定をゼロから決定
AIが50項目以上の設定を含む企業レシピを生成し、初期設計・調整の人月依存を下げる
品質
文字抽出のみで、表・図・文脈が欠落
図表・構造・コンテキスト・出所を保持した入力データをAIへ渡せる
ガバナンス
AIごとに権限・出所の扱いがばらつく
出所・権限・処理履歴をSilverデータと一緒に保持し、追跡と監査を成立させる
経営・事業責任者
AIエージェント展開に伴う人月増を抑え、データ準備を再利用できる資産へ変える
AI・DX推進
AIエージェントごとに繰り返すファイル加工を共通基盤化し、展開速度を維持する
データエンジニア
ゼロからの設計ではなく、AI案の確認・調整から始め、評価と運用に集中する
業務部門
更新したファイルが、既存のAIエージェントへ継続的に反映される
営業・SIer・コンサル
企業レシピと評価セットで、同種案件の立ち上げを短縮し、提案の再現性を高める
IT・情報セキュリティ
顧客管理環境への配置、マスキング、出所・アクセス範囲、監査ログを前提に設計する
06/ユースケース・適性
製造・金融保険・交通運輸・エネルギーインフラの業務ファイル活用
専門性の高い業務ファイルを大量に保有する業界ほど、効果を発揮する。
01
製造
対象ファイル 要求仕様書、提案書、製品仕様書、設計書、図面・CAD、検査・保守記録
利用イメージ 営業・提案、設計、品質、調達、保守のAIエージェントへ共通供給し、資料検索・チェック・作成、図面解析、提案・設計・保守業務に利用します。
02
金融・保険
対象ファイル 法令・規制文書、融資・審査資料、保険約款、社内規程、顧客応対記録
利用イメージ 照会、審査、コンプライアンス確認に加え、顧客問い合わせ対応や案内・提案の高度化に利用します。
03
交通・運輸
対象ファイル 運行規程、保安文書、整備記録、運行・運航マニュアル、問い合わせ履歴
利用イメージ 運行支援、安全管理、整備・保守に加え、利用者問い合わせ対応や案内の高度化に利用します。
04
エネルギー・インフラ
対象ファイル 設備図面、保安規程、点検記録、工事・運転マニュアル
利用イメージ 設備保全、安全管理、現場支援に利用します。閉域環境での利用にも対応します。
対話ログ・問い合わせ履歴のSilverデータ化による顧客接点の高度化
顧客との対話ログや問い合わせ履歴を格納したCSV等もSilverデータ化し、製品情報やCRM等の顧客情報と組み合わせることで、顧客問い合わせへの回答支援、社内照会の効率化、顧客理解、一人ひとりに合わせた案内・提案の高度化に活用できます。個人情報の検出・マスキングを処理に含めます。なお、これは顧客接点AIへ再利用可能なデータを供給する前段の位置づけです。
Data Lake・データガバナンス案件への非構造Silver供給レイヤー
データプラットフォームを置き換えず、不足する工程を補う。 Data Lakeやデータガバナンスの構想では、要求仕様書、提案書、設計書、図面、問い合わせ履歴などを非構造Silverデータへ変換し、資料検索・チェック・作成・図面解析といった複数のAIエージェントへ継続供給するレイヤーとして組み込めます。案件名がデータ統合でも、複数のAIアプリ、業務ファイル、部門横断利用、出所・権限・更新管理が含まれていれば適合します。
SyncLect Silver Data Coordinator導入適性チェック
御社に当たるか、次の観点で自己診断できます。
適合する顧客
- 専門性の高い業務ファイルを大量に保有している
- ファイル種別が多く、処理ルールが一定でない
- 複数部門が継続的にファイルを追加・更新している
- 複数のAIエージェント・ナレッジベースへ共通供給したい
- 機密性が高く、出所・権限・監査が重要である
- 既存のAI投資はあるが、データ準備が詰まっている
適合しにくい顧客
- 対象ファイルが少数で、更新もほとんどない
- 単一のRAGを一度作るだけで、再利用の予定がない
- 構造化データの統合だけが目的である
- 無人で品質を保証する完全自動運用を期待している
- 業務ファイルの利用権限や責任者を決められない
AIエージェント向けデータ準備のDiscovery質問
→
AIに利用させたい業務ファイルは何種類・何件ですか。図表、CAD、画像を含みますか。
→
新規作成・改訂は月に何件あり、現在どうAI側へ反映していますか。
→
同じファイルを使うAIエージェント、部門、ナレッジベースはいくつありますか。
→
解析、分割、登録、評価に、誰が何時間使っていますか。
→
回答品質、出所追跡、権限、機密情報、監査のどこに課題がありますか。
→
Microsoft Fabric、Databricks、Azure AI Searchなどを利用していますか。
→
対話ログ、問い合わせ履歴、顧客応対記録を蓄積していますか。CRM等と組み合わせて利用したいですか。
→
個人情報のマスキング要件や、データを管理外へ持ち出せない制約はありますか。
07/想定ROI
企業レシピ自動生成による初期設計・調整工数の削減試算
初期設計の人作業を、約80%削減できる見込み(当社試算)。
以下は実績値ではなく、当社が設定した標準的な作業工程に基づく試算です。実際の削減効果は、ファイル形式、内容、複雑度、品質要件、利用環境によって異なります。一律の削減率や投資回収期間を約束するものではありません。
人が個別に設計・調整
約26時間
1つの業務ファイル種別あたりの初期設計・調整
企業レシピ自動生成を利用
約5時間
AI案の確認・調整から開始
削減見込み
約80%
人作業工数(当社試算)
この試算は初回の企業レシピ作成時のものです。同種ファイルへ企業レシピを再利用する際の効果や、AIエージェント追加時の重複準備の削減は、ファイル数・更新頻度・AIエージェント数に応じて変わります。まず代表的な1〜2文書タイプで企業レシピを作成し、御社の現行工数と処理原価を測定したうえで、試算を実測値に置き換えてご判断いただきます。
→
人月代替 文書タイプ当たりの設計・調整工数、外部委託費、1,000ファイル当たり処理原価
→
AI自動構成 企業レシピ生成時間、AI案の採用率、人による修正項目数
→
再利用 企業レシピ再利用率、同一Silverを利用するAIエージェント数、部門横展開数
→
継続供給 月間新規・更新ファイル数、反映リードタイム、未処理滞留数、処理成功率
→
品質 必要情報の取得率、元情報への忠実性、回答修正率、原因調査時間
→
ガバナンス 出所追跡率、権限逸脱件数、監査対応時間
08/導入ステップ
Diagnosticから横展開までの5段階導入とライセンス提供
小さく測ってから、本番と横展開へ進める。 代表ファイルでの診断から始め、1〜2文書タイプで企業レシピを作り、Before/Afterを評価したうえで本番化します。
STEP 1
Diagnostic
代表ファイルと想定質問で、意味・コンテキスト・権限要件を診断
成果物:データ品質診断、適用優先順位
STEP 2
Recipe Pilot
1〜2文書タイプで企業レシピを作り、Before/Afterを評価
成果物:企業レシピ、評価質問、精度・工数KPI
STEP 3
Production
接続、権限、監査、更新ジョブを含め本番化
成果物:運用設計、SLA、ガバナンス
STEP 4
Expansion
他ファイル、他部門、他AIエージェントへ横展開
成果物:企業レシピライブラリ、共通基盤化
STEP 5
Intelligence
SDI・Agent Garden等の後段へ接続
成果物:意味統合、Skill・Playbook化
エンタープライズ向けソフトウェアライセンス
顧客が指定するクラウド環境またはオンプレミス環境へ配置します。対象ファイルの調査、企業レシピの設計、既存のデータ・AI基盤との接続、評価・改善運用などの導入支援を提供します。
中小企業・部門向けSaaS(展開予定)
中小企業や大企業の部門・グループ会社に向けて、専門的なデータ基盤を個別に構築することなく、企業ファイルをAI-Readyなデータへ変換・運用できるSaaSとして展開します。エンタープライズ向けと共通の技術基盤を活用します。
09/競合・代替比較
Microsoft Fabric・Databricks・Azure AI Searchと連携する非構造データ供給
構造化データは既存基盤で、業務ファイルはSilver Data Coordinatorで。 Microsoft Azureを基盤として活用し、Microsoft FabricやAzure AI Search、Databricksなどのデータ・AI基盤と連携します。構造化データと、人間向けに作成された多様な業務ファイル由来のSilverデータを、あわせてAIエージェントへ供給し、扱えるデータの範囲を広げます。置き換える対象は、これらの基盤ではなく、AIエージェントへ投入するたびにエンジニアやSIerが個別に設計・実装していた人月型の非構造データエンジニアリングです。
選択肢
主にできること
Silver Data Coordinatorの位置
Document AI・パーサー
OCR、レイアウト解析、Markdown・JSON変換
解析部品として活用し、コンテキスト、権限、評価、継続供給の運用へ接続する
Microsoft Fabric・Databricks等
Lakehouse、ETL、AI機能、検索、基盤ガバナンス
競合ではなく連携。業務ファイル由来の非構造Silverを補完供給する
AI Search・RAG・ナレッジ基盤
登録済みデータの検索、取得、回答
前段で何をどの品質で登録するかを担う
SIer・社内個別開発
要件への柔軟な適合
個別の知見を企業レシピ・処理部品・評価資産へ還元し、反復可能にする
生成したSilverデータは、マイクロサービス型の構成により、SyncLect Data Intelligence(SDI)による意味統合や、SyncLect Agent GardenによるSkill・Playbook化などの後段処理と組み合わせられます。
10/セキュリティ・ガバナンス
顧客管理環境への配置と個人情報マスキングによる安全な非構造データ処理
機密性の高い業務ファイルを、顧客の管理外へ持ち出さずにSilverデータ化する。 顧客が管理する環境内へ配置できるため、既存のネットワーク、認証、アクセス制御、データ管理方針に沿った構成で処理できます。設計書、仕様書、契約・審査資料、対話ログなど、外部環境への送信が難しいデータも、顧客のセキュリティ要件に応じた構成でSilverデータ化できます。
データ処理としての安全化
- 個人情報の検出・マスキング
- ファイル内の命令文をシステム指示として扱わない安全化(プロンプトインジェクション対策)
- 出所・所有者・組織・アクセス範囲・処理履歴の保持
実行環境のセキュリティ
- Microsoft Entra IDによる認証、Managed Identityによるアクセス制御
- Private Endpoint・VNetによる閉域接続
- Azure Key Vaultによる認証情報・暗号鍵の管理
- 監査ログ
機能の範囲について
元ファイルや接続先に存在しない業務事実を創作・確定する製品ではありません。要約・タグ・文脈付与は、管理されたオントロジーそのものではありません。評価結果から設定を自動で変更し続ける閉ループ型の自動最適化ではなく、更新された全ファイルの品質を無人で保証するものでもありません。AIが処理方式を自動構成し、人が必要に応じて確認・調整します。
11/当社について
Microsoft Azure の AI Platform/Agentic DevOps Specialization取得
ヘッドウォータースは「Microsoft Solutions Partner for Digital & App Innovation(Azure)」の認定に加え、上位資格である「AI Platform on Microsoft Azure」「Agentic DevOps with Microsoft Azure and GitHub」の2領域のSpecializationを取得しています。厳格な技術要件と導入実績を満たしたパートナーのみに付与される称号で、2領域の同時取得は国内でも限られています。
Microsoft AI Innovation Partner of the Year 2024 受賞
「AI イノベーション パートナー オブ ザ イヤー アワード」は、マイクロソフト製品の活用によってAI分野で革新を起こしたパートナーに贈られるアワードとして2024年に新設され、ヘッドウォータースは同分野において最も優れた実績をあげたとの評価を受け、初代受賞パートナーとなりました。日本航空(JAL)様のSLM活用や大和証券様のAIオペレーター、JR西日本様の「Copilot for 駅員」など、エンタープライズ企業向けの大規模AIエージェント開発を数多く手がけてきた実績が評価の背景にあります。
Agentic Work Flowで正答率99%を達成
ヘッドウォータースは、複数のAIエージェントが連携するAgentic Work Flowにおいて、正答率99%という高い精度を達成しています。AIエージェントの品質を担当者の経験に依存させず組織として再現する取り組みの実績であり、AIエージェントへ供給するデータの品質と再現性を重視するSyncLect Silver Data Coordinatorの設計とも通じるものです。
12/関連ソリューション
前段のSilver化から、後段の意味統合・業務知識化までをつなぐ。 SyncLect Silver Data Coordinatorは単体でも業務ファイルのAI-Ready化を実現しますが、SDIやAgent Garden、FDEと組み合わせることで、供給したデータを業務に根差したAIエージェントの知識へ発展させられます。
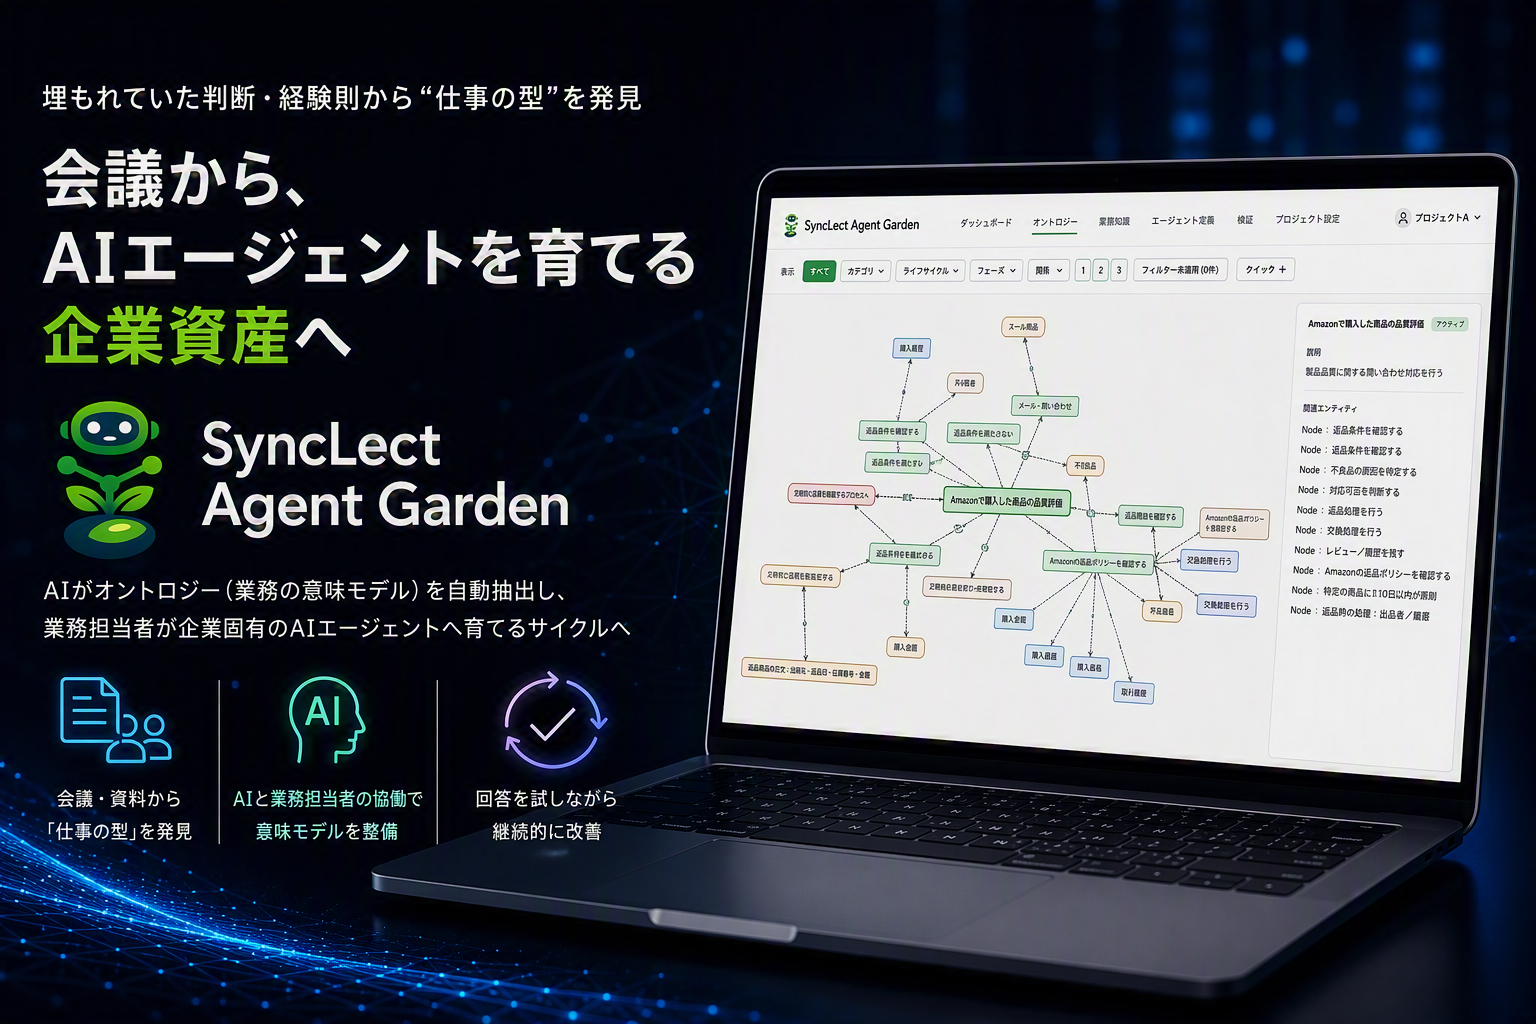
ファイルにない判断も、
会議から業務資産に。
SyncLect Agent Garden. Teams会議や業務資料の判断・経験則を抽出し、AIエージェント向けの業務資産へ変換します。Silverデータと組み合わせてSkill・Playbook化へ発展させます。
13/よくあるご質問
Q. Silverデータとは何ですか。
A. AIが利用できる内容・構造・コンテキストへ再構成し、出所・権限・処理履歴を保持した中間データです。ナレッジベースそのものではなく、その原料にあたります。
Q. 企業レシピとは何ですか。
A. Silverデータへ変換するための解析、出力、分割、コンテキスト付与、安全化、登録方法などを保存した処理設計です。同種ファイルや次の導入へ再利用します。
Q. 完全自動ですか。
A. AIがデータ処理方式を自動構成し、人が必要に応じて確認・調整します。評価結果から無人で設定を変更する製品ではありません。
Q. RAG精度改善ツールですか。
A. いいえ。RAGはSilverデータの利用先の一つです。複数のAIエージェントへ非構造Silverデータを継続供給するデータ基盤です。
Q. Document AIとは何が違いますか。
A. Document AIは解析部品として活用します。本サービスは解析に加え、処理方式、コンテキスト、権限、評価、継続供給を一つの運用へつなげます。
Q. Microsoft FabricやDatabricksと競合しますか。
A. 競合しません。構造化データは既存のデータプラットフォームで統合し、業務ファイル由来の非構造データを本サービスでSilver化して補完します。
Q. どこで動きますか。
A. Microsoft Azureを基盤として実装しており、顧客が指定するクラウド環境またはオンプレミス環境へ配置します。機密性の高いファイルを顧客の管理外へ持ち出さず処理できます。
Q. 効果はどのくらいですか。
A. 当社試算では、1つの業務ファイル種別の初期設計・調整に要する人作業工数を約80%削減できる見込みです。実際の効果はファイル形式や複雑度で異なるため、導入時に実測して検証します。
SyncLect Silver Data Coordinatorについてのご相談
対象ファイルの調査、企業レシピの設計から、既存のデータ・AI基盤との接続、運用設計まで、貴社の状況に合わせてご提案します。
お問い合わせ