01/サービス概要
背景
プロンプト改善で止まるAI活用と、業務コンテキスト欠落の壁
指示文を磨いても、モデルが業務を知らなければ判断は安定しない。 AIエージェントの活用が試行から常駐へ進むと、品質のばらつきの原因は、モデルの性能や指示文よりも、渡される情報の側にあることが多くなります。業務ファイルは表・図・注記・前後関係で意味を持ち、判断基準や例外条件は担当者の経験や会議の中にあり、アクセスしてよい情報は利用者ごとに異なります。これらを個別のプロンプトやRAGに閉じて作り込むと、エージェントの数に比例して作業と保守対象が増え、情報の古さ、権限の逸脱、断片化によるコンテキスト欠落が見えないまま広がります。
コンテキストエンジニアリングとは
AIが状況に応じて適切な判断と行動を選択できるよう、目的・状態・ルール・制約・環境・履歴といった動的文脈を構造化し、実行時に供給し続ける技術です。2025年にAnthropic社が体系化した国際的潮流です。
動的文脈の5要素
目的(Goal)は何を達成すべきか、役割(Role)はどんな立場で判断すべきか、制約(Rules)は守るべき禁止事項・例外条件、状態(Progress)はどこまで進み次に何をするか、権限(Permission)はアクセスしてよい情報と実行可能な操作です。
オントロジーとは
人・業務・データ・ルールの関係を示す業務の意味モデルです。用語や概念の対応を揃え、複数のAIエージェントが同じ意味でデータを扱えるようにします。
02/なぜ今
エージェント増加とともに顕在化する、コンテキスト品質の格差
モデルは共通で使えるが、業務コンテキストは企業ごとに作るしかない。 同じモデルを使っても、渡す情報の質で結果は変わります。コンテキストを共通資産として設計した企業は、エージェントを追加するたびに既存資産を再利用でき、個別に作り込む企業との差は展開が進むほど大きくなります。
エンタープライズ企業が直面する5つの課題
AIエージェント導入がPoCで止まる背景には、文脈設計が十分に構造化されていないことがある。 文脈が整わなければ、AIは安定的に機能しません。
→
本格導入の停滞:人・仕組み・安全体制が整わず、スケールしない
→
運用コストの不透明化:クラウド費用・監視・例外処理が膨らむ
→
データ権限の複雑さ:何をAIに見せてよいか判断できない
→
RAGだけでは業務完遂に至らない
→
生産性貢献の可視化:AIエージェントの貢献を示せない
エージェントごとの個別作り込み
- プロンプトと参照データをエージェントごとに調整
- 業務ルールや判断基準が担当者の頭の中に残る
- 権限と出所の扱いがエージェントごとにばらつく
- 回答の誤りの原因が、どの情報にあるか追えない
コンテキストの共通基盤
- Silverデータとオントロジーを複数のエージェントが再利用
- 会議や資料から判断・経験則を抽出し、業務資産として蓄積
- 出所・権限・処理履歴をデータと一緒に保持
- 評価結果をナレッジ・ルール・評価基準へ戻して改善
→
今後12〜18カ月で、何体のAIエージェントを、何部門に展開する計画ですか。
→
エージェントが参照する業務ファイルは、誰がどの方法で整えていますか。
→
判断基準や例外対応は、文書化されていますか。担当者の経験に残っていませんか。
→
エージェントごとに、参照してよい情報の範囲をどう管理していますか。
→
回答が誤ったとき、どの情報に原因があるかを追跡できますか。
03/仕組み
コンテキストを組み立てる6層のアーキテクチャ
データから運用までを、層ごとに役割を分けて設計する。 各層は単体でも導入でき、段階的に重ねられます。どの層が不足しているかを診断し、優先順位を付けて導入します。
層
役割
内容
ケイパビリティ
L1
データ層:業務ファイルのSilverデータ化
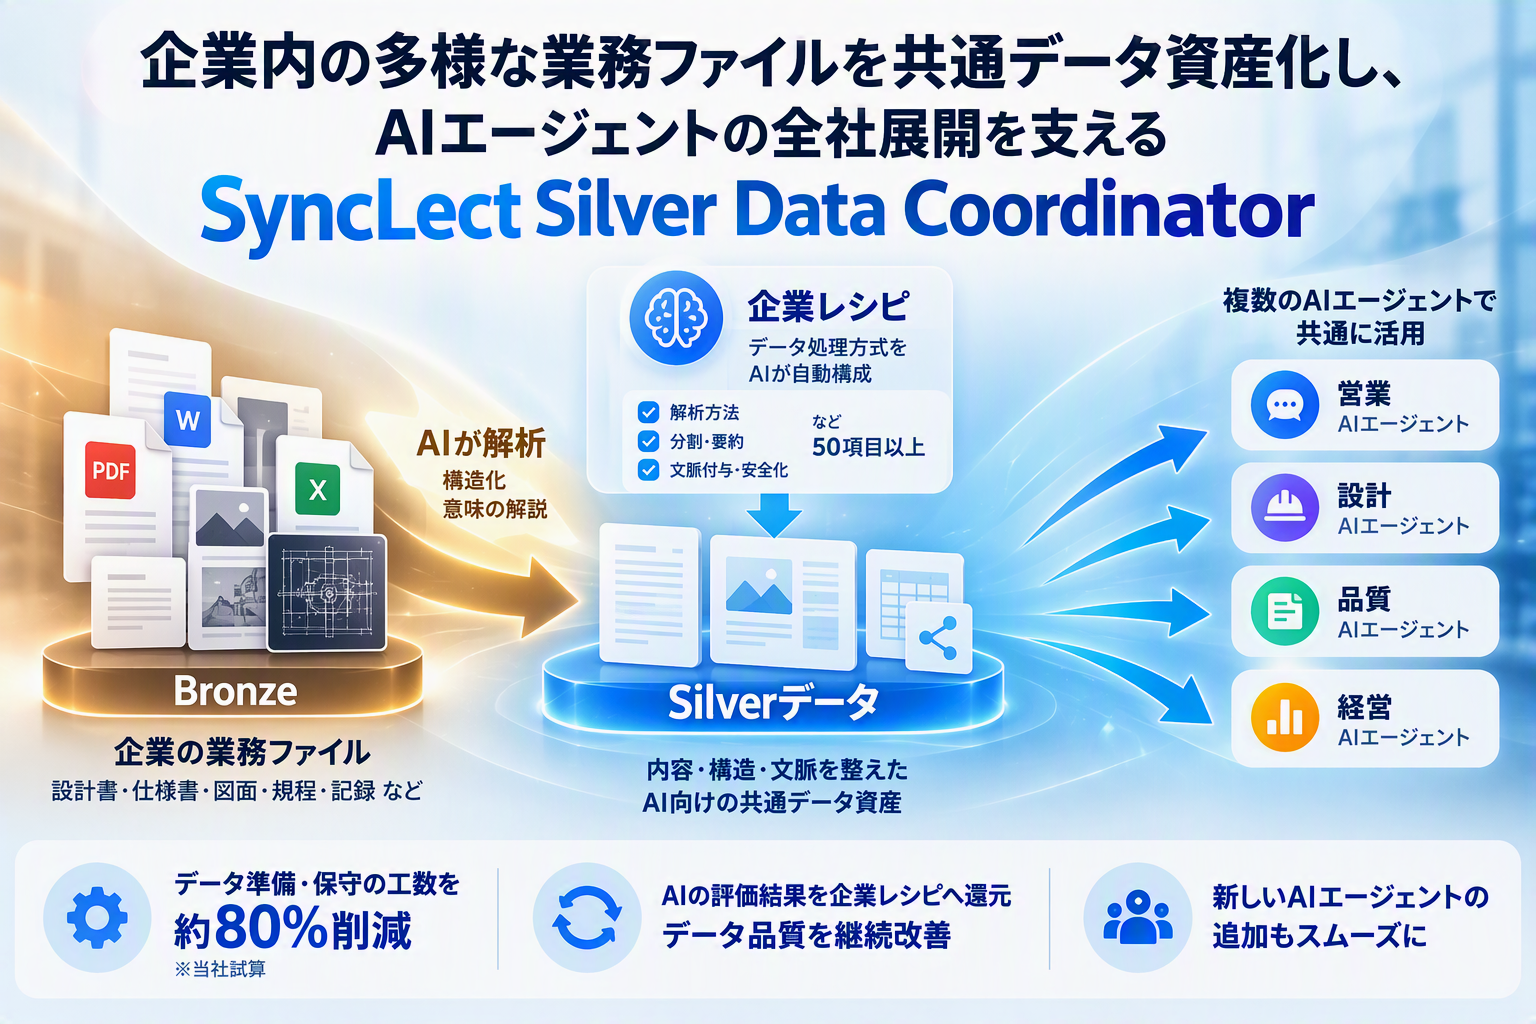
仕様書・設計書・図面・規程・対話ログを、AIが解釈できる形へ再構成し、出所・権限・処理履歴を付与して継続供給する。
SyncLect Silver Data Coordinator
L2
意味層:オントロジーとナレッジの統合
Silverデータを概念・関係・ルールへ統合し、部門ごとに異なる用語を一つの意味モデルへ揃える。
SyncLect Data Intelligence(SDI)
L3
暗黙知層:判断・経験則の抽出
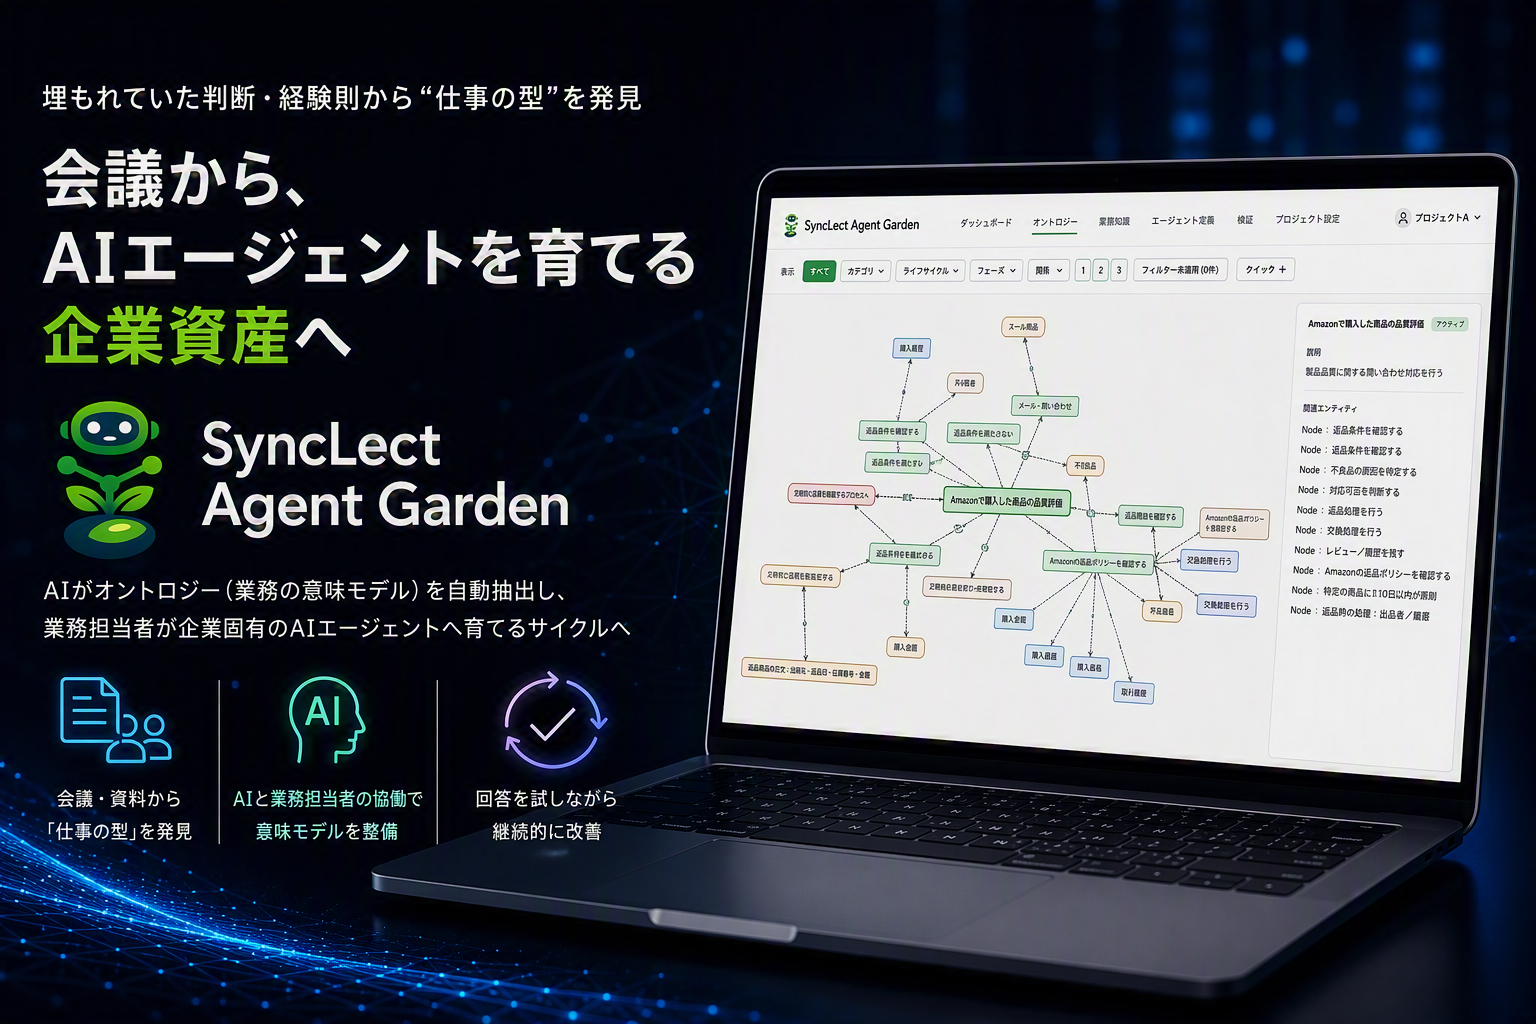
Teams会議や業務資料から判断、経験則、例外対応を抽出し、Skill・Playbookなどの仕事の型にする。
SyncLect Agent Garden
L4
取得層:検索・推論と根拠提示
多段階検索と自律的推論で、必要なコンテキストを必要な時点で取得し、回答の根拠を示す。
Agentic RAG、SyncLect AI Agent
L5
状況層:顧客・利用者コンテキスト
行動ログ・購買・対話から顧客の状況を生成し、一人ひとりに合わせた判断と画面の出し分けにつなげる。
SyncLect Personalize、Generative UI
L6
統制・運用層:権限と継続改善
ユーザーとエージェントの権限を制御し、稼働・品質・コストを観測し、評価結果をナレッジ・ルールへ戻す。
Microsoft Entra ID、Microsoft Foundry
判断時にコンテキストが届くまでの7工程
蓄える工程と、使う工程と、直す工程を、一つの循環にする。 評価の結果は、前段のデータ処理、ナレッジ、ルールへ戻ります。
1
収集・Silver化
業務ファイルと対話ログを取得し、AI向けに再構成
2
意味統合
用語・概念・関係・ルールをオントロジーへ統合
3
暗黙知の抽出
会議・資料から判断と経験則を抽出し、担当者が確認
4
取得
質問と業務に応じて、多段階検索で必要な情報を選ぶ
5
状況の付与
顧客・案件・利用者の状況を加えて、判断材料を組み立てる
6
権限制御
利用者とエージェントの権限に応じて、参照範囲を絞る
7
評価・改善
回答評価と現場の修正を、前段のデータとルールへ戻す
コンテキストエンジニアリングを中心とした5つの支援領域
業務文脈×ガバナンス×運用×エージェント基盤を、現場実装で一気通貫に支援する。 AIエージェントの安全な業務遂行体制を、次の5領域で支えます。Microsoft、Elasticなどのパートナーと連携します。検索基盤とMicrosoft Foundryによる高度なRAG基盤は、Elastic・日本マイクロソフトとの3社共同セミナーのテーマにもなっています。
1
ビジネスプロセスとワークフロー変革
業務分析、リスク・責任分解点、AIエージェントROI評価、組織体制と人材スキル
2
AIエージェントCoE・Agentic Workflow設計
AIエージェントCoE、Agentic Workflow設計、フォワードデプロイ支援
3
システム技術とセキュリティ
データプラットフォーム化、既存システム連携、認証・権限設計、データガバナンス
4
品質保証と信頼性
業務代替基準、検証プロセス、ガードレール設計
5
運用と継続改善
文書・ルール更新、ワークフロー変更時のエージェント最適化
04/特長
特長 2/4
SDIによるオントロジー統合と業務コンテキストの意味整合
部門ごとに異なる用語と関係を、一つの意味モデルへ揃える。 SyncLect Data Intelligence(SDI)は、Silverデータを概念・関係・ルールへ統合し、業務知識を企業全体で蓄積・管理・再利用する企業Knowledge基盤です。ナレッジグラフとRAGを組み合わせ、断片の検索だけでは得られない関係の把握を支えます。
特長 3/4
会議の判断・経験則を抽出する暗黙知のコンテキスト化
ファイルに書かれていない判断基準を、業務資産にする。 SyncLect Agent Gardenは、Teams会議や業務資料から判断、経験則、業務手順、例外対応を抽出し、オントロジー候補として整理します。業務担当者が選択・補完・検証し、Skill・Playbookなど、AIエージェントが使える「仕事の型」へ仕立てます。
コンテキストの欠落を防ぐ5つの設計観点
断片化による欠落
文書全体と断片の関係を補い、検索された断片だけでは意味が通らない状態を抑える。
暗黙知の欠落
ファイルに書かれていない判断基準・例外条件を、会議や担当者から抽出する。
用語の不一致
部門ごとに異なる言葉の指す意味を、オントロジーで揃える。
情報の陳腐化
新規・更新ファイルへ処理方式を適用し、最新の状態を継続供給する。
権限の逸脱
出所と権限をデータに保持し、取得の時点で参照範囲を制御する。
品質の劣化
評価と観測で変化を捉え、ナレッジ・ルールへ戻して直す。
05/顧客価値
個別作り込みから、再利用できる業務コンテキスト資産への転換
エージェントが増えても、コンテキスト準備の作業を線形に増やさない。 Silverデータ、オントロジー、仕事の型、評価基準を共通資産として蓄積し、新しいエージェントや部門へ再利用します。初期導入はFDE型で伴走し、継続運用は顧客の業務・DX担当者へ移管する進め方を想定します。
変える対象
従来
導入後に起きる価値
共通資産化
エージェント、案件、部門ごとに参照データとプロンプトを調整
Silverデータ、オントロジー、仕事の型を複数用途へ再利用し、追加時の重複準備を削減
暗黙知
判断基準が担当者の経験や会議に残り、ヒアリングに人手を要する
会議・資料から候補を抽出し、担当者の確認で業務資産化。属人化を抑える
意味の統一
部門ごとの用語の違いで、同じ質問に別の答えが返る
オントロジーで概念と関係を揃え、エージェント間で同じ意味でデータを扱う
ガバナンス
エージェントごとに権限・出所の扱いがばらつく
出所・権限・処理履歴をデータと一緒に保持し、取得時に制御。追跡と監査が成立
継続改善
誤りの原因が分からず、都度プロンプトを修正
評価と観測の結果をナレッジ・ルールへ戻し、使うほど品質が上がる
経営・事業責任者
エージェント展開に伴う準備工数の増加を抑え、コンテキストを再利用できる企業資産へ変える
AI・DX推進
個別のRAGやプロンプト調整を共通基盤化し、展開速度と品質を両立する
データ・AIエンジニア
ゼロからの設計ではなく、AI案の確認・調整と評価に集中できる
業務部門
自分たちの判断や経験則が、エージェントの仕事の型として残り、更新も反映される
営業・SIer・コンサル
診断から導入までの手順と資産が共通化され、同種案件の立ち上げを短縮できる
IT・情報セキュリティ
顧客管理環境、Entra IDによる認可、出所・アクセス範囲、監査ログを前提に設計できる
06/ユースケース・適性
製造・金融保険・交通運輸・エネルギーと、顧客接点・社内業務での活用
専門性の高い文書と、属人的な判断が多い業務ほど、コンテキスト設計の効果が出る。
01
製造
コンテキストの源 要求仕様書、製品仕様書、設計書、図面・CAD、検査・保守記録、設計レビューの会議
利用イメージ 営業・提案、設計、品質、保守のエージェントへ、図面や仕様の関係と設計判断の経緯を含めて供給します。
02
金融・保険
コンテキストの源 法令・規制文書、融資・審査資料、保険約款、社内規程、審査会議の判断
利用イメージ 照会、審査、コンプライアンス確認で、規程の根拠と過去の判断基準を、権限に応じて参照させます。
03
交通・運輸
コンテキストの源 運行規程、保安文書、整備記録、運行・運航マニュアル、現場の対応事例
利用イメージ 運行支援、安全管理、整備・保守で、規程と現場の経験則をあわせてエージェントに渡します。
04
エネルギー・インフラ
コンテキストの源 設備図面、保安規程、点検記録、工事・運転マニュアル
利用イメージ 設備保全、安全管理、現場支援に利用します。閉域環境での利用にも対応します。
05
顧客接点・パーソナライズ
コンテキストの源 対話ログ、問い合わせ履歴、商品資料、行動・購買ログ、会員情報
利用イメージ 顧客の状況と商品・規程の情報を組み合わせ、問い合わせ回答と提案を一人ひとりに合わせます。
06
全社の業務エージェント運用
コンテキストの源 社内規程、問い合わせログ、エージェント定義、利用状況、評価結果
利用イメージ 社内ヘルプデスクや申請業務のエージェントを、共通のコンテキストと運用手順で統制・改善します。
コンテキストエンジニアリング導入適性チェック
御社に当たるか、次の観点で自己診断できます。
適合する顧客
- 複数のAIエージェントを、複数部門で展開する計画がある
- 専門性の高い文書や、図表・図面を多く保有している
- 判断基準や例外対応が、担当者や会議に残っている
- 部署・役割で参照してよい情報が分かれている
- エージェントの回答品質を、継続的に測って直したい
- プロンプト調整やRAGの個別改善に限界を感じている
適合しにくい顧客
- 単一のチャットボットを一度作るだけで、拡張の予定がない
- 参照する情報が少数で、更新もほとんどない
- 構造化データの統合だけが目的である
- 人の確認なしに、業務知識の正しさを保証してほしい
- データや業務ルールの責任者を決められない
コンテキスト設計のDiscovery質問
→
エージェントに使わせたい情報は、どこに、どの形式で、どれだけありますか。
→
表・図・CADなど、文字抽出だけでは意味が落ちる資料はありますか。
→
判断基準や例外対応を、誰が持っていますか。会議で決まることは多いですか。
→
部門間で、同じ言葉が違う意味で使われている例はありますか。
→
部署・役職・案件によって、参照できる情報は分かれていますか。
→
回答品質を、現在どの指標でどう測っていますか。誤りはどう直していますか。
→
Microsoft Fabric、Databricks、Azure AI Search、Foundry、Copilot Studioなどを利用していますか。
→
個人情報のマスキングや、データを管理外へ持ち出せない制約はありますか。
07/想定ROI
コンテキスト準備工数と運用コストの測定・削減
以下は実績値ではなく、前提を置いた参考試算です。実際の効果は、文書の種類と量、更新頻度、エージェント数、品質要件、利用環境によって異なります。一律の削減率や投資回収期間を約束するものではありません。
層ごとに、削減の根拠となる指標が異なる。 例えばSilverデータ化の層では、当社試算で、1つの業務ファイル種別あたりの初期設計・調整が約26時間から約5時間(約80%減)となる見込みです。他の層は、現行の工数を測定したうえで効果を見積もります。
→
準備工数 業務ファイル種別あたりの初期設計・調整時間、ヒアリング時間、外部委託費
→
再利用 Silverデータ・オントロジー・仕事の型の再利用率、同一資産を使うエージェント数
→
継続供給 月間の新規・更新ファイル数、反映までの時間、処理成功率
→
回答品質 必要情報の取得率、元情報への忠実性、回答の修正率、原因調査時間
→
ガバナンス 出所追跡率、権限逸脱件数、監査対応時間
→
運用コスト エージェントあたりの稼働・トークンコスト、改善サイクルの所要時間
まず代表的な業務とエージェント1〜2件でコンテキストの棚卸しと試作を行い、御社の現行工数と回答品質を測定したうえで、試算を実測値に置き換えてご判断いただきます。
08/導入ステップ
コンテキスト棚卸しから横展開・運用までの5段階導入
不足している層から、小さく測って始める。 全層を一度に導入するのではなく、診断で特定した層から段階的に重ねます。
STEP 1
Context Diagnostic
対象業務、情報源、判断基準、権限を棚卸しし、6層のどこが不足かを診断
成果物:コンテキストマップ、優先順位
STEP 2
Pilot
1〜2業務で、不足する層を試作し、Before/Afterを評価
成果物:Silverデータ、仕事の型、評価質問
STEP 3
Production
接続、権限、監査、更新ジョブを含め本番化
成果物:運用設計、権限設計
STEP 4
Expansion
他の業務、部門、エージェントへ資産を横展開
成果物:コンテキスト資産ライブラリ
STEP 5
Operations
観測・評価・承認の運用サイクルを定着
成果物:運用手順、改善レポート
09/競合・代替比較
個別RAG・データ基盤・エージェントビルダーと連携するコンテキスト層
既存の基盤は置き換えず、不足するコンテキストの層を補う。 Microsoft Azureを基盤として活用し、Microsoft FabricやDatabricks、Azure AI Search、Elasticsearch、Microsoft Foundry、Copilot Studioなどと連携します。置き換える対象は、エージェントごとに個別設計していた、コンテキスト準備の人手作業です。
選択肢
主にできること
コンテキストエンジニアリングの位置
プロンプト改善・個別RAG
特定のエージェントの回答を短期間で改善
個別改善で得た知見を、共通のデータ・意味・ルール資産へ還元する
Microsoft Fabric・Databricks等
構造化データの統合、基盤ガバナンス、AI機能
競合ではなく連携。業務ファイルや会議由来の非構造コンテキストを補完供給する
Foundry・Copilot Studio等のエージェントビルダー
エージェントの構築・実行・展開
連携先として活用し、エージェントに渡すコンテキストの設計と運用を担う
AgentOps・観測ツール
稼働・品質・コストの観測と評価
Microsoft Foundryなどと連携して運用の層を担い、評価結果を前段のコンテキストへ戻す
SIer・社内個別開発
要件への柔軟な適合
個別の知見を処理部品・オントロジー・評価資産へ還元し、反復可能にする
10/セキュリティ・ガバナンス
権限・出所・監査を前提にしたコンテキストの安全な供給
コンテキストは、渡す範囲を決めて初めて本番で使える。 機密性の高い文書や対話ログも、顧客が管理する環境内で処理でき、既存のネットワーク、認証、アクセス制御、データ管理方針に沿った構成を取ります。
データ処理としての安全化
- 個人情報の検出・マスキング
- ファイル内の命令文をシステム指示として扱わない安全化(プロンプトインジェクション対策)
- 出所・所有者・組織・アクセス範囲・処理履歴の保持
機能の範囲について
元ファイルや接続先に存在しない業務事実を創作・確定するものではありません。会議から抽出した判断・経験則は候補であり、業務担当者が確認・補完して確定します。AIが処理方式や候補を構成し、人が必要に応じて確認・調整します。
11/当社について
コンテキストエンジニアリングの提供体制を強化(2026年2月発表)
ヘッドウォータースは、これまでRAG精度改善を中心に、10社以上のエンタープライズ企業へ文脈設計を提供してきました。製造業、金融、自動車・輸送業界など、複雑かつ高い正確性が求められる領域で採用が進んでいます。Microsoft、Elasticなどのパートナーと連携し、業務文脈×ガバナンス×運用×エージェント基盤を一気通貫で提供するフォワードデプロイエンジニアリングの体制を整えています。今後は、業界・業務特化型の文脈設計を抽象化・再利用し、品質を継続的に高める「動的文脈インフラ」の整備を進めます。
Microsoft Azure の AI Platform/Agentic DevOps Specialization取得
ヘッドウォータースは「Microsoft Solutions Partner for Digital & App Innovation(Azure)」の認定に加え、上位資格である「AI Platform on Microsoft Azure」「Agentic DevOps with Microsoft Azure and GitHub」の2領域のSpecializationを取得しています。厳格な技術要件と導入実績を満たしたパートナーのみに付与される称号で、2領域の同時取得は国内でも限られています。
Microsoft AI Innovation Partner of the Year 2024 受賞
「AI イノベーション パートナー オブ ザ イヤー アワード」は、マイクロソフト製品の活用によってAI分野で革新を起こしたパートナーに贈られるアワードとして2024年に新設され、ヘッドウォータースは同分野において最も優れた実績をあげたとの評価を受け、初代受賞パートナーとなりました。日本航空(JAL)様のSLM活用や大和証券様のAIオペレーター、JR西日本様の「Copilot for 駅員」など、エンタープライズ企業向けの大規模AIエージェント開発を数多く手がけてきた実績が評価の背景にあります。
Agentic Work Flowで正答率99%を達成
ヘッドウォータースは、複数のAIエージェントが連携するAgentic Work Flowにおいて、正答率99%という高い精度を達成しています。AIエージェントの品質を担当者の経験に依存させず組織として再現する取り組みの実績であり、エージェントに渡すコンテキストの品質と再現性を重視する本サービスの設計とも通じるものです。
12/関連ソリューション
6層を構成する個別サービスは、単体でも導入できる。 不足している層から選び、段階的に組み合わせられます。

検索基盤とRAGを、
3社で解説する。
Elastic・日本マイクロソフトとの共同セミナー. Context Engineeringの本質と、ElasticsearchとMicrosoft Foundryによる高度なRAG基盤を、ヘッドウォータース、Elastic、日本マイクロソフトの3社で解説した特別セミナー(2026年2月5日、オンライン)です。

業務データを、自律的に検索して
根拠付きで答える。
Agentic RAG. 多段階検索と自律的推論を備え、業務特化型のエージェントが、社内データを参照して根拠を示します。
13/よくあるご質問
Q. コンテキストエンジニアリングとは何ですか。
A. AIが状況に応じて適切な判断と行動を選択できるよう、目的・状態・ルール・制約・環境・履歴といった動的文脈を構造化し、実行時に供給し続ける技術です。2025年にAnthropic社が体系化した潮流で、プロンプトの工夫は、その一部にあたります。
Q. どのような支援領域がありますか。
A. ビジネスプロセスとワークフロー変革、AIエージェントCoE・Agentic Workflow設計・フォワードデプロイ支援、システム技術とセキュリティ、品質保証と信頼性、運用と継続改善の5領域で、文脈設計から運用・改善までを一気通貫で支援します。
Q. プロンプトエンジニアリングやRAGと何が違いますか。
A. プロンプトは指示文、RAGは検索の仕組みです。コンテキストエンジニアリングは、検索される情報の準備、意味の統一、暗黙知の取り込み、権限制御、評価までを含めた設計の範囲を指します。
Q. 全ての層を導入する必要がありますか。
A. いいえ。診断で不足している層を特定し、そこから段階的に導入します。各層のサービスは単体でも導入できます。
Q. オントロジーは、自動で作られますか。
A. AIが業務資料や会議から候補を抽出し、業務担当者が選択・補完・検証して確定します。人の確認を前提に、ゼロからの作成負荷を下げます。
Q. Microsoft FabricやDatabricks、Copilot Studioと競合しますか。
A. 競合しません。構造化データの統合やエージェントの構築・実行は既存の基盤で行い、本サービスは業務ファイルや会議由来のコンテキストの設計・供給・運用を補完します。
Q. どこで動きますか。
A. Microsoft Azureを基盤として実装しており、顧客が指定するクラウド環境またはオンプレミス環境へ配置します。機密性の高いデータを顧客の管理外へ持ち出さず処理できます。
Q. 効果はどのくらいですか。
A. 一律の削減率はお約束できません。一例として、Silverデータ化の層では、当社試算で業務ファイル種別あたりの初期設計・調整工数を約80%削減できる見込みです。導入時に現行工数と回答品質を測定して検証します。
Q. 最初は何から始めればよいですか。
A. 対象業務とエージェント1〜2件を選び、コンテキストの棚卸しと診断(Context Diagnostic)から始めます。診断結果をもとに、不足する層の試作へ進みます。
コンテキストエンジニアリングについてのご相談
コンテキストの棚卸しと、不足する層の診断から、導入と運用の設計まで、貴社の状況に合わせてご提案します。
お問い合わせ