HOME/ビジネス/AIソリューション/Microsoft Purviewソリューション

Microsoft Purviewソリューション
データガバナンス・⁠情報保護・AI Ready Dataの設計と実装

Microsoft社の「Microsoft Purview」を、AI活用を前提としたデータガバナンス基盤として設計・⁠実装します。データの発見・⁠分類・⁠品質・⁠責任者・⁠アクセス管理から、秘密度ラベルとDLPによる情報保護、Microsoft Fabric・Microsoft Foundryと連携したAIエージェントへのデータ供給まで、構想から全社展開までを支援します。

01/概要

Microsoft Purviewとは:データの所在把握・⁠分類・⁠保護・⁠監査を担う統合データガバナンス基盤

Microsoft Purviewは、オンプレミス・⁠マルチクラウド・SaaSに散らばるデータを対象に、どこにどんなデータがあるかを把握し、機密情報を分類・⁠保護し、正しく使わせ、監査や規制対応まで行うためのMicrosoftの統合ソリューションです。構造化データと非構造化データの両方を扱えます。かつてはデータを見つけて整理するガバナンス機能(Azure Purview)と、データを守って監査するMicrosoft 365側のコンプライアンス機能が別々に提供されていましたが、現在はひとつのブランドに統合されています。機能は大きく次の3領域に分かれます。

領域
役割
主な機能
Data Security
データのライフサイクル全体を保護する
情報保護(秘密度ラベル)、データ損失防止(DLP)、インサイダーリスク管理
Data Governance
データを発見・⁠理解し、責任を持って活用する
Data Map、Unified Catalog、データ分類、データ品質、Data Estate Health
Data Compliance
規制要件と重大なリスクを管理する
監査、電子情報開示(eDiscovery)、コンプライアンスマネージャー

02/注目される背景

AIエージェントの全社展開で問われる、データの所在・⁠権限・⁠品質・⁠業務コンテキスト

企業のAI活用は、社内文書を参照するRAGから、企業データや業務システムに接続して判断・⁠実行を担うAIエージェントへと広がり、PoCや個別業務での活用から複数部門・⁠全社への展開へ移っています。AIに渡すデータが増えるほど、どのデータを、誰の権限で、どの品質で、どんな業務コンテキストとともにAIに見せてよいかを、データ基盤の側で説明できることが求められます。

データの所在が分からない

部門やシステムごとにデータが分散し、AIや分析に使えるデータがどこにあるかを誰も一覧できない。

AIに見せてよい範囲が決まらない

機密情報や個人情報の分類がなく、AIエージェントに渡すデータの範囲を判断できない。

データの責任者がいない

データの意味・⁠品質・⁠利用可否を判断する所有者が決まっておらず、問い合わせが情報システム部門に集中する。

品質が測られていない

欠損や重複、定義の揺れが放置され、AIの回答や分析結果の信頼性を説明できない。

アクセス申請が属人的

データの利用申請と承認がメールや口頭で行われ、誰に何を許可したかを追えない。

基盤だけが先に広がる

データ基盤の利用者が増えるほど、権限・⁠コスト・⁠ルールが追いつかず、全社展開の手前で止まる。

03/構成要素

主要機能:Data Map・Unified Catalog・データ品質・⁠秘密度ラベル・DLP

データガバナンスでは、データ資産の地図をつくり、業務部門が探して使えるカタログにし、品質を測ります。データセキュリティでは、機密情報にラベルを付け、持ち出しや逸脱を検知します。

DATA GOVERNANCE

Data Map

社内外のデータソースをスキャンし、データ資産、スキーマ、分類、データの系列(リネージ)を地図として可視化します。
DATA GOVERNANCE

Unified Catalog

ガバナンスドメイン、データ製品、用語集、重要データ要素(CDE)を管理し、業務部門がセルフサービスでデータを探して申請できるようにします。
DATA GOVERNANCE

データ品質

データのプロファイリング、品質ルール、品質スキャンで、ドメイン・⁠データ製品・⁠データ資産の単位で品質を数値化します。
DATA GOVERNANCE

Data Estate Health

データ製品のスコアやHealth Controlで、データ管理の状態を継続的に評価し、改善の優先度を決めます。
DATA SECURITY

秘密度ラベル・⁠自動ラベル付け

文書やメール、SharePoint・Teamsのサイトに秘密度ラベルを付け、機密度の高いデータを自動で検出・⁠保護します。
DATA SECURITY

データ損失防止(DLP)

外部共有や持ち出しなど、機密情報が意図せず流出する操作を検知・⁠制御します。
DATA SECURITY

インサイダーリスク管理

利用者の操作から、通常と異なるデータの扱いを検知し、調査につなげます。
DATA COMPLIANCE

監査・eDiscovery

操作ログの監査と電子情報開示で、内部統制や規制当局への説明に必要な記録を残します。

04/進め方

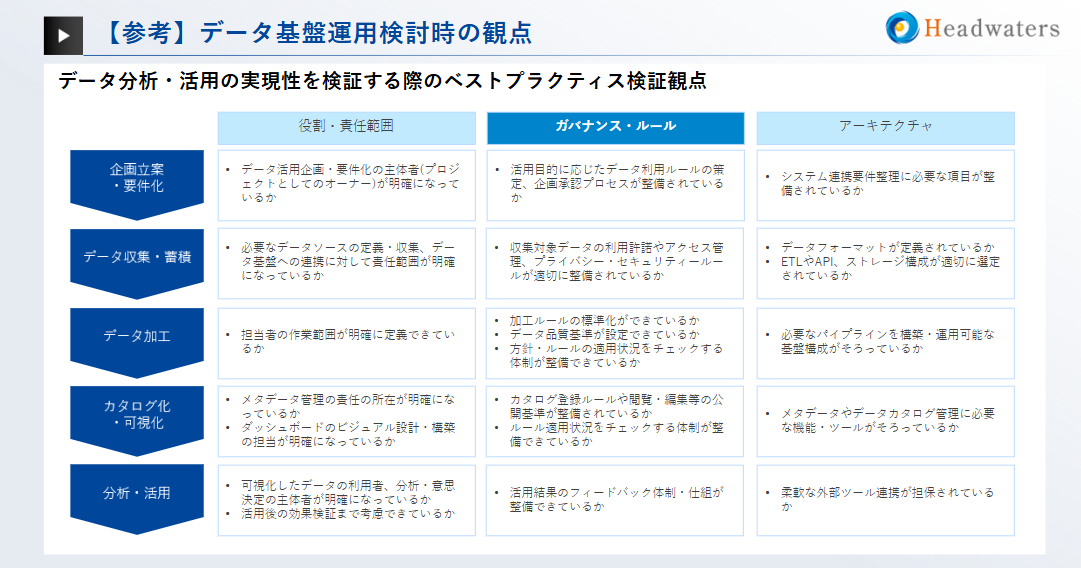
データガバナンス実装のライフサイクル:ドメイン設計からスキャン監視まで

Purviewのデータガバナンスは、製品を有効にするだけでは機能しません。データ資産の管理単位と責任者を決め、データソースをつなぎ、スキャンと分類を回し続ける運用として設計します。

STEP 1ドメイン・⁠コレクション設計事業や組織に合わせて、データ資産を管理する単位を決めます。
STEP 2ロール割り当て管理者、データソース管理者、キュレーター、閲覧者などの権限を割り当てます。
STEP 3データソース登録Fabric、Azure、Microsoft 365、オンプレミスなどのデータソースを接続します。
STEP 4スキャン設定スキャンの範囲と頻度を決め、データ資産を自動で取り込みます。
STEP 5分類・⁠所有者・⁠系列の整備スキーマ、データ所有者、リネージ、分類を整え、資産に意味と責任を持たせます。
STEP 6スキャン監視スキャンの結果と失敗を監視し、新しいデータの取り込みを運用として回します。
データの成熟の流れ
データマップ→統合カタログ→データ製品→データ品質→データアクセス
データマップで資産を把握し、統合カタログで業務の言葉に結び付け、データ製品として公開し、品質を測り、アクセス申請・⁠承認のワークフローで利用者に届けます。

05/当社の支援

Purview × Fabric × Foundry:AI Ready Dataを供給するデータライフサイクル

Microsoft Purview自体の提供元はMicrosoft社で、当社は設計・⁠実装・⁠運用・⁠定着を担います。当社はPurviewを単独のセキュリティ製品としてではなく、AIが安心して使えるデータを整えるデータライフサイクルの起点として設計します。Purviewで企業データを発見・⁠分類・⁠統制し、Microsoft Fabricでクレンジング・⁠統合し、Microsoft FoundryやAIエージェントに供給します。AIに渡す業務の意味や判断基準は、コンテキストエンジニアリングとして同じ基盤の上で設計します。

発見・⁠分類

Microsoft Purview

企業内のデータを発見し、分類・⁠責任者・⁠アクセス権を付けて、AIに渡してよいデータを明らかにします。
整備・⁠統合

Microsoft Fabric

OneLakeを中心にデータを統合し、クレンジングして、業務部門とAIが使える形に整えます。
活用

Foundry・AIエージェント

Microsoft Foundry、Copilot Studio、Microsoft 365 Copilotで、統制されたデータを業務のAIエージェントに供給します。

06/支援メニュー

6つの支援メニュー:ガバナンス構想からAIエージェントへのデータ供給まで

お客様のデータ基盤とAI活用の段階に合わせて、必要なメニューから組み合わせます。

01

データガバナンス構想・⁠設計

全社でのデータ活用を前提に、ガバナンスドメイン、データ所有者、データスチュワード、ポリシー、役割と責任、運用モデルを設計します。
02

データカタログ・⁠メタデータ管理

Data MapとUnified Catalogで、データ資産、リネージ、分類、用語集、重要データ要素(CDE)、データ製品を整備します。
03

データ品質・Data Estate Health

プロファイリング、品質ルール、品質スキャン、Health Controlを組み合わせ、データ品質を継続的に監視・⁠改善します。
04

Fabric全社データ基盤との一体設計

Microsoft Fabricを中核とした統合データ基盤の設計と、Purviewによるガバナンス設計を一体で行います。
05

情報保護・⁠データセキュリティ

秘密度ラベル、自動ラベル付け、DLP、インサイダーリスク管理、SharePoint・Teamsのラベル設計を組み合わせて、情報を保護します。
06

AI Ready Data・AIエージェント連携

Purviewで統制したデータをFabricで整え、Microsoft FoundryやAIエージェントへ供給するデータライフサイクルを設計します。

07/特長

特長 1/4

Fabricの全社展開に組み込むPurviewのガバナンス設計

当社はMicrosoft Fabricの全社データ基盤の構築を支援し、その中でPurviewによるガバナンス設計を行っています。OneLakeを中心としたデータ統合、Capacityを考慮したコストと性能の設計、統合カタログとメタデータ管理を同じ計画の中で扱うため、基盤の利用者が増えても権限とルールが後追いになりません。

特長 2/4

データ製品として、業務部門に届けるカタログ設計

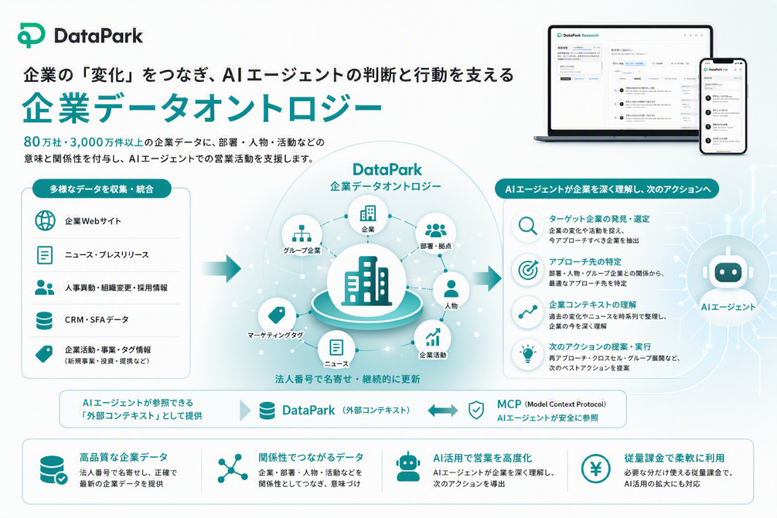
データを登録して終わるカタログではなく、ガバナンスドメイン、データ製品、重要データ要素(CDE)、セルフサービスのアクセス申請までを設計し、業務部門が自分で探し、意味を理解し、申請して使える状態にします。データ製品の考え方は、当社のDataParkにも通じています。

特長 3/4

品質を測り続ける運用と、段階的な情報保護

品質ルールと品質スキャン、Data Estate Healthで品質を継続的に評価する運用を設計します。情報保護は、Microsoftが示す展開モデル(Foundational・Managed・Optimized・Strategic)に沿って、Microsoft 365の新規データから既存データ、さらにAzure SQLなどMicrosoft 365以外のデータへと保護の範囲を段階的に広げます。

特長 4/4

AIエージェントとコンテキストへの接続

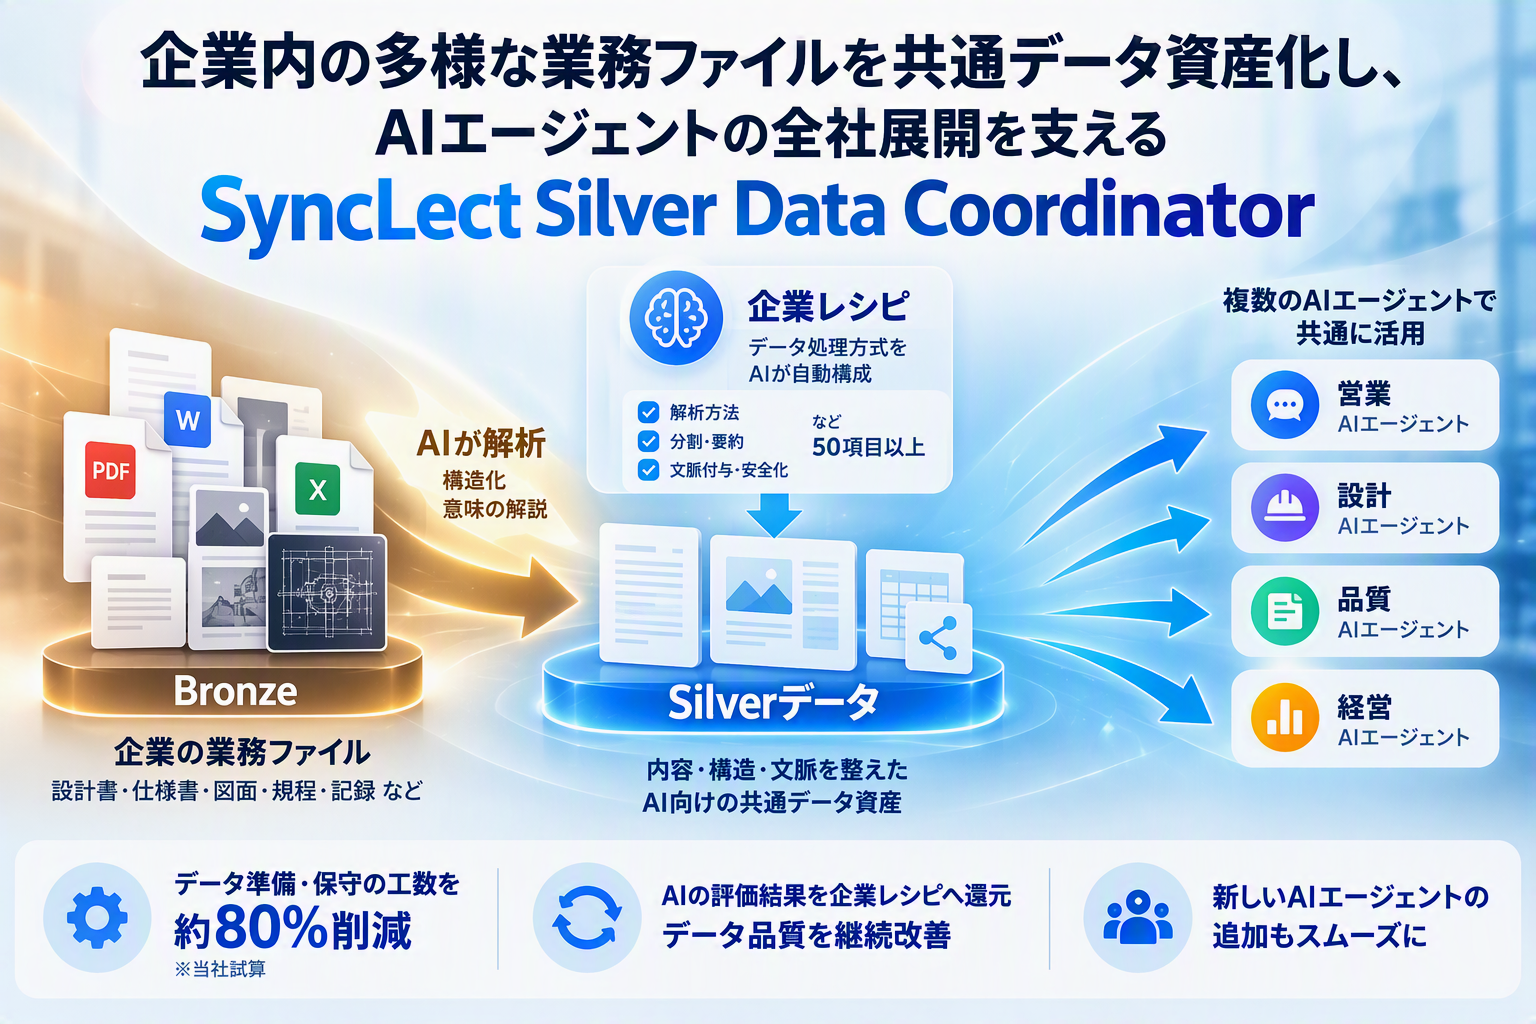
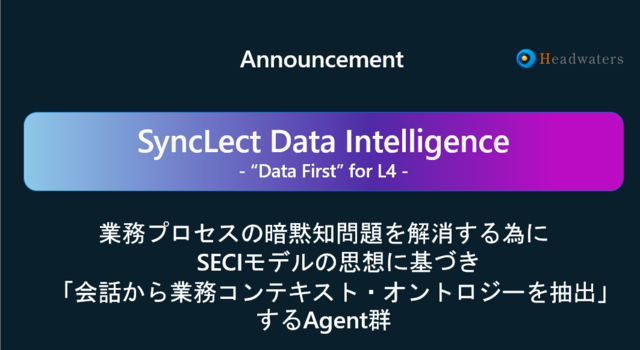
Purviewで統制したデータを、Microsoft FoundryやCopilot StudioのAIエージェントに供給します。業務ファイルのAI-Ready化はSyncLect Silver Data Coordinator、業務の意味や関係の統合はSyncLect Data Intelligence、エージェントのIDと権限はMicrosoft Entra IDとAgent 365で扱い、データからエージェントまでの統制を揃えます。

08/事例

Fabric全社データ基盤へのガバナンス組み込み事例

AI活用を前提としたFabric全社統合データ基盤の構築支援
エネルギー・⁠インフラ企業様

AI活用を前提としたFabric全社統合データ基盤の構築支援

全社横断のデータ活用と生成AIの利活用を見据え、Microsoft Fabricを中核とした統合データ基盤の構築を支援しました。OneLakeを中心としたデータ統合に加え、Microsoft Purviewによるガバナンス設計や、Capacityを考慮したコスト・⁠性能設計を行い、エンタープライズ規模でも安全かつ安定して利用できる基盤を整備しています。段階的なPoCと構想策定を通じて、AI Readyなデータプラットフォームの実現を目指しました。
全社展開を前提としたデータ分析基盤のガバナンス・運用設計
グローバル自動車メーカー様

全社展開を前提としたデータ分析基盤のガバナンス・⁠運用設計

利用者の拡大に伴って課題となるガバナンス、セキュリティ、コスト管理の観点から、Fabricを安全かつ継続的に利用するための運用ルールや管理プロセスを整理しました。本格展開に先立って検証モデル(PoC)を構築し、データ配置方針やPower BIとの連携方法を実運用に近い形で検証することで、段階的な展開を可能にしました。

09/顧客価値

課題・⁠打ち手・⁠価値の因果と、役割別の効果

よくある課題
Purviewで行うこと
得られる価値
データの所在が分からず、探すのに時間がかかる
Data Mapでデータ資産をスキャンし、統合カタログで業務の言葉から検索できるようにする
分析やAI開発のデータ準備時間が短くなる
AIに見せてよいデータを判断できない
秘密度ラベルと分類で機密情報を識別し、アクセス権と結び付ける
AIエージェントに渡すデータの範囲を説明できる
データの意味と品質を誰も保証していない
データ製品ごとに所有者とスチュワードを置き、品質ルールで測る
AIの回答や分析の根拠を、データの側から説明できる
アクセス申請と承認が追えない
Unified Catalogのアクセス申請・⁠承認ワークフローに集約する
誰に何を許可したかが記録され、監査対応が早くなる
基盤の利用拡大にルールが追いつかない
ドメイン設計とロール設計を、データ基盤の全社展開と同時に行う
PoCから全社展開まで、統制を保ったまま広げられる

CDO・データ戦略部門

全社のデータ資産とその品質を一覧でき、データ製品ごとの責任者を明確にして、データ活用の進み具合を説明できます。

情報システム・⁠セキュリティ部門

機密情報の所在と保護の状態を把握し、外部共有や持ち出しを統制しながら、問い合わせ対応を業務部門の所有者へ移せます。

業務部門

必要なデータをカタログから自分で探し、意味と品質を確認したうえで、申請して使えます。

AI推進・DX部門

AIエージェントに渡すデータの範囲と根拠を説明でき、PoCから本番・⁠全社展開への審査を通しやすくなります。

10/ユースケース

業界別ユースケースと、適合する企業・Discovery質問

MANUFACTURING

製造業

設計・⁠生産・⁠品質・⁠需給のデータを横断して管理し、全社展開に耐えるガバナンスと運用を整えます。
ENERGY

エネルギー・⁠インフラ

全社統合データ基盤に、ガバナンス設計とコスト・⁠性能設計を組み込み、AI活用の前提を整えます。
FINANCE

金融・⁠保険

顧客情報や取引データの分類・⁠保護と監査証跡を整え、規制対応とAI活用を両立します。
RETAIL

流通・⁠サービス

店舗・⁠顧客・⁠販売のデータをカタログ化し、BIとAIで使うデータの品質と権限を揃えます。
EDUCATION

教育・⁠研究機関

教務・⁠研究・⁠人事・⁠財務などに分散したデータを統合し、利用者ごとのアクセス管理を設計します。
ENTERTAINMENT

エンターテインメント

IP・商品・⁠売上データの意味を揃え、グループ横断でのデータ活用と権利情報の管理を支えます。
適合する企業
  • Microsoft 365・Azure・Microsoft Fabricを全社で利用している、または導入を予定している
  • AIエージェントや生成AIを、個別部門から全社へ広げようとしている
  • データの所有者や品質の責任が曖昧で、問い合わせが情報システム部門に集中している
  • 機密情報の分類と保護を、監査や規制対応の観点から見直したい
適合しにくい企業
  • データ量や利用部門が少なく、台帳での管理で十分に運用できている
  • Microsoft以外のデータ基盤に統一しており、Microsoft 365・Azureを利用していない
  • データの責任者を置く組織的な合意が当面取れない
最初の打ち合わせでお聞きすること
  1. AIや分析に使いたいデータは、どのシステムに、どの程度ありますか。
  2. データの所有者や、意味・⁠品質を判断する担当者は決まっていますか。
  3. データの利用申請と承認は、いまどのように行っていますか。
  4. 機密情報や個人情報の分類ルールと、ラベル付けの状況を教えてください。
  5. Microsoft Fabricや他のデータ基盤の利用状況と、全社展開の予定はありますか。
  6. AIエージェントに渡したいデータと、渡してはいけないデータの例はありますか。

11/想定ROI

データ探索・⁠アクセス申請・⁠機密データ棚卸しの工数試算

従業員数千人規模、データ分析者50名の企業を想定した年間の試算です。パイロット期間に現行工数を測り、お客様の数値で置き換えます。

項目
前提
現状
導入後
削減(年)
データ探索・⁠所在確認
分析者50名が、データを探す・⁠確認する作業に費やす時間
週3時間/人
週1.5時間/人
約3,900時間
データアクセス申請・⁠承認
月200件の申請。確認・⁠承認・⁠設定の往復
2時間/件
0.5時間/件
約3,600時間
機密データの棚卸し
年2回の棚卸しを、自動分類と秘密度ラベルで省力化
400時間/回
120時間/回
約560時間
監査・⁠規制対応の資料準備
年1回の監査で、データの所在・⁠権限・⁠操作記録を説明
300時間
120時間
約180時間
AI活用案件のデータ準備
年6案件。データの特定・⁠権限確認・⁠品質確認
160時間/件
100時間/件
約360時間
合計 年間約8,600時間の工数削減(試算)
Purviewのライセンス・⁠従量課金と、当社の支援費用は含みません。

12/他の手段との違い

台帳管理・⁠製品単体の導入との違い

観点
Excel・台帳での管理
製品を導入するだけ
当社のPurviewソリューション
データの所在
手作業で更新し、実態とずれる
スキャンで自動的に把握できる
スキャン範囲と頻度を、業務とコストに合わせて設計する
責任と役割
担当者の個人の知識に依存する
ロールはあるが、誰に割り当てるかが決まらない
ドメイン所有者・⁠データ製品所有者・⁠スチュワードを組織に合わせて決める
品質
問題が起きてから気付く
機能はあるが、ルールが作られない
品質ルールとHealth Controlを運用に組み込む
情報保護
部門ごとの判断になる
ラベルを作っても付与が進まない
展開モデルに沿って、自動ラベル付けとDLPを段階的に広げる
AIへの接続
AIに渡す範囲を説明できない
データ基盤やAIとは別の取り組みになる
Fabric・Foundry・AIエージェントと一体で設計する

13/ガバナンス

ロール設計と責任分界:ドメイン所有者・⁠データ製品所有者・⁠データスチュワード

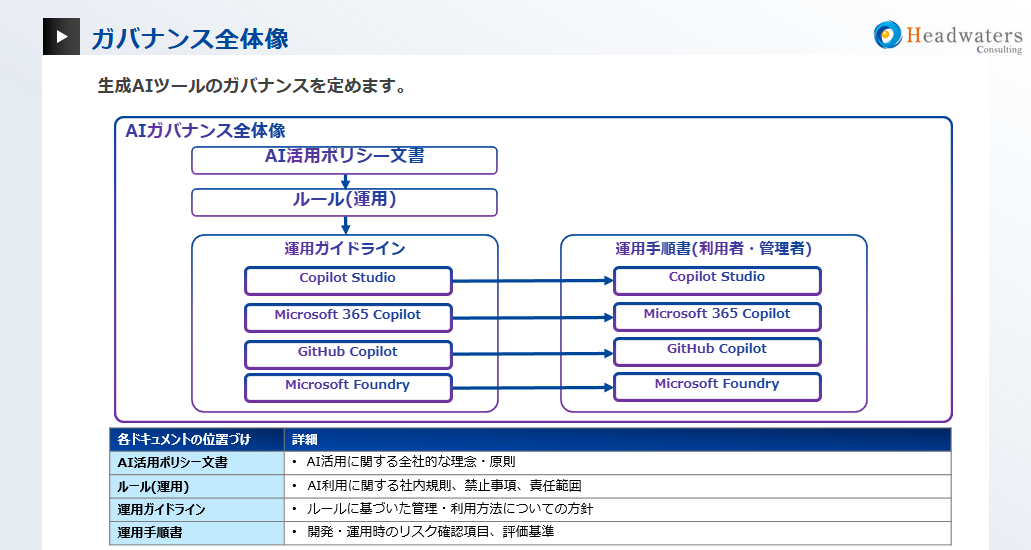
データガバナンスが続くかどうかは、誰がデータに責任を持つかで決まります。Purviewのロールを、お客様の組織と業務の責任に合わせて割り当てます。

ガバナンスドメイン所有者

事業や組織の単位でドメインを管理し、ポリシーとデータ製品の公開を判断します。

データ製品所有者

データ製品の目的、利用者、アクセス条件を定め、利用申請を承認します。

データスチュワード

用語集や重要データ要素(CDE)を整え、品質ルールの設定と改善を担います。

コレクション管理者・⁠データソース管理者

Data Mapのコレクションとデータソースを管理し、スキャンの設定と監視を行います。

データキュレーター・⁠閲覧者

データ資産のメタデータを更新し、または参照します。

情報保護の管理者

秘密度ラベルとDLPのポリシーを管理し、インサイダーリスクのアラートを確認します。

14/当社について

Microsoftソリューションパートナーとしての認定とData&AIの実績

Microsoft ソリューションパートナー

Data & AI と Digital & App Innovation の認定を取得し、Azure PaaS開発、クラウドネイティブ、マネージドサービスを提供しています。

AI Platform on Microsoft Azure Specialization

第三者審査で全要件に適合し、更新認定を取得しました。AIエージェントの全社展開に向けて、Microsoft Fabric、Microsoft Entra ID、Microsoft Purview、Microsoft Defenderなどへ対応領域を広げています。

Agentic DevOps with Microsoft Azure and GitHub Specialization

AI Platformとあわせて2領域のSpecializationを取得し、AI基盤からGitHubを活用したDevOpsまでを扱います。

Microsoft AI Innovation Partner of the Year 2024

マイクロソフト製品の活用でAI分野に革新を起こしたパートナーとして、初代の受賞パートナーに選ばれました。

15/はじめ方

スタートプラン:パイロットドメインから始める5ステップ

全社のデータを一度に対象にせず、効果を測りやすい1つの業務領域(パイロットドメイン)で運用を検証してから、全社へ広げます。

STEP 1現状アセスメントデータソース、分類、権限、申請の流れ、Fabricなどデータ基盤の利用状況を整理します。
STEP 2パイロットドメインの選定効果を測りやすい業務領域を1つ選び、所有者とスチュワードを決めます。
STEP 3PoCData Map、統合カタログ、品質ルール、秘密度ラベルを対象領域で動かし、現行工数と比べます。
STEP 4ロードマップと運用設計ドメインの広げ方、ロール、ポリシー、運用体制、コストの計画を作ります。
STEP 5全社展開と定着ドメインを順に広げ、AIエージェントへのデータ供給と品質の改善を運用として回します。
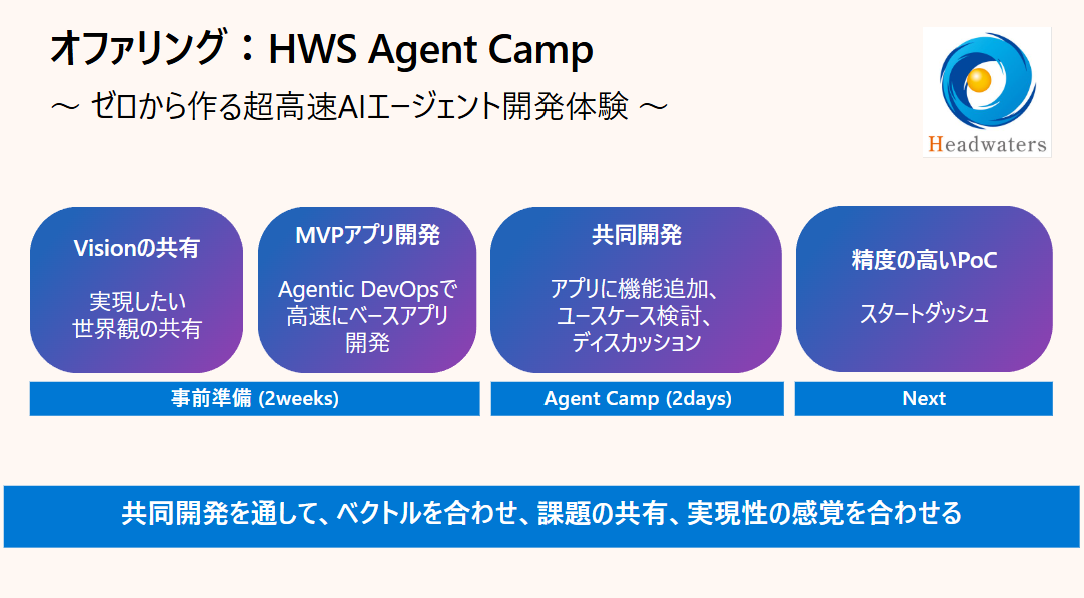
AI活用から始める場合整えたデータを使うAIエージェントは、HWS Agent Campの2日間の集中ハッカソンで試作できます。

16/関連ソリューション

Microsoft Fabricソリューション

AI Readyな、 全社データ基盤をつくる。

Microsoft Fabricソリューション. Fabricの導入伴走支援と、Fabric×AI開発を行います。

AI Platform on Microsoft Azure Specialization更新

AIの実装からガバナンスまで、 第三者審査で確認。

AI Platform on Microsoft Azure Specialization更新. Purviewを含むセキュリティとガバナンスへ対応領域を広げています。

コンテキストエンジニアリング

業務の文脈を、 AIエージェントに供給する。

コンテキストエンジニアリング. 企業データ、業務ルール、判断基準、権限を設計し、AIエージェントへ継続的に供給します。

SyncLect Silver Data Coordinator

業務ファイルを、 AI-Readyなデータに整える。

SyncLect Silver Data Coordinator. 業務ファイルをSilverデータ化し、出所と権限を保ったままAIに渡せる形にします。

SyncLect Data Intelligence

業務の意味と関係を、 統合する。

SyncLect Data Intelligence. 暗黙知や業務データを、概念・⁠関係・⁠ルールへ統合します。

DataPark

企業データを、 プロダクトとして提供する。

DataPark. 企業のデータをData as Productとして活用するサービスです。

Microsoft Agent 365

AIエージェントを、 登録・ID・権限で統制する。

Microsoft Agent 365. 組織内のAIエージェントを可視化し、ID・権限・⁠データ保護・⁠監査を一元的に統制します。

Microsoft Entra ID統合開発

人とエージェントのIDを、 ゼロトラストで守る。

Microsoft Entra ID統合開発. ユーザーとAIエージェントの認証・⁠認可を設計します。

Microsoft Foundry(Azure AI Foundry)エージェント

Azure上のエージェント基盤で、 データを業務に生かす。

Microsoft Foundry(Azure AI Foundry)エージェント. モデルの選定・⁠評価・⁠デプロイと、エージェントの運用を支援します。

Agentic Security

AIエージェントの セキュリティを設計する。

Agentic Security. AIエージェントの利用に伴うリスクへの対策を支援します。

X-Tech FDE(フォワードデプロイエンジニアリング)

対象業務と責任分界を、 先に設計する。

X-Tech FDE(フォワードデプロイエンジニアリング). 対象業務、企業データ、権限、例外、品質要件、導入・⁠定着を現場で設計します。

HWS Agent Camp

最初の1業務を、 2日間で試作する。

HWS Agent Camp. 専門エンジニアが伴走する2日間の集中ハッカソンで、AIエージェントのプロトタイプを構築します。

17/よくあるご質問

Q. Microsoft Purviewとは何ですか。A. 社内外に散らばるデータを見つけ、分類し、保護し、正しく使わせるためのMicrosoftの統合ソリューションです。Data Security、Data Governance、Data Complianceの3領域の機能があります。詳しくはMicrosoft Learnをご覧ください。
Q. ヘッドウォータースは何を担いますか。A. Purview自体の提供元はMicrosoft社で、当社は設計・⁠実装・⁠運用・⁠定着を担います。ガバナンス構想、ロール設計、カタログと品質の整備、情報保護の設計、FabricやAIエージェントとの連携までを支援します。
Q. セキュリティ製品の導入支援だけですか。A. いいえ。秘密度ラベルやDLPによる情報保護に加え、データカタログ、データ品質、データ製品、アクセス申請・⁠承認の仕組みなど、データガバナンス全体を対象にしています。
Q. Microsoft Fabricを使っていなくても相談できますか。A. はい。Azure、Microsoft 365、オンプレミスのデータソースも対象にできます。Fabricの導入を検討中の場合は、Microsoft Fabricの基盤設計とあわせてご相談いただけます。
Q. AIエージェントとどう関係しますか。A. Purviewで分類・⁠統制したデータを、Microsoft FoundryやCopilot StudioのAIエージェントに渡します。AIに見せてよいデータの範囲と根拠を、データの側から説明できるようになります。エージェント自体の統制はAgent 365で扱います。
Q. 全社のデータを一度に対象にする必要がありますか。A. いいえ。1つの業務領域(パイロットドメイン)で運用を検証し、ロードマップを作ってから全社へ広げることをおすすめします。
Q. Purviewの費用はどう考えればよいですか。A. 機能によってライセンスに含まれるものと、スキャン量などに応じた従量課金があります。対象のデータソースとスキャン頻度を決める段階で、費用の見通しをあわせて設計します。
Q. どこから相談すればよいですか。A. データガバナンス、情報保護、AI活用のどの入口からでも相談できます。対象のデータと業務を1つ選び、現状を整理するところから始めます。

Microsoft Purviewソリューションのご相談

データガバナンス、情報保護、AI活用のどの入口からでも、現状の整理からご相談いただけます。