01/概要
グラフエンジニアリングとは:知識・業務・データの関係構造の設計・構築・点検
グラフエンジニアリングは、業務の概念、文書、データ、人や組織のあいだにある関係を、ノード(実体)とエッジ(関係)からなるグラフ構造として設計・構築し、AIが検索・判断・実行に使える状態に保つための技術領域です。当社は、ナレッジグラフ(知識グラフ)の構築、オントロジーによる型と関係の定義、グラフデータベース(グラフDB)への実装、GraphRAGによる検索、グラフの品質点検までをまとめて、グラフエンジニアリングと呼んでいます。
ベクトル検索を使う一般的なRAG(検索拡張生成)は、質問に意味の近い文書の断片を探します。一方で、「この帳票を作る部署と、受け取る部署はどこか」「この仕様の変更は、どの設計に影響するか」のように、複数の資料をまたいで関係をたどる質問には弱い面があります。グラフは、エンティティどうしの関係を明示的に持つため、関係をたどるマルチホップの検索と、回答の根拠となる元資料の追跡を補えます。
グラフエンジニアリングの要点
対象
業務の概念、文書、データ、人・組織のあいだの関係
基本の構造
ノード(実体)とエッジ(関係)。RDFではトリプルで表す
主な技術
ナレッジグラフ、オントロジー、グラフDB、GraphRAG
記述・問い合わせ
RDF、OWL、SPARQL、プロパティグラフ、Cypher、GQL
得られること
関係をたどる検索、根拠の追跡、不足・矛盾の検出
関連する考え方
コンテキストエンジニアリング、Agentic Workflow
コンテキストエンジニアリング・オントロジー・GraphRAG・Agentic Workflowとの関係
用語
主に扱うもの
グラフエンジニアリングとの関係
コンテキストエンジニアリング
AIへ渡す情報環境全体の設計・供給・統制
オントロジー
業務の概念・属性・関係・ルールの定義(スキーマ)
ナレッジグラフ
個々の実体と、実体どうしの関係のデータ
グラフエンジニアリングで構築・点検・更新する主な対象
GraphRAG
グラフを検索と回答の生成に使うアプローチ
構築した関係構造を、根拠付きの検索と回答に使う側の技術
Agentic Workflow
知識とツールを使って業務を進める実行側
グラフが表す業務の前後関係や担当を、エージェントの判断と手順に使う
02/注目される背景
AIエージェントの業務適用と、データモデル・グラフ標準・GraphRAGの整備
生成AIの活用が、質問に答えるアシスタントから、業務の手順を進めるAIエージェントへ広がっています。エージェントが業務を任されるほど、文書の断片を探すだけでなく、業務・帳票・担当・規程の関係を理解したうえで判断する必要が出てきます。
→
資料をまたぐ質問:1つの文書に答えがなく、複数の資料の関係をたどらないと答えられない
→
全体を問う質問:「主なテーマは何か」のように、文書群全体の理解を要する質問に、断片の検索では答えにくい
→
表記の揺れと別名:同じ帳票や設備が、部署や資料ごとに別の名前で書かれている
→
根拠の追跡:AIの回答が、どの資料のどの記載に基づくかを示す必要がある
→
業務の前後関係:エージェントが手順を進めるには、作業の順序、担当、入出力の関係が要る
→
知識の更新:規程や仕様が変わったとき、影響する範囲を特定して反映する必要がある
公的機関・標準化団体・プラットフォームでの位置づけ
データの意味と関係を共通の形で表す取り組みは、行政のデータ連携、国際標準、AIプラットフォームの各分野で進んでいます。
発行主体
記載内容
出典
デジタル庁
政府相互運用性フレームワーク(GIF)を、データの相互運用性を確保し、効率的な情報共有と情報連携を実現するためのデータモデルやルールのひな形と位置づけています。コア語彙、人・法人・施設などのコアデータモデルを、部分利用や拡張ができる参照モデルとして提供しています。
ISO/IEC
2024年4月に、プロパティグラフの構造を定義・変更するデータ管理言語の構文と意味を定めた国際規格 GQL を発行しました。異なる実装のあいだで、グラフのデータ定義と操作を移植できるようにすることを目的としています。
W3C
データの関係を記述する標準としてRDFを、概念と関係の定義を記述する言語としてOWLを定めています。オントロジーとナレッジグラフの記述形式として、各種の製品で採用されています。
Microsoft Research
2024年2月にGraphRAGを発表し、LLMが生成したナレッジグラフを使うことで、複雑な情報を扱う文書分析の質問応答が大きく改善すると報告しました。同年7月にGitHubで公開し、現在はMicrosoft Discoveryからも利用できます。
Microsoft Learn
Microsoft Fabric IQのオントロジーを、組織にとって重要な概念とその関係・ルール・指標を定義し、人、アプリケーション、AIエージェントが同じ語彙と文脈を使えるようにするものと説明しています。
03/構成要素
ナレッジグラフの6要素:スキーマ、エンティティ、リレーション、出典、名寄せ、版と権限
AIが業務で使うグラフには、実体と関係のデータに加えて、その情報がどこから来たか、どの版が有効か、誰が参照できるかを持たせます。
要素 1
スキーマ(オントロジー)
業務・帳票・担当・判断軸・規程など、グラフに置く実体の種類と、関係の種類を定義します。
要素 2
エンティティ(ノード)
個々の業務、帳票、部署、設備、仕様の項目など、グラフ上の実体です。属性を持たせます。
要素 3
リレーション(エッジ)
「作る・使う・前後・同じもの」「影響する」「準拠する」など、実体どうしの関係です。
要素 4
出典(エビデンス)
ノードとエッジごとに、抽出元の資料と記載箇所を持たせ、回答の根拠として追跡できるようにします。
要素 5
名寄せ・別名
表記の揺れや別名を正規化し、同じ実体を1つのノードにまとめます(エンティティ解決)。
要素 6
版と権限
どの版の知識が有効か、誰が参照・更新できるかを管理し、元データの権限を引き継ぎます。
グラフの表し方には、主語・述語・目的語のトリプルで記述するRDFと、ノードとエッジに属性を持たせるプロパティグラフ(Property Graph)があります。RDFはSPARQL、プロパティグラフはCypherやGQLで問い合わせます。推論や外部の語彙との連携を重視するか、関係の探索や属性の扱いやすさを重視するかで選びます。
技術解説:Property GraphとRDFの違いと選択方法(Zenn)
04/設計の進め方
グラフ構築の5工程:問いの設定から、抽出・点検・接続・更新まで
すべての資料を一度にグラフ化するより、AIに答えさせたい問いと任せたい判断を決め、その判断に必要な関係から作ると、早く検証できます。
工程
内容
主な成果
工程 1 問いを決める
AIに答えさせたい問いと任せたい判断を決め、必要な資料と関係の範囲を絞ります。
対象業務、問いの一覧
工程 2 スキーマを設計する
実体と関係の種類を定義します。RDFかプロパティグラフか、格納先のグラフDBやデータ基盤も決めます。
オントロジー、格納方式
工程 3 抽出して統合する
業務資料・設計書・会議・表から、エンティティと関係を抽出し、名寄せして統合します。
初版のナレッジグラフ
工程 4 点検して補う
表記揺れ、つながりのない帳票、弱い出典、資料間の矛盾を検出し、業務担当者への追加の確認で補います。
点検結果、補正済みのグラフ
工程 5 接続して更新する
検索とAIエージェントに接続し、想定する問いへの回答で検証します。資料の変更を反映する更新の流れも作ります。
検索・エージェント、更新手順
05/当社の支援内容
業務オントロジー設計、知識抽出、グラフDB接続、根拠付き検索、品質点検、ワークフロー設計
当社は、グラフデータベースの導入にとどまらず、業務資料・設計書・会議から関係を構造化し、不足と矛盾を点検して人が補い、根拠付きの検索とAIエージェントの実行に戻すまでを支援します。顧客の現場に入り、業務担当者とエンジニアが共同で検証するX-Tech FDE(フォワードデプロイエンジニアリング)で進めます。
01
業務資料・設計書・会議
規程、マニュアル、仕様書、設計表、会議の記録を集めます。
02
意味と関係の構造化
実体と関係を抽出し、オントロジーに沿ってグラフにします。
03
不足・矛盾の点検と補完
グラフの穴と食い違いを見つけ、人が確認して補います。
04
根拠付きの検索
関係をたどって対象を絞り、元資料を示して回答します。
05
エージェントへの接続
業務の前後関係と担当を、エージェントの判断と手順に使います。
06
更新
資料と業務の変更を、版を管理しながらグラフへ反映します。
支援 1
業務オントロジーの設計
業務・帳票・担当・判断軸・規程の種類と、「作る・使う・前後・同じもの」などの関係を定義します。現行業務(As-Is)の資料から、機械が読めるグラフへ変換します。
支援 2
非構造化文書からの知識抽出
設計書などの文書から、リスクや条件に関わる関係をトリプルとして抽出し、RDF化から検索までをデータ基盤上のパイプラインとして構築します。
支援 3
グラフDBと専門エージェントの接続
仕様書や設計表のように項目どうしの対応が多い資料をグラフDBへ取り込み、専門的な質問に答えるAIエージェントと接続します。
支援 4
関係をたどる検索と根拠の提示
別名を正規化し、グラフを1〜2ホップたどって対象を絞り込みます。そのうえで元の資料を確認し、根拠を付けて回答します。
支援 5
グラフの品質点検と人による補正
表記揺れ、作成元・受取先のない帳票、弱い出典、資料間の矛盾を検出し、その結果を業務担当者への追加ヒアリングにつなげます。
支援 6
業務プロセスのグラフからのワークフロー設計
業務プロセスをナレッジグラフにし、作業の順序・担当・入出力の関係をもとに、複数のAIエージェントが業務を進めるワークフローの設計とシミュレーションに使います。
06/取り組み
GraphRAGの研究発表、保険の引受け査定エージェント、業務の意味モデル抽出
関係構造を、翻訳の一貫性、複雑な査定ケースへの対応、会議からの業務知識の整理と、異なる目的に使っています。
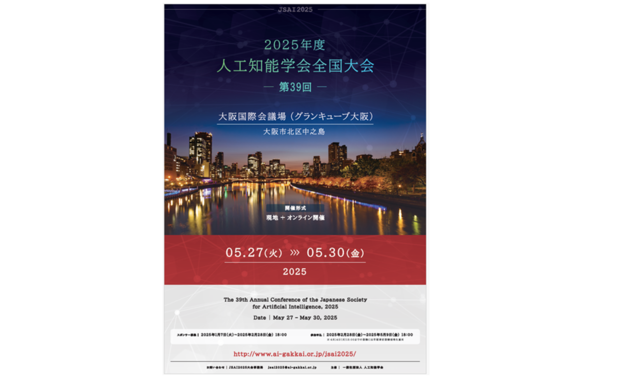 研究発表
人工知能学会全国大会:LLMとGraphRAGを用いたシナリオ自動翻訳
2025年度人工知能学会全国大会(第39回)のオーガナイズドセッションで、DATA IMPACTとともに研究成果を発表しました。ゲームの海外展開を題材に、キャラクターの個性や世界観を保つ多言語翻訳アルゴリズムを提案し、評価しています。
グラフの役割 登場人物や設定の関係をグラフで持ち、翻訳の一貫性を保つために使います。
お知らせ →
 保険
AI Agent Pitch Day for Insurance:生命保険の引受け査定エージェント
日本マイクロソフト主催のイベントで、引受け査定業務に対応したAIエージェントを紹介しました。Azure OpenAI ServiceとAzure AI Document Intelligenceによる帳票解析、GraphRAGとマルチエージェントによる複雑なケースへの対応、査定ログによるルール改善を組み合わせています。
グラフの役割 複雑なケースの分岐処理に、GraphRAGを使っています。
プレスリリース →
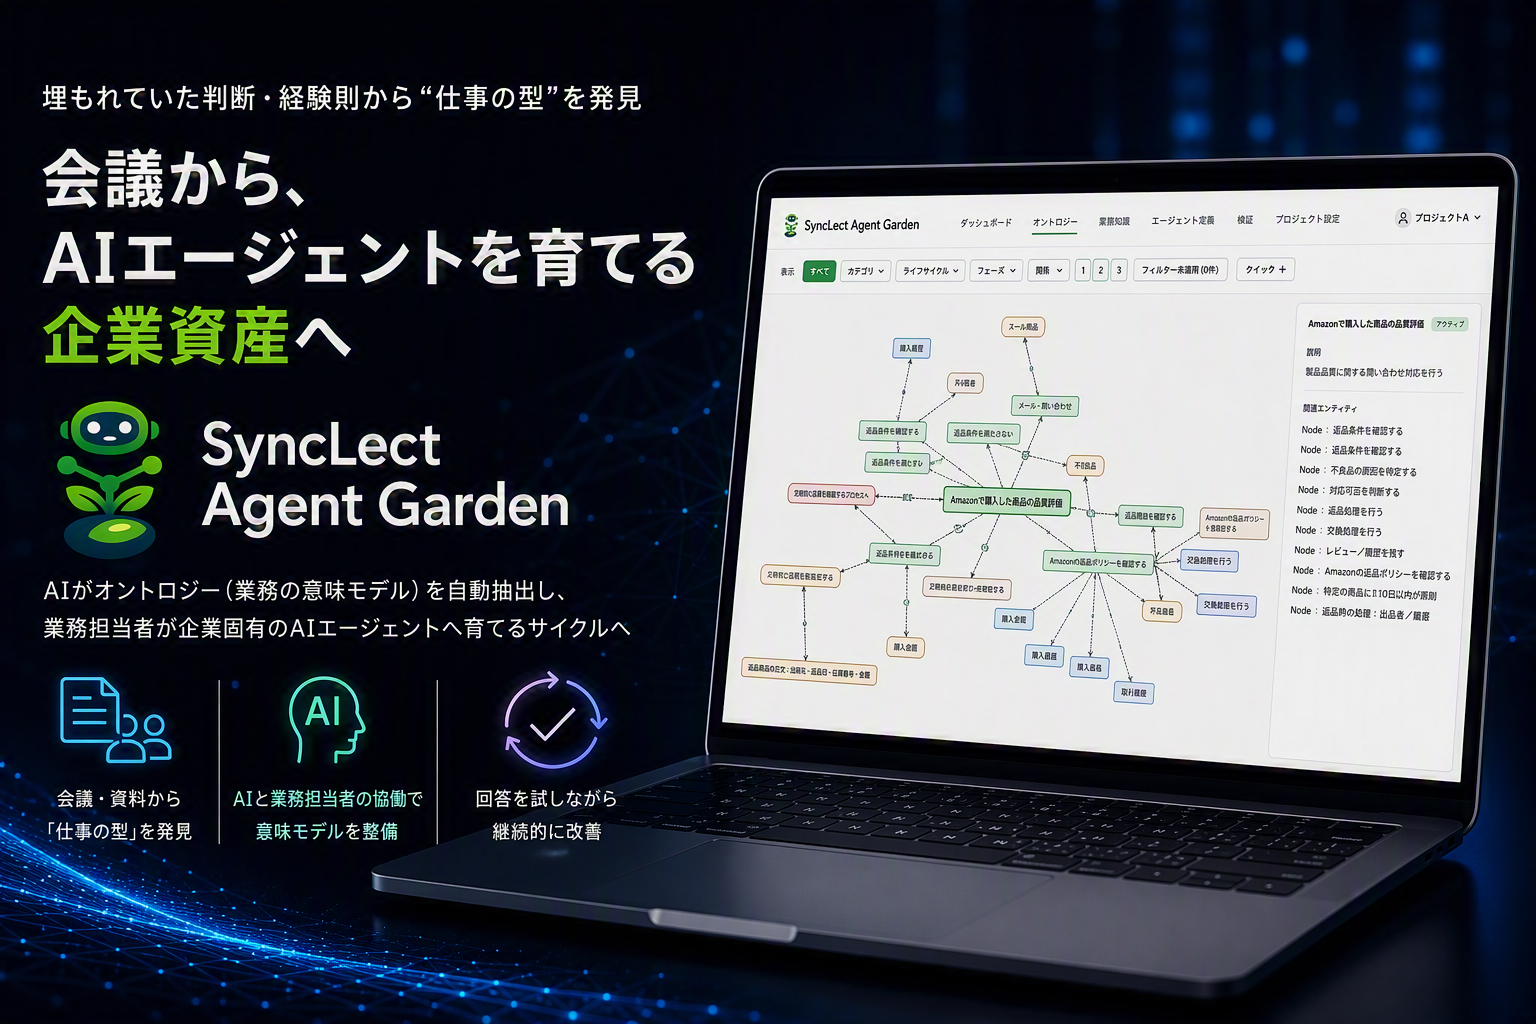 業務の意味モデル
SyncLect Agent Garden:会議と資料から業務知識を抽出
SyncLect Agent Gardenは、Teams会議や業務資料から、判断・経験則・手順・例外対応を抽出し、人・業務・データ・ルールの関係を示すオントロジーの候補として整理します。業務担当者が選択・補完・検証し、AIエージェントの定義まで生成します。
グラフの役割 業務の関係構造(意味モデル)を抽出し、人が確かめて育てる入口になります。
お知らせ →
技術解説:Microsoft GraphRAGのグローバル検索/ローカル検索を試す(Zenn)、アサイン支援エージェント:ナレッジグラフで人材アサインの暗黙知を形式化する(Zenn)
07/特長
作って終わりにしない知識グラフ:当社の4つの特長
特長 1/4
グラフの不足と矛盾を見つけ、人が補う工程まで設計
抽出したグラフをそのまま使わず、表記揺れ、つながりのない帳票、弱い出典、資料間の矛盾を検出します。検出結果を業務担当者への追加の確認につなげ、補正した結果を検索と業務実行に戻します。
特長 2/4
検索の高度化から、エージェントの業務実行まで接続
GraphRAGによる根拠付きの検索に加え、業務の前後関係や担当をグラフから読み取り、Agentic Work Flowの設計に使います。検索とエージェントで、同じ関係構造を使い回せます。
特長 3/4
RDF・プロパティグラフ・データ基盤を、目的で選ぶ
推論と語彙の連携にはRDF、関係の探索にはプロパティグラフ、既存の分析基盤との統合にはMicrosoft Fabric(Fabric IQ)やDatabricksと、目的に合わせて格納先を選びます。
特長 4/4
研究発表と技術検証に基づく実装
人工知能学会全国大会でGraphRAGを用いた研究を発表しているほか、GraphRAGの検索方式、ナレッジグラフの設計、Fabric IQ上のナレッジグラフを使うエージェントの検証を、技術ブログで公開しています。
08/顧客価値
課題から価値へ:関係構造が解決する検索・判断・知識管理の課題と、役割別の価値
課題
価値につながる仕組み
得られる価値
RAGが、資料をまたぐ質問に答えられない
関係をたどって対象を絞り込み、関連する資料をまとめて参照する
複数資料にまたがる質問への回答
同じものが別の名前で書かれ、検索で漏れる
別名を正規化し、同じ実体を1つのノードにまとめる
表記揺れに左右されない検索
回答の根拠を示せず、確認に時間がかかる
ノードとエッジに出典を持たせ、元資料の記載箇所を示す
根拠を確かめられる回答
業務資料の抜けや食い違いに気づけない
つながりのない帳票、弱い出典、矛盾を自動で検出する
業務知識の不足の可視化と補完
仕様や規程の変更の影響範囲が分からない
影響・準拠の関係をたどり、関連する設計や業務を洗い出す
変更の影響範囲の特定
役割別の価値
経営・事業責任者
AIに任せられる業務の範囲を広げる
文書検索では答えられなかった、資料をまたぐ判断をAIが支援できるようになり、適用できる業務の範囲が広がります。
業務部門
調べる時間を減らし、根拠を確かめて判断する
関連する資料と記載箇所が示され、複数の資料を突き合わせる時間が減ります。不足していた知識は、確認に答えるだけで補えます。
IT・データ基盤
既存の基盤の上に、関係の層を重ねる
Microsoft Fabric、Databricks、既存のRAGを活かしたまま、関係構造を追加できます。グラフDBは、目的に合う場合に絞って使います。
品質・監査・リスク管理
回答の出典と知識の版を追跡する
どの資料のどの記載に基づく回答か、どの版の知識が使われたかを、後から確認できます。
09/想定ROI
業務別の削減工数の試算:資料横断の調査、業務の関係整理、不整合の確認、回答の修正
現行の件数と所要時間を置き、関係をたどる検索と根拠の提示、抽出と点検の自動化で削減できる工数を試算します。
対象業務
試算の前提
削減工数
資料をまたぐ調査
月200件、仕様書・設計書を突き合わせて1件60分(約200時間)。関係をたどる検索と根拠の提示で、1件20分に短縮
月 約133時間
業務の関係整理(As-Is)
対象10業務、資料の読み込みと関係の整理に1業務40時間(400時間)。抽出結果の確認・補正に切り替え、1業務16時間に短縮
約240時間
資料間の不整合の確認
規程・マニュアル・帳票の食い違いの確認に月30時間。自動検出の結果の確認に絞り、月10時間に短縮
月 約20時間
AIの回答の修正
月300件の回答のうち、関係の誤りで修正が必要な40件、1件30分(20時間)。根拠の提示で、修正件数を半分、1件15分に
月 約15時間
件数と所要時間は、試算のための仮の値です。
実際の削減幅は、資料の量と品質、関係の複雑さ、点検で見つかる不足の量で決まります。当社は、スタートプランで代表的な1業務の調査時間と回答の修正件数を実測し、グラフ化する範囲を決めたうえで適用を広げます。
10/活用シーン
製造・通信インフラ・金融・保険・社内業務・コンテンツ制作での活用イメージと適性
01
製造:設計書・仕様書の影響範囲の調査
設計書から部品・条件・リスクの関係を抽出し、仕様の変更がどの設計や工程に影響するかをたどります。
02
通信・インフラ:設計表・仕様に基づく専門的な質問
項目の割り当て表やネットワーク設計の仕様をグラフにし、項目どうしの対応を問う専門的な質問に答えます。
03
金融:業務プロセスと規程の対応
業務の手順、帳票、担当、規程の関係をグラフにし、手続きの確認やエージェントの業務設計に使います。
04
保険:引受け査定・支払査定の複雑なケース
告知内容、規程、過去の判断の関係をたどり、複雑なケースの判断材料を根拠付きで整理します。
05
社内業務:人材アサイン・ナレッジ検索
経歴、スキル、案件、稼働の関係をグラフにし、候補の比較や推薦の理由を示します。
06
コンテンツ制作:翻訳・ローカライズの一貫性
登場人物、設定、用語の関係を持たせ、多言語への翻訳で表現の一貫性を保ちます。
グラフエンジニアリングの適性チェック
適合する顧客
- RAGを導入したが、資料をまたぐ質問に答えられない
- 設計書・仕様書・規程が多く、相互の参照関係が複雑
- 同じものの呼び方が、部署や資料ごとに異なる
- 回答の根拠を、元資料まで示す必要がある
- 業務知識を確認・補正できる担当者を置ける
適合しにくい顧客
- 定型のFAQ検索で十分に足りている
- 対象の資料が少なく、関係が単純である
- AIに答えさせたい問いが、まだ決まっていない
- グラフDB製品の導入だけで済ませたい
導入検討のDiscovery質問
→
AIに答えさせたい問いのうち、現在のRAGで答えられないものは何ですか。
→
その問いに答えるには、どの資料とどの資料を突き合わせていますか。
→
同じものの呼び方が、部署や資料によって異なる例はありますか。
→
回答の根拠は、どの粒度(資料・ページ・記載箇所)で示す必要がありますか。
→
抽出した業務知識を確認・補正できる担当者を、どの範囲で置けますか。
→
Microsoft Fabric、Databricks、Azure AI Searchなど、利用中の基盤は何ですか。
11/他の手段との違い
ベクトル検索RAG・データカタログ・グラフDB製品・オントロジー設計との違いと使い分け
手段
主にできること
グラフエンジニアリングとの違い
ベクトル検索のRAG
質問に意味の近い文書の断片を探し、回答に使う
関係をたどる検索と全体を問う質問を補います。既存のRAGは置き換えず、ベクトル検索と組み合わせます。
用語集・データカタログ
用語とデータの定義・所在を揃える
概念どうしの関係と出典まで扱い、AIの検索と判断に使える形にします。既存のカタログは入力として活かします。
グラフDB製品の導入
グラフを格納し、問い合わせる基盤を用意する
何を、どの関係で、どの出典から入れるかの設計と、点検・更新の運用までを担います。
オントロジーの設計のみ
業務の概念と関係の定義をつくる
定義に沿って実データを抽出・統合し、検索とエージェントに接続して、回答で検証します。
専門家による手作業の整理
重要な業務の知識を、専門家が一件ずつまとめる
AIによる抽出と自動の点検で候補を作り、人は確認と補正に集中します。資料の変更にも追従しやすくなります。
12/ガバナンス
出典の追跡・承認・権限・版管理:知識グラフを業務で使うための統制設計
AIが抽出した関係には、誤りや古い情報も含まれます。グラフの中身を、誰が承認し、誰が参照でき、どの版が有効かを管理します。
統制 1
出典の追跡
ノードとエッジごとに抽出元の資料と記載箇所を残し、回答から元の記載へたどれるようにします。
統制 2
候補と承認済みの区別
AIが抽出した関係と、業務担当者が承認した関係を区別し、業務で使う範囲を決めます。
統制 4
版管理と更新
スキーマと知識の版を管理し、資料の改訂や廃止をグラフに反映します。
統制 6
評価と改善
想定する問いへの回答で精度を測り、関係の誤りや不足をAgentOpsの評価とあわせて改善します。
13/はじめ方
スタートプラン:HWS Agent Campで、1業務のナレッジグラフとエージェントを2日間で試作・検証
HWS Agent Campは、生成AIの活用・内製化を目指す企業向けに、専門エンジニアが伴走する2日間の集中ハッカソンです。通常3〜6ヶ月かかるAIエージェント開発を、約2週間の事前準備のうえで2日間に凝縮し、本格的なプロトタイプを構築します。対象業務の資料から関係を抽出し、関係をたどって根拠付きで答えるエージェントを試作して、グラフ化の効果を検証できます。
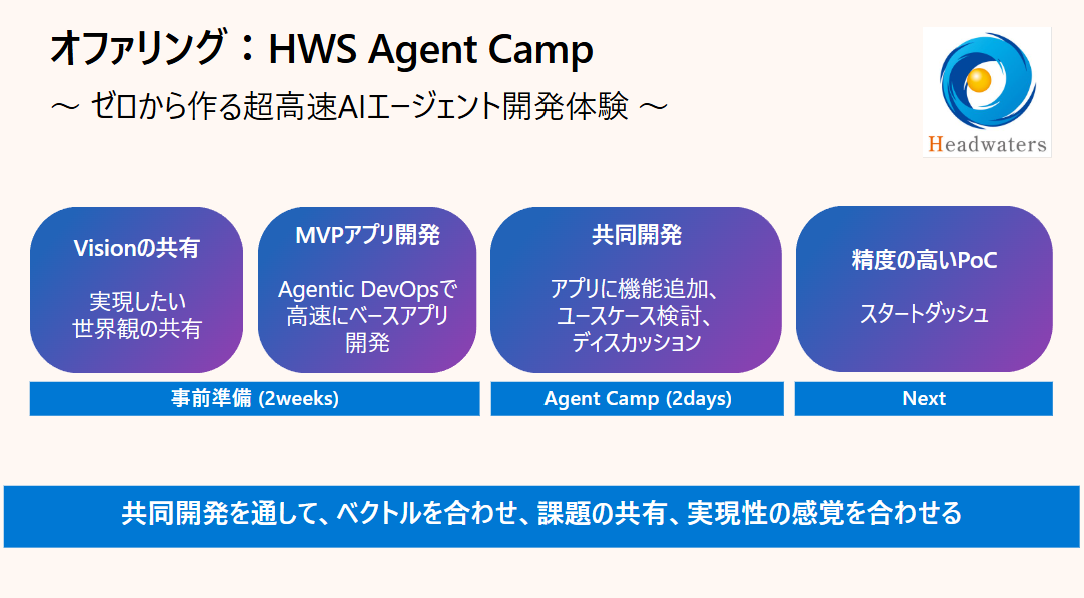
STEP 1事前準備(約2週間)対象業務、AIに答えさせたい問い、対象の資料と、資料どうしの関係を明確にします。
STEP 22日間の集中開発顧客側のエンジニア・業務担当者と専門家が共同で、関係の抽出、検索、エージェントを試作します。
STEP 3検証・事業化検討回答の正しさと調査時間を測り、グラフ化する範囲と本格導入のロードマップを策定します。
JRE MALL様(東日本旅客鉄道):ECモール運営の業務適用
ECモール運営の実業務を題材に、「データ取得→分析→提案」の流れをMicrosoft Foundry上でAIエージェントとして設計し、動作を検証しました。業務に組み込む際の設計観点、データ整備、構築・運用に必要な役割分担を整理しています。
事例を見る →リモートロボティクス様:音声でロボットを遠隔操作
Microsoft AI Co-Innovation Lab KOBEで、音声コマンドによるロボット・カメラの遠隔操作プロトタイプを開発しました。音声認識からFunction Callingによるデバイス制御までの流れを検証しています。
事例を見る →
14/当社について
Microsoft Azure の AI Platform/Agentic DevOps Specialization取得
ヘッドウォータースは「Microsoft Solutions Partner for Digital & App Innovation(Azure)」の認定に加え、上位資格である「AI Platform on Microsoft Azure」「Agentic DevOps with Microsoft Azure and GitHub」の2領域のSpecializationを取得しています。厳格な技術要件と導入実績を満たしたパートナーのみに付与される称号で、2領域の同時取得は国内でも限られています。
Microsoft AI Innovation Partner of the Year 2024 受賞
「AI イノベーション パートナー オブ ザ イヤー アワード」は、マイクロソフト製品の活用によってAI分野で革新を起こしたパートナーに贈られるアワードとして2024年に新設され、ヘッドウォータースは同分野において最も優れた実績をあげたとの評価を受け、初代受賞パートナーとなりました。
15/関連ソリューション
業務の概念と関係を、定義する
オントロジー構築・活用支援. 会話・文書・データから判断基準や例外を構造化し、AIエージェントが参照できる業務オントロジーを構築します。
AIに渡す文脈を、設計・供給・統制する
コンテキストエンジニアリング. AIに渡す動的な文脈の設計・供給・統制・改善を、支援領域ごとに提供します。

多段階の検索で、根拠付きで答える
Agentic RAG. 多段階検索と自律的推論を備え、業務に特化したエージェントが根拠付きで回答します。
Fabric IQで、データに業務の意味を
Microsoft Fabricソリューション. Microsoft Fabricの導入伴走から、Fabric IQによるオントロジーとData Agentの活用、ガバナンス設計までを支援します。
最初の1業務を2日間で試作
HWS Agent Camp. 専門エンジニアが伴走する2日間の集中ハッカソン。約2週間の事前準備のうえで、プロトタイプを構築します。
現場に入り込み、抽出設計から伴走する
X-Tech FDE. 業務ヒアリング、知識の抽出設計、AI Ready化のチューニング、本番実装に向けた基盤構築までを、現場に入り込んで支援します。
16/よくあるご質問
Q. グラフエンジニアリングとは何ですか。
A. 業務の概念、文書、データ、人や組織の関係を、ナレッジグラフとして設計・構築・点検し、AIが検索・判断・実行に使える状態に保つ技術領域です。オントロジーの設計、グラフDBへの実装、GraphRAGによる検索、品質の点検と更新を含みます。
Q. ナレッジグラフ(知識グラフ)とは何ですか。
A. 個々の実体(エンティティ)と、実体どうしの関係(リレーション)をネットワークとして表したデータです。オントロジーが型と関係の定義を与え、ナレッジグラフがその定義に沿った実データを持ちます。
Q. GraphRAGとは何ですか。通常のRAGと何が違いますか。
A. GraphRAGは、ナレッジグラフを検索と回答の生成に使うアプローチで、Microsoft Researchが発表した手法が知られています。ベクトル検索のRAGが意味の近い断片を探すのに対し、GraphRAGは関係をたどる質問や、文書群全体を問う質問を補えます。
Q. オントロジーとは、どう違いますか。
A. オントロジーは、概念と関係の種類を定める設計図(スキーマ)です。グラフエンジニアリングは、その設計図に沿って実データを抽出・統合し、点検し、検索とエージェントに接続するまでを扱います。オントロジーの設計はオントロジー構築・活用支援で詳しく説明しています。
Q. RDFとプロパティグラフは、どちらを使いますか。
A. 目的で選びます。外部の語彙との連携や推論を重視する場合はRDF(SPARQLで問い合わせ)、関係の探索や属性の扱いやすさを重視する場合はプロパティグラフ(CypherやGQLで問い合わせ)が向きます。既存のデータ基盤に合わせて、Microsoft FabricやDatabricksに格納する構成もあります。
Q. グラフデータベースの導入は必須ですか。
A. 必須ではありません。問いの種類とデータの量によっては、既存のデータ基盤や検索サービスの上に関係を持たせる構成で足ります。関係の探索が中心で量も多い場合に、グラフDBを使います。
Q. 既存のRAGは作り直す必要がありますか。
A. いいえ。ベクトル検索のRAGは残し、関係をたどる検索と根拠の提示を加えます。質問の種類に応じて、検索の方式を使い分けます。
Q. AIが抽出した関係が誤っていた場合は、どうなりますか。
A. 抽出した関係は候補として扱い、表記揺れや矛盾、弱い出典を自動で検出したうえで、業務担当者が確認・補正します。承認した関係だけを業務で使い、出典をたどって確認できるようにします。
Q. グラフを使えば、AIの回答精度は必ず上がりますか。
A. 一律には言えません。効果は、問いの種類、資料の品質、関係の複雑さで変わります。代表的な問いへの回答で、導入前後の正しさと調査時間を測って判断します。
Q. 社内の資料が古かったり、抜けがあったりしても始められますか。
A. 始められます。グラフにすると、作成元や受取先のない帳票、資料間の食い違いなど、資料の抜けが見えるようになります。その結果を追加のヒアリングにつなげ、業務知識を補います。
Q. 最初は何から始めればよいですか。
A. AIに答えさせたい問いを1つ決め、その問いに必要な資料と関係を整理するところから始めます。短期間で試作したい場合は、2日間のHWS Agent Campも利用できます。
グラフエンジニアリングに関するご相談
対象業務と問いの選定から、関係の抽出、品質点検、根拠付き検索、AIエージェントへの接続まで、貴社の状況に合わせてご提案します。
お問い合わせ