01/ループエンジニアリングとは
AIの成果物を検証し、失敗を仕様・ルール・コンテキストへ戻す開発方式
ループエンジニアリングは、AIが生成した成果物を、テスト・レビュー・評価・監視によって検証し、失敗から得た知見を仕様・ルール・コンテキストへ還元することで、AIと開発プロセスを継続的に改善するエンジニアリング方式です。
AIに何度もやり直させることとは異なります。不具合、誤回答、レビュー指摘、例外対応をその場で直して終わらせず、次の生成と判断に効く形で組織に残します。モデル以外の環境を設計するハーネスエンジニアリングの考え方を、改善の繰り返しとして運用するものです。以下は、関連する考え方を扱った外部の一次情報です。
ループに含まれるもの- 仕様・要件(AIが参照できる形)
- テスト・静的解析・脆弱性検査
- AIレビューと人の承認
- 評価データ(Evals)と採点
- 実行ログ・監視・停止の仕組み
- 失敗を次へ戻すフィードバック
用語整理AI SDLC・Agentic AI SDLC・ループエンジニアリングの関係
AI SDLCは、ソフトウェア開発の各工程にAIを組み込む枠組みです。Agentic AI SDLCは、各工程をAIエージェントが実行する形へ進めたものです。ループエンジニアリングは、その工程を回し続けて品質を高める、継続改善の仕組みを指します。
AI SDLC開発工程にAIを組み込む枠組み。要件・設計・実装・テストでAIを使います。
Agentic AI SDLC各工程をAIエージェントが実行する開発。コンテキスト設計、仕様駆動、評価、運用統制を含みます。
ループエンジニアリングAgentic AI SDLCを回し続ける継続改善の仕組み。検証結果と失敗を、仕様・知識・評価へ戻します。
02/注目される背景
ループエンジニアリングが注目される理由:AIの生成速度に、検証と知識更新が追いつかない問題
AIコーディングエージェントや業務エージェントは、成果物を短時間で大量に生成します。一方で、確認の方法、評価の基準、業務知識の更新が個人の経験に残ったままでは、生成の速さがそのまま手戻りと品質のばらつきになります。
→検証の遅れ:生成量に対して、レビューとテストが追いつかない
→失敗の使い捨て:不具合や誤回答がその場で直され、再発防止に使われない
→個人への依存:プロンプトや判断の経験が、担当者に閉じている
→知識の陳腐化:業務ルールや例外が変わっても、AIの参照情報が更新されない
→評価基準の不在:改善したのか悪化したのかを、数値で判断できない
→速度と統制の対立:高速化するほど、セキュリティと承認が後付けになる
生成して直すだけの運用- 同じ不具合とレビュー指摘が、別の画面や案件で繰り返される
- AIの回答品質が、業務の変化とともに落ちても気づけない
- 成功と失敗の判断が、担当者ごとに異なる
- 検証の結果が、次の仕様や指示書に反映されない
ループで検証と改善を回す運用- 失敗を仕様・テスト・ルール・業務知識へ戻し、再発を防ぐ
- 評価データとログで、品質の変化を継続的に測る
- 成功・失敗・判断結果が、組織の再利用できる資産になる
- テスト、セキュリティ、承認、監査ログを同じループに組み込む
03/構成要素
ループエンジニアリングの3つのループ:開発・業務知識・運用ガバナンス
3つのループは独立した取り組みではなく、現場から得た結果が次の開発と運用に戻るようにつなぎます。
ループ
回す流れ
つながっていないときに起きること
開発ループ
仕様→実装→テスト→レビュー→修正。不合格は修正へ戻し、承認済みの成果物とレビュー知見を次回の開発に再利用します。
仕様とコードが分断され、同じ不具合とレビュー指摘が繰り返される
業務知識ループ
現場知識→構造化→AI実装→利用ログ→知識更新。運用で見つかった新しい例外を、業務知識へ戻します。
業務の変化や新しい例外にAIが追従せず、回答や判断が古くなる
運用・ガバナンスループ
評価→監視→リスク確認→改善→再リリース。本番後の品質と統制を、継続的に点検します。
本番後の劣化や逸脱に気づけず、改善の責任と手順が曖昧になる
04/設計の進め方
ループの設計手順:検証の4層と、失敗を戻す6つの還元先
ループは、何で検証し、失敗をどこへ戻すかを先に決めて設計します。AIレビューと確定的な検査は分けて置き、判定の性質に応じて使い分けます。
検証の4層
LAYER 1確定的な検査テスト、静的解析、依存関係と脆弱性の検査、CI。合否が機械的に決まるものを担います。
LAYER 2AIレビュー設計意図、コードの妥当性、指摘の網羅。確定的な検査では拾えない観点を補います。
LAYER 3評価(Evals)評価データセットで、回答・判断・ツール実行を採点します。改善の前後を比較できます。
LAYER 4人の承認(HITL)重要な判断、リリース、標準ルールの変更。人が責任をもって承認する点を明示します。
失敗を戻す6つの還元先
失敗の原因を分類し、直す場所を決めて戻します。同じ失敗が別の案件で起きないようにするのが目的です。詳しい進め方は、SAIDDarやSyncLect Data Intelligence(SDI)の提供範囲として整理しています。
還元先 1仕様・要件曖昧だった条件を明文化し、AIが参照できる形で管理します。
還元先 2テスト・評価データ再現した失敗を、回帰テストと評価データへ追加します。
還元先 3ルール・指示書守るべき制約と判断基準を、AGENTS.mdなどの指示書へ反映します。
還元先 4コンテキスト・業務オントロジー業務の例外や判断基準を、業務知識として更新します。
還元先 5ツール・権限の設計不要な権限や操作を絞り、承認ゲートを追加します。
還元先 6プロンプト・モデル指示、モデル、パラメータを、評価結果にもとづいて見直します。
05/当社の支援内容
ループを支える7つの層と、各層を担う当社の資産
各層は単体でも導入できます。不足している層から重ねます。
層
担う内容
当社の資産
現場接続
現場から評価基準を取得し、AIの失敗を業務の文脈で判断し、新しい例外を見つけます。
業務理解
判断基準・例外・役割を構造化し、業務オントロジーとして更新します。
開発標準
提案・要件・設計・実装・レビュー・テスト・変更管理を標準化します。
開発基盤
テスト、静的解析、AIレビュー、承認履歴、CI/CDを同じ流れに載せます。
AI実装
エージェント、RAG、マルチエージェントを実装し、評価基盤に接続します。
運用統制
評価、監視、監査、人の承認を、本番運用の中に置きます。
継続進化
利用結果を仕様・知識・評価・共通部品へ戻し、次の業務や部門へ転用します。
上記の組み合わせ
支援メニュー:4つの入口
現在の状況に合わせて、いずれかの入口から始められます。
MENU 1ループ診断
現行のAI駆動開発やAIエージェント開発を診断します。仕様とコードの接続、自動評価の有無、AIレビューと確定的検査の分離、失敗の蓄積、承認点、運用ログの活用を確認します。
主な成果物 現状評価、改善ロードマップ、ループ設計図、品質ゲート一覧
MENU 2開発ループの構築
GitHubを中心に、開発・テスト・レビュー・修正のループを構築します。テスト自動生成、静的解析、AIコードレビュー、人の承認、段階リリースまでを一連の流れにします。
主な成果物 開発ワークフロー、品質ゲート、承認フロー
MENU 3エージェントの評価・改善ループ
評価データセットを整備し、回答・判断・ツール実行のログを集めます。失敗理由を分類し、プロンプト、コンテキスト、ツール、モデルを改善して再評価します。
主な成果物 評価設計、評価データ、リリース判定基準
MENU 4業務知識と運用の継続改善
現場の暗黙知を構造化し、運用中に見つかった例外を業務知識へ追加します。モニタリング、リスク確認、変更承認、再リリースまでを統制のもとで回します。
主な成果物 業務オントロジー、運用ルール、監視設計
06/特長
特長 1/4開発・業務知識・運用の3ループを、一つの流れでつなぐ設計
コードの品質改善だけにとどめず、業務知識の更新と本番運用の統制までを同じ改善サイクルに載せます。現場で見つかった例外が業務知識になり、仕様とテストに反映され、評価と監視を経て再リリースされます。
特長 2/4SDIが「掴み」、SAIDDarが「作る」役割分担
SDIが業務担当者との対話や既存資料から判断基準・例外処理・役割を抽出してAIが使える構造へ変換し、SAIDDarが提案から変更管理までの開発工程を標準化します。業務知識の側と開発の側を組み合わせることが、当社の差別化の核です。
特長 3/4GitHubを貫通基盤にした検証と修正のループ
設計書、コード、テストをGitHub上の一つの流れに載せ、Pull Request、Actions、GitHub Advanced Security、GitHub Copilotを接続します。コード構造と依存関係の解析、設計書・テストの生成、静的解析、AIレビュー、人の承認、段階リリースまでを、履歴を残しながら進めます。
特長 4/4FDEが現場の評価基準と例外をループに取り込む
FDEは開発要員ではなく、ループと現場をつなぐ役割です。現場から評価基準を取得し、AIの失敗を業務の文脈で判断し、新しい例外条件を見つけ、優先順位とROIを再設定します。改善の方法は顧客側へ移転し、内製化を支援します。
07/実装事例
GitHub連携のAI駆動開発と、ハーネス実装に見るループの適用
対象は異なっても、検証、人の判断点、品質ゲート、知見の還元という骨格は共通です。
CASE 1 2026年展開SAIDDar:AI駆動開発の標準化と知見の還元
提案・要件・設計・実装・レビュー・テスト・変更管理を標準化し、各工程をAIエージェントが実行するAIエンジニアリングOSです。GitHub Copilotとの連携で、個人依存の開発を組織標準へ進めます。
ループの要点 各案件の改善をテンプレートとエージェント定義へ戻すナレッジフライホイール。上流ドキュメントと顧客向け成果物は人がレビュー。
SAIDDarを見る → CASE 2 2026年9月提供開始SyncLect Agentic Migration Harness:HITL付きの移行ループ
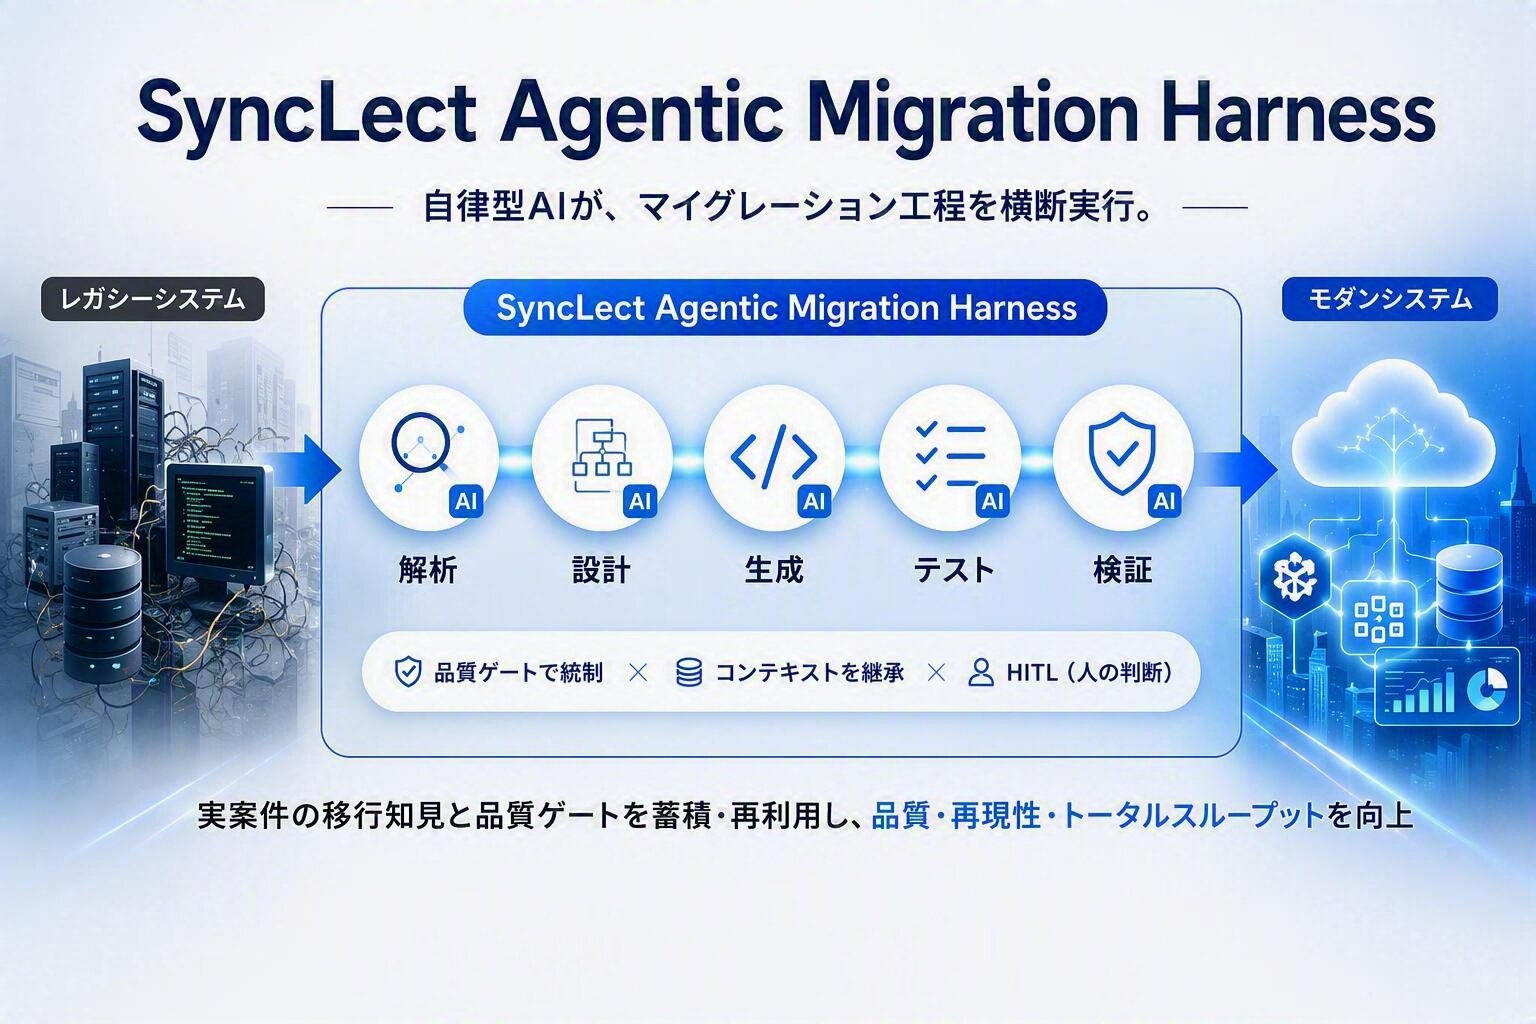
自律型AIが既存システムを解析し、設計案からコード・テスト生成までを工程横断で実行します。実案件で蓄積した変換ルール、レビュー観点、品質基準を組み込みました。
ループの要点 判断点にHITLの承認と品質ゲートを置き、実案件の知見を次の工程に戻す。
プレスリリースを見る → CASE 3 2026年7月発表Physical AI Harness:現場知を制約条件に変える安全実装基盤
AIの提案動作を、実行前に承認・ブロック・人への確認へ振り分け、判断ログを構造化して残します。現場の暗黙知はSDIで制約条件へ変換します。
ループの要点 止めた理由と判断ログを知識として蓄積し、次の制約条件に戻す。
発表原文を見る → GitHub連携のAI駆動開発で確認した、品質・工程速度の改善
複雑な画面のバグ数/画面約82%減少
5.56件 → 1.00件 特に複雑な画面のバグ数/画面0.00件
6.57件 → 0.00件 コードマージ平均期間約93%短縮
2.7日 → 0.2日 AIレビューの指摘数/画面約2倍に増加
3.67件 → 7.45件(検出の前倒し)
特定プロジェクトでの、ソリューション適用前後の自社比較結果です。すべてのプロジェクトに同様の効果を保証するものではなく、対象システムの規模・構成・既存資料・適用範囲によって異なります。
08/顧客価値
AIの失敗を使い捨てにしない:使うほど開発組織が賢くなる仕組み
ループエンジニアリングは、生成の速さを、品質と再利用できる知識に変えるための前提となる設計です。
変える対象
従来
導入後に起きる価値
失敗の扱い
不具合・誤回答・レビュー指摘を、その場で直して終わる
仕様・テスト・ルール・業務知識へ戻し、同じ失敗の再発を防ぐ
組織の知見
個人のプロンプトや経験に閉じている
成功・失敗・判断結果が、再利用できる組織の資産になる
速度と統制
高速化するほど、検査と承認が後付けになる
生成、テスト、セキュリティ、承認、監査ログが同じループの中にある
PoCから本番
PoCで得た知見が、次の業務に引き継がれない
共通部品、評価基準、業務オントロジーを次の業務・部門へ転用できる
品質の把握
改善したかどうかが、感覚で語られる
評価データとログで、品質の変化を数値で追える
経営・事業責任者AIの活用範囲と統制の考え方を示し、PoCから本番・横展開への判断材料にできる
AI・DX推進評価基準と改善サイクルを持ち、PoCで止まる原因を段階的に解消できる
開発・エンジニアレビュー指摘と不具合が仕様・テストに戻り、手戻りとレビュー負荷が減る
業務部門現場の判断基準や新しい例外が、AIの業務知識として更新され続ける
品質・監査テスト結果、承認履歴、判断ログを、監査と原因調査に使える
IT・情報セキュリティ検査と承認を開発の流れの内側に置き、後付けの確認に頼らずに済む
09/ユースケース・適性
AI駆動開発・業務エージェント・移行・運用で回すループ
検証できる対象と、改善の戻し先が決まっている領域から始めます。
01AI駆動開発
改善する対象 リポジトリ、PR、テスト、CI、設計書
利用イメージ テスト・静的解析・AIレビューの結果を修正に戻し、承認済みの成果物とレビュー知見を次回の開発へ再利用します。
02業務エージェント
改善する対象 回答、判断、ツール実行、業務ルール
利用イメージ 評価データでエージェントを採点し、失敗理由を分類して、プロンプト・コンテキスト・ツールを改善します。
03システム移行・モダナイズ
改善する対象 レガシーコード、設計書、変換ルール、品質ゲート
利用イメージ 案件で得た変換ルールとレビュー観点を、次の工程と次の案件へ戻します。
04業務知識の継続更新
改善する対象 判断基準、例外処理、役割分担、業務オントロジー
利用イメージ 運用中に見つかった例外を業務知識へ追加し、業務変更に合わせて更新します。
05全社のエージェント運用
改善する対象 複数部門のエージェント、権限、品質、稼働状況
利用イメージ 品質評価、リスク確認、変更承認、再リリースを共通の手順で回します。
06セキュリティ・品質の統制
改善する対象 脆弱性検査、依存関係、承認履歴、監査ログ
利用イメージ 確定的な検査とAIレビューを分けて開発の流れに置き、承認の履歴を残します。
ループエンジニアリング導入適性チェック
適合する顧客- AI生成コードを、組織の標準プロセスとして採用したい
- 同じ不具合やレビュー指摘が、繰り返し発生している
- PoCで動いたが、品質評価の基準がなく本番化できない
- 判断基準や業務ルールが、担当者の経験に残っている
- 業務の変化に合わせて、AIの参照知識を更新し続けたい
- 速度を落とさずに、セキュリティと承認を組み込みたい
適合しにくい顧客- 単発の生成だけが目的で、継続して改善する予定がない
- 個人利用のAIツールの設定調整が目的である
- ループにより、AIの誤りがゼロになることを求める
- 評価基準や承認の責任者を決められない
ループ設計のDiscovery質問
→仕様とコードは、AIが参照できる形でつながっていますか。
→自動テスト・評価データはありますか。AIレビューと確定的な検査は分かれていますか。
→不具合や誤回答は、仕様・テスト・ルールへ戻る仕組みがありますか。
→人が承認する点は、どこで、誰が決めていますか。
→業務の判断基準や例外は、文書化され、更新されていますか。
→運用ログは、次の仕様や評価の改善に使われていますか。
→AIエージェントの品質は、数値でどう測っていますか。
→現在利用している開発・AI基盤(GitHub、Foundry、Copilot Studioなど)は何ですか。
10/想定ROI
手戻り・再発対応・調査・知識更新の工数削減
ループの効果は、手戻りと再発対応にかかる工数の削減と、品質の向上に表れます。
指標
前提
導入前
導入後
削減
AI生成物のレビュー・手戻り
AI生成物200件/月。1件60分の修正対応を、事前テストとAIレビューにより30分へ
200時間/月
100時間/月
50%(−100時間)
同種不具合の再発対応
月8件、1件12時間。失敗を回帰テストとルールへ戻し、再発を月3件へ
96時間/月
36時間/月
約63%(−60時間)
エージェント誤回答の原因調査
月20件、1件3時間。評価データとログにより、1件1時間へ
60時間/月
20時間/月
約67%(−40時間)
業務ルール変更の反映
月10件、1件8時間。構造化した業務知識の更新により、1件3時間へ
80時間/月
30時間/月
約63%(−50時間)
代表的な開発・業務1〜2件で、現行の手戻り件数、レビュー工数、評価結果を測定し、試算を実測値に置き換えてご判断いただけます。
11/導入ステップ
ループ診断から、継続改善の定着までの5ステップ導入
現状の診断から始め、不足しているループから順に構築します。
STEP 1ループ診断仕様とコードの接続、自動評価、検証の層、失敗の蓄積、承認点、運用ログの活用を診断成果物:現状評価、ループ設計図
STEP 2検証基盤の整備テスト、静的解析、AIレビュー、評価データを整備し、品質ゲートを定義成果物:品質ゲート一覧、評価データ
STEP 3開発ループの構築仕様→実装→テスト→レビュー→修正を、GitHub上の一つの流れへ接続成果物:開発ワークフロー、承認フロー
STEP 4知識・評価ループの接続業務知識を構造化し、エージェントの評価と失敗分類を、改善へ接続成果物:業務オントロジー、評価設計
STEP 5運用と継続進化監視、リスク確認、変更承認、再リリースを回し、横展開を定着成果物:運用手順、改善レポート
12/他の手段との違い
プロンプト調整・AI開発ツール単体・評価ツール単体との違いと使い分け
GitHub、GitHub Copilot、Microsoft Foundry、Copilot Studioなどの基盤の上で、検証と改善の循環を設計・運用します。
他の手段
主にできること
ループエンジニアリングでの扱い
プロンプト・指示書の調整
個別のAIの振る舞いを、短期間で調整
調整の知見を、仕様・ルール・評価データへ戻し、共通資産にする
AIコーディングツール単体
コード生成と補完による開発の高速化
生成物の検証・レビュー・承認・知見の還元を、開発の流れに組み込む
評価・観測ツール単体
出力の採点と、稼働・品質・コストの観測
連携して使い、結果を仕様・知識・ルールへ戻す運用まで設計する
RAG・ナレッジ管理単体
情報の検索と、回答への根拠付け
運用で見つかった例外を業務知識として更新し続ける仕組みまで扱う
SIer・社内個別開発
要件への柔軟な適合
個別案件の知見を、標準・テンプレート・品質ゲートへ戻し、反復可能にする
13/ガバナンス
検査・承認・監査ログを、ループの内側に置く統制
実行環境は、顧客のネットワーク、認証、アクセス制御、データ管理方針に沿って構成します。
開発と運用の統制- 確定的な検査とAIレビューの役割分担と、人の承認点の明示
- テスト・静的解析・脆弱性検査の結果と、承認履歴の保存
- 本番ブランチへの直push禁止、必須レビュアーなどのブランチ保護
- 評価・監視による品質の継続的な点検と、再リリースの変更承認
- 標準ルール・テンプレートの変更は責任者が確認
機能の範囲についてループエンジニアリングは、AIの誤りをゼロにすることを保証するものではありません。検証と改善を継続して回し、品質の変化を捉えて、再発を抑える設計です。重要な判断と承認は、人の責任範囲として明示します。
14/当社について
Microsoft Azure の AI Platform/Agentic DevOps Specialization取得
ヘッドウォータースは「Microsoft Solutions Partner for Digital & App Innovation(Azure)」の認定に加え、上位資格である「AI Platform on Microsoft Azure」「Agentic DevOps with Microsoft Azure and GitHub」の2領域のSpecializationを取得しています。AI導入の企画・設計から開発、セキュリティ、ガバナンス、本番運用、導入後支援までを一貫した品質で提供する組織能力が、第三者審査で確認されています。
Microsoft AI Innovation Partner of the Year 2024 受賞
「AI イノベーション パートナー オブ ザ イヤー アワード」は、マイクロソフト製品の活用によってAI分野で革新を起こしたパートナーに贈られるアワードとして2024年に新設され、ヘッドウォータースは同分野において最も優れた実績をあげたとの評価を受け、初代受賞パートナーとなりました。
X-Tech FDEによる、現場起点のAI実装
顧客の現場で技術をビジネス価値へ変換し、ROI最大化と内製化を目指すフォワードデプロイ(FDE)で、課題仮説、設計、実装、運用まで伴走しています。
15/はじめ方
スタートプラン:HWS Agent Campで、最初の1業務を2日間で試作・検証
HWS Agent Campは、生成AIの活用・内製化を目指す企業向けに、専門エンジニアが伴走する2日間の集中ハッカソンです。通常3〜6ヶ月かかるAIエージェント開発を、約2週間の事前準備のうえで2日間に凝縮し、本格的なプロトタイプを構築します。ループエンジニアリングを始める最初の一歩として、対象業務1〜2件を題材に、エージェントの試作とあわせて、評価基準と検証の流れの設計を検証できます。
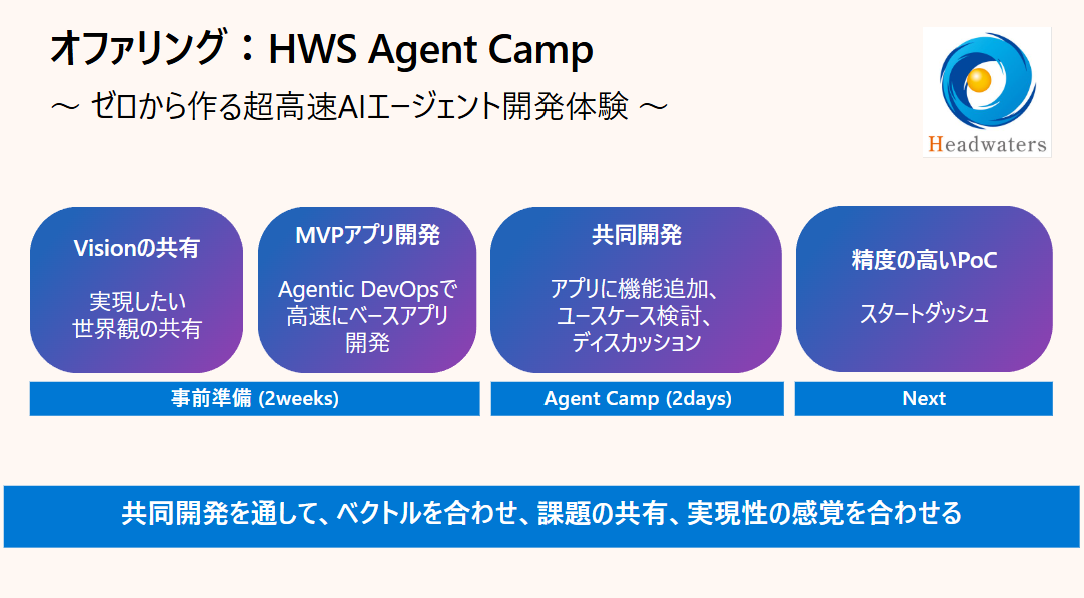
STEP 1事前準備(約2週間)対象業務、課題、必要なデータ・ツール・環境を明確にします。あわせて、品質をどう評価するか、失敗をどこへ戻すかを整理します。
STEP 22日間の集中開発顧客側のエンジニア・ビジネス担当者と専門家が共同で開発します。試作したエージェントに、評価データと検証の流れを組み込みます。
STEP 3検証・事業化検討プロトタイプを検証し、本格導入に向けたロードマップを策定します。ループを構築する順序と、必要な基盤を整理します。
JRE MALL様(東日本旅客鉄道):ECモール運営の業務適用
ECモール運営の実業務を題材に、「データ取得→分析→提案」の流れをMicrosoft Foundry上でAIエージェントとして設計し、動作を検証しました。業務に組み込む際の設計観点、データ整備、構築・運用に必要な役割分担を整理しています。
事例を見る →リモートロボティクス様:音声でロボットを遠隔操作
Microsoft AI Co-Innovation Lab KOBEで、音声コマンドによるロボット・カメラの遠隔操作プロトタイプを開発しました。音声認識からFunction Callingによるデバイス制御までの流れと、ロボティクス領域に求められる低遅延・高信頼のリアルタイム制御を検証しています。
事例を見る →16/関連ソリューション
AIの判断を、
物理世界へ安全につなぐ。
Physical AI Harness. AIの提案動作を実行前に承認・ブロック・人への確認へ振り分け、判断ログを残すフィジカルAIの安全実装基盤。独自方法論「SDI for AI Harness」を提唱しています。
AI駆動開発を、
組織標準にする。
AI駆動開発(SAIDDar). 案件の改善を標準・テンプレート・エージェント定義へ還元し、人のレビューと責任者の確認を前提に、AI駆動開発を組織標準へ進めます。
コンテキスト設計×現場実装を、
一気通貫で。
コンテキストエンジニアリング. ループの土台となる、動的文脈の設計・供給・統制・改善の提供体制。5つの支援領域と動的文脈インフラの方針を掲載しています。
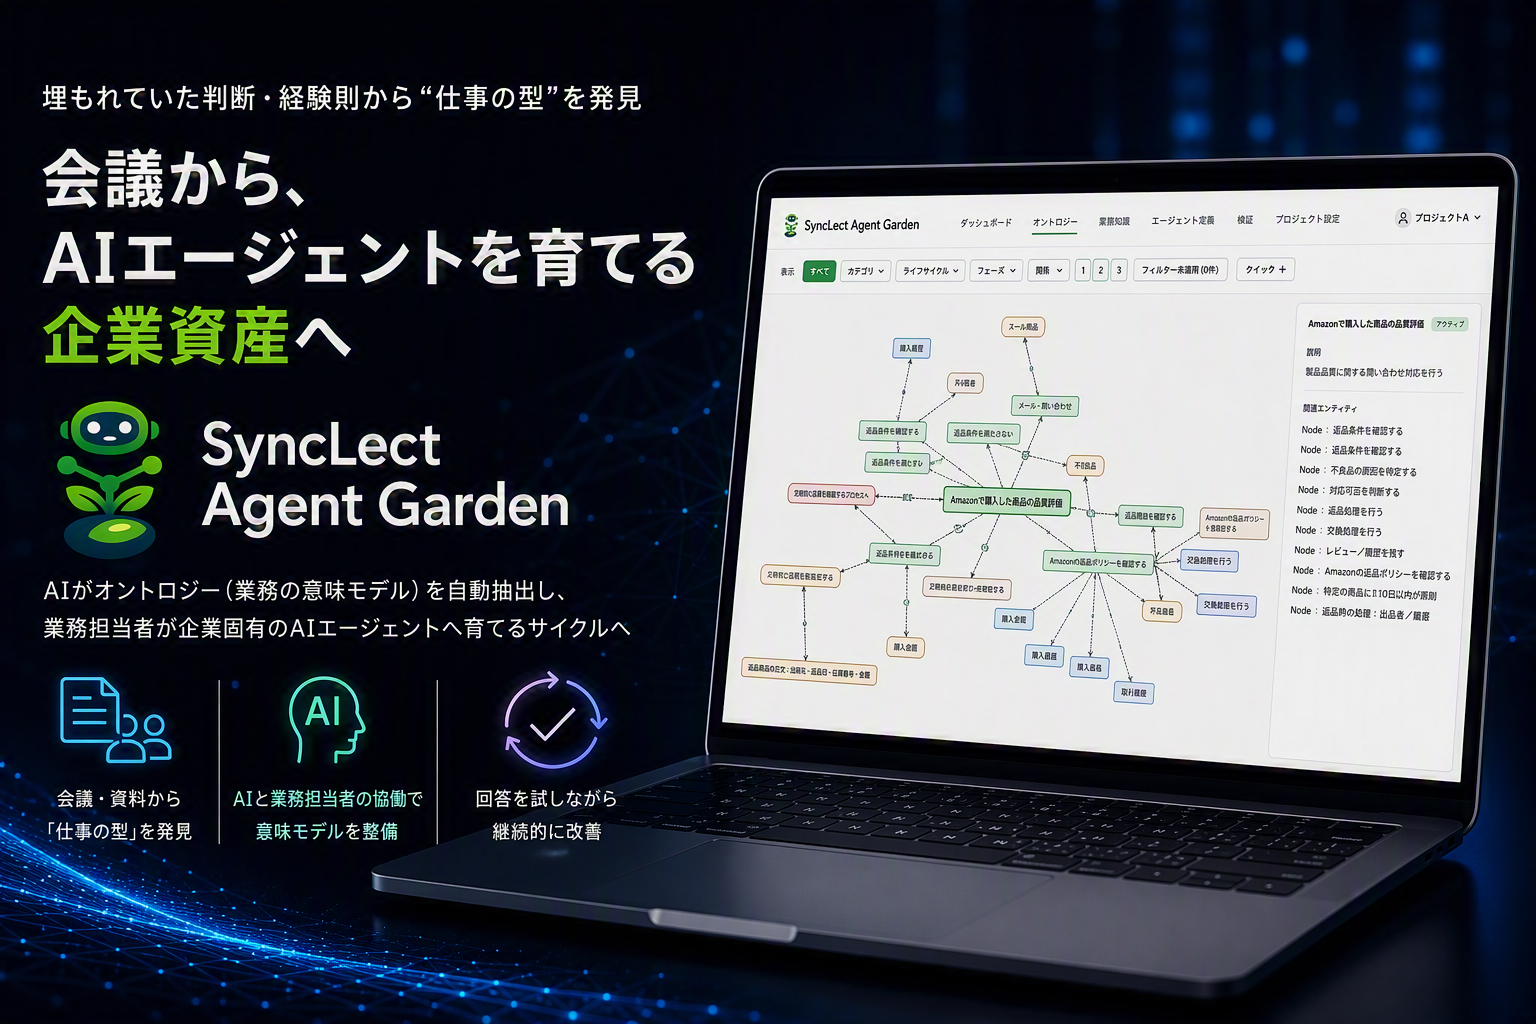
ファイルにない判断も、
会議から業務資産に。
SyncLect Agent Garden. Teams会議や業務資料の判断・経験則を抽出し、AIエージェント向けの仕事の型(Skill・Playbook)へ変換します。
最初の1業務を、
2日間で試作する。
HWS Agent Camp. 専門エンジニアが伴走する2日間の集中ハッカソン。約2週間の事前準備のうえで、AIエージェントの本格的なプロトタイプを構築します。
17/よくあるご質問
Q. ループエンジニアリングとは何ですか。A. AIが生成した成果物を、テスト・レビュー・評価・監視で検証し、失敗から得た知見を仕様・ルール・コンテキストへ還元して、AIと開発プロセスを継続的に改善する方式です。開発ループ、業務知識ループ、運用・ガバナンスループの3つをつなげて回します。
Q. 単に「AIにやり直させる」開発とは何が違いますか。A. やり直しは、その場の結果を直すだけです。ループエンジニアリングは、失敗の原因を分類し、仕様・テスト・ルール・業務知識・評価データへ戻して、次の生成と判断に効く形で残します。
Q. AI SDLC・Agentic AI SDLCとの関係を教えてください。A. AI SDLCは開発工程にAIを組み込む枠組み、Agentic AI SDLCは各工程をAIエージェントが実行する開発です。ループエンジニアリングは、それを回し続けて品質を高める継続改善の仕組みです。
Q. SAIDDarとの関係は何ですか。A. SAIDDarは、提案から変更管理までの開発工程を標準化する、ループを開発工程へ実装する中核の資産です。ループエンジニアリングは、SAIDDarに加えて、業務知識の更新や運用の統制までを対象にします。
Q. ハーネスエンジニアリングとの違いは何ですか。A. ハーネスエンジニアリングは、権限・承認・検証・停止といったAIの外側の環境を設計します。ループエンジニアリングは、その環境の中で得られた結果を、仕様・知識・評価へ戻して改善し続ける運用を指します。両者は併せて設計できます。
Q. 開発だけでなく、業務エージェントにも使えますか。A. 使えます。業務エージェントは、評価データで回答・判断・ツール実行を採点し、失敗理由を分類して、プロンプト、コンテキスト、ツール、モデルを改善します。現場の例外はSDIで業務知識へ追加します。
Q. 効果はどのくらいですか。A. 一律の削減率はお約束できません。一例として、特定のプロジェクトでGitHub連携のAI駆動開発を適用し、複雑な画面のバグ数が約82%減、コードマージ期間が約93%短縮された事例があります。導入時に現行の工数と品質を測定して検証します。
Q. AIの誤りはゼロになりますか。A. ゼロにはなりません。検証と改善を継続して回し、品質の変化を捉えて再発を抑える設計です。重要な判断と承認は、人の責任範囲として明示します。
Q. 最初は何から始めればよいですか。A. 対象の開発・業務を1〜2件選び、ループ診断(STEP 1)から始めます。短期間で試作して検証したい場合は、2日間のHWS Agent Campも利用できます。
ループエンジニアリングについてのご相談
現行のAI開発・エージェント運用の診断から、検証基盤、評価、継続改善の設計まで、貴社の状況に合わせてご提案します。
お問い合わせ